इस पोस्ट में, हम DBMS में सामान्यीकरण (Generalization) और विशेषीकरण (Specialization) के बीच अंतर को समझेंगे।
सामान्यीकरण (Generalization)
यह बॉटम-अप दृष्टिकोण (bottom-up approach) का उपयोग करके काम करता है।
स्कीमा का आकार कम हो जाता है।
यह आमतौर पर संस्थाओं (entities) के एक समूह पर लागू होता है।
सामान्यीकरण में विरासत (inheritance) का उपयोग नहीं किया जाता।
इसे एक प्रक्रिया के रूप में परिभाषित किया जा सकता है जहां कई एंटिटी सेट से समूह बनाए जाते हैं।
यह दो या अधिक निम्न-स्तरीय एंटिटी सेट का संघ (union) लेता है, और एक उच्च-स्तरीय एंटिटी सेट उत्पन्न करता है।
परिणामी उच्च-स्तरीय एंटिटी सेट में कुछ सामान्य विशेषताएं प्राप्त होती हैं।
यूनियन ऑपरेशन में होने वाली संस्थाओं के बीच अंतर और समानताओं को नजरअंदाज किया जाता है।
उदाहरण:
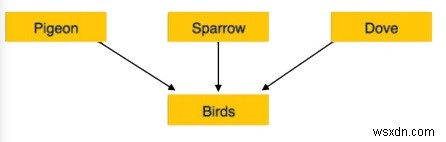
कबूतर, घरेलू गौरैया, कौवा और कबूतर सभी को पक्षी के रूप में सामान्यीकृत किया जा सकता है -
विशेषीकरण (Specialization)
यह टॉप-डाउन दृष्टिकोण (top-down approach) का उपयोग करता है।
स्कीमा का आकार बढ़ जाता है।
इसे एकल इकाई पर लागू किया जा सकता है।
इसे एक एंटिटी सेट के भीतर उपसमूहों के निर्माण की प्रक्रिया के रूप में परिभाषित किया जा सकता है।
यह सामान्यीकरण का उल्टा है।
यह उच्च स्तरीय इकाई का एक उपसमुच्चय लेता है, और निम्न-स्तरीय इकाई सेट बनाता है।
एक उच्च इकाई को एक या अधिक निम्न इकाई बनाने के लिए विभाजित किया जाता है।
इस दृष्टिकोण में विरासत का उपयोग किया जा सकता है।
उदाहरण
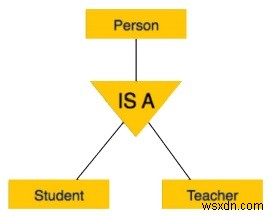
एक व्यक्ति का नाम, जन्म तिथि, लिंग, आदि होता है। ये गुण सभी व्यक्तियों, मनुष्यों में आम हैं। लेकिन एक कंपनी में, व्यक्तियों को कर्मचारी, नियोक्ता, ग्राहक, या विक्रेता के रूप में पहचाना जा सकता है, इस आधार पर कि वे कंपनी में क्या भूमिका निभाते हैं।