एक सॉफ्टवेयर एप्लिकेशन केवल उतना ही मूल्यवान है जितना यह अपने ग्राहकों की जरूरतों को पूरा कर सकता है। जब हम ग्राहकों की जरूरतों पर विचार करते हैं, तो पहली मांग जो हमारा सामना करती है वह है एप्लिकेशन की गति और डेटा विश्वसनीयता। हालांकि, जैसे-जैसे एप्लिकेशन बढ़ते हैं और वैश्विक स्तर पर विस्तार करते हैं, SQL डेटाबेस अक्सर बढ़ी हुई क्वेरी मात्रा, उच्च लेटेंसी, और भौगोलिक रूप से फैले यूजर बेस के कारण परफॉरमेंस बॉटलनेक बन जाते हैं।
एप्लिकेशन बढ़ने पर इन समस्याओं को हल करने के लिए, कैशिंग प्राथमिक डेटाबेस पर दोहराए जाने वाली क्वेरीज़ के लोड को कम करने और उपयोगकर्ताओं द्वारा क्वेरी सबमिट करने पर लेटेंसी कम करने के पहले समाधानों में से एक है। जब हम कैश की बात करते हैं, तो हम सभी के दिमाग में वही टूल आता है, है न? हां, वह रेडिस है। रेडिस डेटा को कैश करने के लिए डेटाबेस लोड को कम करने और एप्लिकेशन को तेज़ बनाने के लिए एक आदर्श टूल है। अपस्टैश विश्व स्तर पर वितरित रेडिस रेप्लिकेशन भी प्रदान करता है, जो एप्लिकेशन को नियमित कैश से भी बहुत तेज़ बना देगा।
इस ब्लॉग में, हम SQL डेटाबेस के साथ ग्लोबल रेडिस इंटीग्रेट करने के तकनीकी लाभों का पता लगाएंगे, लेटेंसी और स्केलेबिलिटी पर इसके प्रभाव पर चर्चा करेंगे, और PostgreSQL और MySQL के साथ ग्लोबल रेडिस का उपयोग करने के लिए हैंड्स-ऑन उदाहरण प्रदान करेंगे।
कैशिंग के लाभ
आइए पहले जांचें कि हमें कैशिंग का उपयोग क्यों करना चाहिए।
इस ब्लॉग में मैं कैशिंग के दो मुख्य लाभों का उल्लेख करना चाहूंगा: डेटाबेस लोड कम करना और उपयोगकर्ताओं के लिए लेटेंसी कम करना।
डेटाबेस लोड कम करना
SQL डेटाबेस संरचित डेटा और जटिल क्वेरीज़ को प्रबंधित करने में उत्कृष्ट हैं, लेकिन भारी लोड के तहत, वे एक बॉटलनेक बन सकते हैं। एक ही डेटा के लिए दोहराई जाने वाली क्वेरीज़ की उच्च मात्रा - जैसे उत्पाद विवरण, यूजर प्रोफाइल, या अक्सर एक्सेस की जाने वाली सेटिंग्स - महत्वपूर्ण CPU और I/O संसाधनों का उपभोग करती हैं। इन परिणामों को कैश करके, डेटाबेस पर आने वाली क्वेरीज़ की संख्या नाटकीय रूप से कम हो जाती है, जिससे डेटाबेस ट्रांजैक्शन प्रोसेसिंग और अपडेट जैसे अधिक महत्वपूर्ण कार्यों पर ध्यान केंद्रित कर सकता है।
उदाहरण के लिए:
- कैशिंग के बिना: एक वेबसाइट पर एक लोकप्रिय फीचर प्रतिदिन लाखों समान डेटाबेस क्वेरीज़ जनरेट करता है, जिससे अन्य ऑपरेशन्स के लिए परफॉरमेंस धीमी हो जाती है।
- कैशिंग के साथ: अक्सर एक्सेस किए जाने वाले क्वेरी परिणाम रेडिस जैसे हाई-स्पीड कैश में स्टोर होते हैं, जिससे डेटाबेस क्वेरी दर 90% से अधिक कम हो जाती है।
लेटेंसी कम करना
डेटाबेस लोड कम करना सिस्टम हेल्थ के लिए था ताकि डेटा विश्वसनीयता सुनिश्चित हो सके। कैशिंग उपयोगकर्ता अनुरोधों और क्वेरीज़ के समय में भी सुधार करता है।
जब एप्लिकेशन बार-बार एक ही डेटा के लिए डेटाबेस क्वेरी करते हैं, तो डेटा रिट्रीवल में हमेशा लंबा समय लगेगा। खासकर अगर ये क्वेरीज़ डेटाबेस पर बड़ा लोड बनाती हैं, तो ये सभी देरी और बढ़ सकती हैं। यह उन एप्लिकेशन के लिए विशेष रूप से समस्याग्रस्त है जिन्हें रियल-टाइम डेटा एक्सेस की आवश्यकता होती है या हाई क्वेरी वॉल्यूम को संभालते हैं, जहां छोटी देरी भी परफॉरमेंस को महत्वपूर्ण रूप से प्रभावित कर सकती है।
कैशिंग इस समस्या को हल करता है अक्सर एक्सेस किए जाने वाले डेटा को मेमोरी में स्टोर करके, जिसे डेटाबेस क्वेरी करने की तुलना में बहुत तेज़ी से रिट्रीव किया जा सकता है। दोहराए गए अनुरोधों के लिए डेटाबेस क्वेरीज़ पर निर्भरता कम करके, कैशिंग नेटवर्क यात्रा को कम करता है और जटिल क्वेरीज़ निष्पादित करने के कम्प्यूटेशनल ओवरहेड से बचाता है। परिणामस्वरूप, प्रतिक्रिया समय नाटकीय रूप से सुधरते हैं, जिससे एप्लिकेशन भारी लोड या वितरित वातावरण में भी तेज़, अधिक सुसंगत परफॉरमेंस प्रदान कर सकते हैं।
सामान्य कैशिंग रणनीतियाँ
एप्लिकेशन परफॉरमेंस ऑप्टिमाइज़ेशन में उपयोग की जाने वाली दो प्राथमिक कैशिंग रणनीतियों को समझना भी महत्वपूर्ण है: कैश-असाइड और राइट-थ्रू। प्रत्येक दृष्टिकोण के अपने उपयोग के मामले और ट्रेड-ऑफ हैं, जो एप्लिकेशन की आवश्यकताओं पर निर्भर करते हैं।
कैश-असाइड सबसे आम कैशिंग तकनीक है। इस तकनीक में, एप्लिकेशन पहले डेटा के लिए कैश की जांच करता है। यदि डेटा कैश में नहीं है (कैश मिस), तो यह डेटाबेस से डेटा प्राप्त करता है और भविष्य के उपयोग के लिए इसे कैश में लिखता है।
यहां एक सरल डायग्राम है जो दिखाता है कि कैश-असाइड कैसे काम करता है, जिसे आप सभी ने इस ब्लॉग पर आने से पहले कहीं देखा होगा।
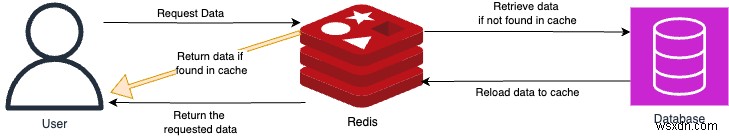
इस कैशिंग का लाभ यह है कि कैश साइज़ ऑप्टिमाइज़्ड है, और कैश डेटा उपयोगकर्ताओं द्वारा आवश्यक होने पर रीलोड होता है। दूसरी ओर, नुकसान यह है कि जब इसका TTL समाप्त होता है तो कैश साफ होने के बाद डेटा उपलब्ध नहीं होगा। उस समय, कैश तब रीलोड होगा जब उपयोगकर्ता उस डेटा का अनुरोध करेगा। इस मामले में, उस उपयोगकर्ता को क्वेरी पूरी होने तक इंतजार करना होगा। लेकिन निश्चित रूप से, अगले अनुरोध फिर से कैश से डेटा प्राप्त कर सकेंगे।
राइट-थ्रू रणनीति में, डेटाबेस पर हर राइट ऑपरेशन तुरंत कैश में भी लिखा जाता है। यह सुनिश्चित करता है कि कैश हमेशा डेटाबेस से नवीनतम डेटा के साथ अप-टू-डेट रहे।
यहां राइट-थ्रू कैशिंग का एक सरल डायग्राम है:
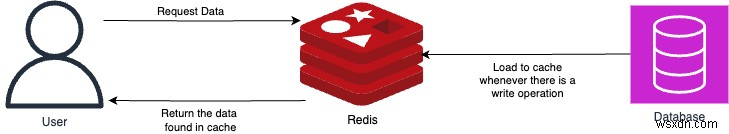
यह रणनीति कैश और डेटाबेस के बीच डेटा स्थिरता सुनिश्चित करती है और कोई भी अनुरोध उच्च लेटेंसी का अनुभव नहीं करता क्योंकि डेटा उपयोगकर्ता से अनुरोध की प्रतीक्षा किए बिना पहले से उपलब्ध होगा। हालांकि, नुकसान यह है कि कैश में सभी डेटा होता है, भले ही इसकी आवश्यकता न हो। इसके अलावा, हर राइट ऑपरेशन को लेटेंसी मिलेगी क्योंकि डेटा को कैश में भी लिखा जाएगा।
ग्लोबल रेडिस क्या है? ग्लोबल रेडिस के लाभ
आइए अब जांचें कि SQL डेटाबेस के परफॉरमेंस को और कैसे सुधारा जाए।
लेटेंसी का एक अन्य स्रोत डेटाबेस का स्थान है। ज्यादातर मामलों में, प्राथमिक डेटाबेस विशिष्ट क्षेत्रों में स्थित होता है। हालांकि, डेटा निकटतम स्थान पर पहुंच योग्य होना चाहिए ताकि हम डेटा स्टोर तक की दूरी के कारण होने वाली देरी को कम कर सकें।
इस समस्या को अपस्टैश द्वारा प्रदान किए गए विश्व स्तर पर वितरित रेडिस का उपयोग करके रोका जा सकता है।
ग्लोबल रेडिस एक वितरित कैशिंग समाधान है जो डेटा को कई भौगोलिक स्थानों पर रेप्लिकेट करता है, जिससे विश्व स्तर पर वितरित एप्लिकेशन के लिए कम-लेटेंसी एक्सेस सुनिश्चित होता है।
आइए जल्दी से देखें कि ग्लोबल रेडिस कैसे बनाएं। पहले, अपस्टैश कंसोल में लॉगिन करें।
लॉगिन के बाद, हम यहां एक रेडिस डेटाबेस बना सकते हैं। अपस्टैश रीड रेप्लिकाज़ का पता लगाने के लिए कई स्थान प्रदान करता है।
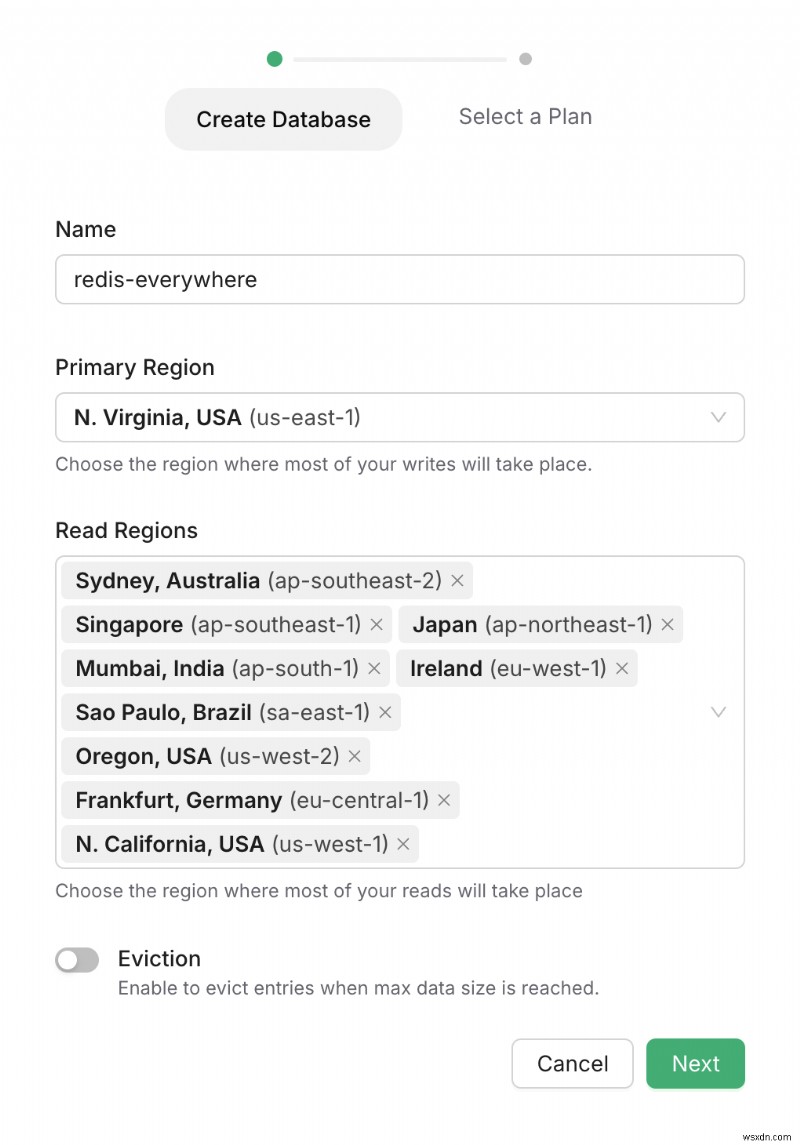
रीड लोकेशन्स चुनने के बाद, आप अपना प्लान चुन सकते हैं और अंत में अपना रेडिस डेटाबेस बना सकते हैं। बस इतना ही!
कंसोल में, आप डेटाबेस बनाने के बाद क्षेत्रों को जोड़/हटा भी सकते हैं।
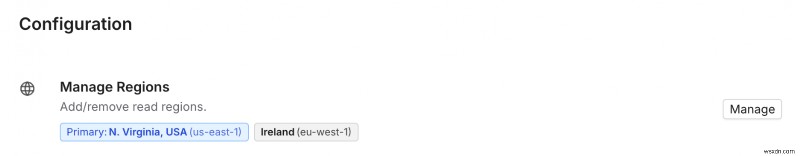
ग्लोबल रेडिस डेटाबेस का उपयोग ज्यादातर उन एप्लिकेशन द्वारा किया जाता है जो विश्व स्तर पर वितरित हैं और जो एज पर चल रहे हैं।
वैश्विक रूप से वितरित एप्लिकेशन के लिए कम लेटेंसी
वैश्विक रूप से वितरित सिस्टम में, लेटेंसी अक्सर उपयोगकर्ताओं और केंद्रीय डेटाबेस या कैश के बीच भौतिक दूरी के कारण बॉटलनेक बन जाती है। ग्लोबल रेडिस इसे कई भौगोलिक रूप से वितरित नोड्स पर डेटा रेप्लिकेट करके संबोधित करता है।
जब कोई उपयोगकर्ता डेटा का अनुरोध करता है, तो निकटतम कैश नोड अनुरोध को पूरा करता है, जिससे नेटवर्क यात्रा समय नाटकीय रूप से कम हो जाता है। यह स्थानीयकृत एक्सेस तेज़ प्रतिक्रिया समय और एक सुसंगत उपयोगकर्ता अनुभव सुनिश्चित करता है, चाहे उपयोगकर्ता का स्थान कहीं भी हो।
मान लीजिए, यदि कोई उपयोगकर्ता टोक्यो में स्थित है, लेकिन डेटाबेस डबलिन में है, तो दूरी उपयोगकर्ता को प्रतिक्रिया में देरी करेगी। यदि अपस्टैश रेडिस का एक रीड रेप्लिका यूरोप में है, तो अनुरोध को निकटतम रीड रेप्लिका पर रूट किया जा सकता है, जो इस मामले में यूरोप में वाला है।
एज रनटाइम्स के लिए कम लेटेंसी डेटा (जैसे Cloudflare Workers)
एज रनटाइम्स ऐसे एनवायरनमेंट हैं जो नेटवर्क के एज पर, अंतिम उपयोगकर्ता के करीब कोड निष्पादित करने के लिए डिज़ाइन किए गए हैं। एज रनटाइम्स एप्लिकेशन लॉजिक को दुनिया भर में कई एज स्थानों पर वितरित करते हैं। यह आर्किटेक्चर उपयोगकर्ताओं और उनके अनुरोधों के निष्पादन के बीच भौतिक दूरी को कम करता है, जिससे लेटेंसी काफी कम हो जाती है और परफॉरमेंस में सुधार होता है।
जबकि एज रनटाइम्स कम्प्यूटेशन को उपयोगकर्ताओं के करीब लाते हैं, उन्हें अभी भी अधिकांश ऑपरेशन्स के लिए डेटा तक पहुंच की आवश्यकता होती है, जैसे यूजर-विशिष्ट जानकारी, सत्र टोकन, या कॉन्फिगरेशन प्राप्त करना। कैशिंग लेयर के बिना, प्रत्येक अनुरोध को अभी भी सेंट्रल डेटाबेस की राउंड ट्रिप की आवश्यकता होगी, जिससे लेटेंसी लाभ का अधिकांश हिस्सा नकार दिया जाएगा। यहीं ग्लोबल रेडिस एक महत्वपूर्ण भूमिका निभाते हैं, क्योंकि वे अक्सर उपयोग किए जाने वाले डेटा को एज पर रेप्लिकेट करते हैं, जिससे कम-लेटेंसी एक्सेस सुनिश्चित होता है।
उदाहरण कोड 1: Node.js के साथ PostgreSQL
ग्लोबल रेडिस के साथ कैशिंग परफेक्ट है। अब, हम एक कोड सैंपल देखेंगे जो अपस्टैश रेडिस और एक PostgreSQL डेटाबेस के साथ कैश-असाइड रणनीति को लागू करता है।
हमें पहले उन SDKs को इंस्टॉल करना चाहिए जिनका उपयोग हम डेटा स्टोर्स से कनेक्ट करने के लिए करेंगे।
npm install pg upstash/redis एक बार हमारे पास निर्भरताएं इंस्टॉल हो जाने पर, हम डेटा स्टोर्स, अपस्टैश रेडिस और Postgres से कनेक्ट कर सकते हैं।
const { Redis } = require('@upstash/redis'); // अपस्टैश रेडिस SDK
const { Client } = require('pg');
const redis = new Redis({
  url: ,
  token: ,
})
const client = new Client({
  user: 'username',
  password: 'password',
  host: 'host',
  port: 'port_number',
  database: 'database_name',
});
client.connect();
अब आइए अपने डेटा एक्सेस लेयर में फंक्शन लिखें। इस फंक्शन को आपकी आवश्यकताओं के अनुसार संशोधित किया जा सकता है।
मान लीजिए हम userId द्वारा अपनी वेबसाइट पर यूजर जानकारी दिखाना चाहते हैं। इस मामले में, हमारे पास एक फंक्शन होना चाहिए जो पैरामीटर के रूप में userId लेता है
async function getUserData(userId) {
  // पहले कैश जांचें
  const cachedData = await redis.get(userId);
  if (cachedData) {
    console.log('Cache hit');
    return JSON.parse(cachedData);
  }
  // डेटाबेस पर फॉलबैक
  console.log('Cache miss');
  const query = 'SELECT * FROM users WHERE id = $1';
  const { rows } = await client.query(query, [userId]);
  await redis.set(userId, JSON.stringify(rows), { EX: 300 }); // 5 मिनट के लिए कैश करें
  return rows;
}
यह लीजिए! अब यह फंक्शन पहले जांचेगा कि अनुरोधकर्ता के क्षेत्र के निकटतम रेडिस डेटाबेस में यूजर जानकारी उपलब्ध है या नहीं। यदि उपलब्ध नहीं है, तो यह PostgreSQL डेटाबेस से अनुरोधित डेटा क्वेरी करेगा और लौटाए गए डेटा को अपस्टैश रेडिस प्राइमरी क्षेत्र में लिखेगा। प्राइमरी क्षेत्र में लिखा गया डेटा स्वचालित रूप से सभी रीड रेप्लिकाज़ पर कॉपी हो जाएगा।
उदाहरण कोड 2: Python के साथ MYSQL
अब, आइए एक और उदाहरण देखें। इस बार, हम वही कैश इम्प्लीमेंटेशन करेंगे, लेकिन मुख्य डेटाबेस MYSQL होगा। साथ ही, हम इस फंक्शन को Python में लिखेंगे यह देखने के लिए कि यह Python-आधारित एप्लिकेशन में कैसे काम करता है।
हमेशा की तरह, हम पहले उन निर्भरताओं को डाउनलोड करेंगे जिनका उपयोग हम डेटाबेस से कनेक्ट करने के लिए करेंगे।
pip install upstash-redis upstash-redis अब, हम क्लाइंट्स को इनिशियलाइज़ और कनेक्ट कर सकते हैं।
import upstash_redis
import mysql.connector
import json
# अपस्टैश रेडिस क्लाइंट इनिशियलाइज़ करें
redis_client = upstash_redis.Redis(
  url='',
  token=''
)
# MySQL क्लाइंट इनिशियलाइज़ करें
db = mysql.connector.connect(
  host="",
  user="",
  password="",
  database=""
)
cursor = db.cursor(dictionary=True)
कनेक्शन तैयार हैं। अब हम पिछले सेक्शन में इम्प्लीमेंट किए गए समान फंक्शन को इम्प्लीमेंट करेंगे।
def get_user_data(userId):
  # डेटा के लिए कैश जांचें
  cache_data = redis_client.get(key)
  if cache_data:
    print("Cache hit")
    return json.loads(cache_data)
  # अगर कैश मिस, MySQL डेटाबेस क्वेरी करें
  print("Cache miss")
  cursor.execute("SELECT * FROM users WHERE key = %s", (userId))
  result = cursor.fetchone()
  if result:
    # 1 घंटे के TTL के साथ डेटा को कैश में स्टोर करें
    redis_client.set(key, json.dumps(result), ex=3600)
  return result
निष्कर्ष
अपनी आर्किटेक्चर में ग्लोबल रेडिस को इंटीग्रेट करके, आप SQL-आधारित एप्लिकेशन के लिए महत्वपूर्ण परफॉरमेंस लाभ प्राप्त कर सकते हैं, विशेष रूप से विश्व स्तर पर वितरित वातावरण में। कम-लेटेंसी एक्सेस, कम डेटाबेस लोड, और एज रनटाइम्स के साथ संगतता के साथ, ग्लोबल रेडिस SQL डेटाबेस वाले एप्लिकेशन की परफॉरमेंस चुनौतियों को संबोधित कर सकता है।
इस ब्लॉग पोस्ट में, हम ग्लोबल रेडिस के साथ कैशिंग के लाभों से गुजरे और कुछ उदाहरणों की जांच की। ये सिर्फ बेसिक उदाहरण थे जिन्हें आपकी आवश्यकताओं के आधार पर और बढ़ाया जा सकता है।
मुझे उम्मीद है कि यह ब्लॉग आपके लिए ग्लोबल रेडिस की शक्ति का लाभ उठाना शुरू करने के लिए एक अच्छी शुरुआत हो सकता है।