Redis SQL क्वेरी चलाना मुश्किल नहीं होना चाहिए। मैंने वास्तव में कुछ साल पहले यह बात उठाई थी जब एक दोस्त से बात कर रहा था जो एक रिटेल कंपनी में डेटा वेयरहाउसिंग समाधान प्रबंधित करता है। हमने Redis की क्वेरीज़ के बारे में बात करना शुरू किया जब उसने एक समस्या बताई जिसका वह सामना कर रहा था।
"हमारे डेटा वेयरहाउसिंग समाधानों के साथ एक दर्द बिंदु है। हमारे पास ऐसे उपयोग के मामले हैं जहां हमें डेटा रिकॉर्ड करने और रियल-टाइम में विश्लेषणात्मक संचालन करने की आवश्यकता होती है। हालांकि, कभी-कभी परिणाम प्राप्त करने में मिनट लग जाते हैं। क्या Redis यहां मदद कर सकता है? ध्यान रखें कि हम अपने SQL-आधारित समाधान को एक बार में नहीं बदल सकते। हम एक समय में केवल एक छोटा कदम उठा सकते हैं।"
अब, यदि आप मेरे दोस्त की तरह ही स्थिति में हैं, तो हमारे पास आपके लिए अच्छी खबर है। ऐसे कई तरीके हैं जिनसे आप Redis क्वेरी चला सकते हैं और अपने वर्तमान SQL-आधारित समाधान को बिना बाधित किए Redis को अपनी आर्किटेक्चर में पेश कर सकते हैं।
आइए जानें कि आप यह कैसे कर सकते हैं। लेकिन इससे पहले कि हम आगे बढ़ें, हमारे पास एक Redis हैकथॉन प्रतियोगी है जिसने अपना ऐप बनाया है जो आपको SQL के साथ Redis में डेटा क्वेरी करने की अनुमति देता है।
नीचे दिया गया वीडियो देखें।
अपनी टेबल्स को Redis डेटा संरचनाओं के रूप में रीमॉडल करें
अपनी टेबल को Redis डेटा संरचनाओं में मैप करना काफी सीधा है। अनुसरण करने के लिए सबसे उपयोगी डेटा संरचनाएं हैं:
- Hash
- Sorted Set
- Set
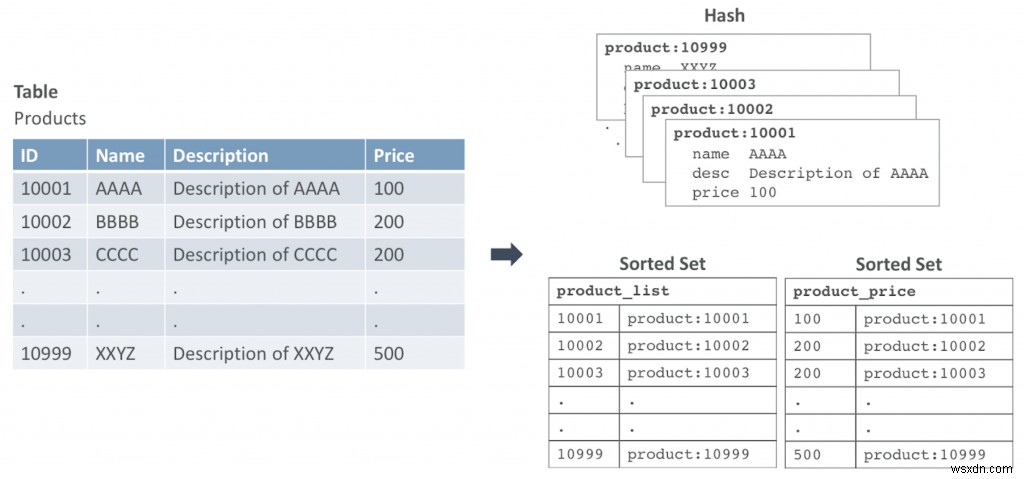
इसे करने का एक तरीका यह है कि प्रत्येक पंक्ति को एक Hash के रूप में संग्रहीत किया जाए जिसकी कुंजी टेबल की प्राथमिक कुंजी पर आधारित हो और कुंजी को एक Set या Sorted Set में संग्रहीत किया जाए।
चित्र 1 दिखाता है कि आप टेबल को Redis डेटा संरचनाओं में कैसे मैप कर सकते हैं। इस उदाहरण में, हमारे पास Products नामक एक टेबल है। प्रत्येक पंक्ति को एक Hash डेटा संरचना में मैप किया गया है।
प्राथमिक ID 10001 वाली पंक्ति product:10001 कुंजी के साथ एक Hash के रूप में जाएगी। इस उदाहरण में हमारे दो Sorted Sets हैं: पहला प्राथमिक कुंजी द्वारा डेटासेट के माध्यम से पुनरावृति करने के लिए और दूसरा कीमत के आधार पर क्वेरी करने के लिए।
इस विकल्प के साथ, आपको अपने कोड में Redis क्वेरीज़ के बजाय SQL कमांड का उपयोग करने के लिए परिवर्तन करने होंगे। नीचे SQL और Redis समकक्ष कमांड के कुछ उदाहरण दिए गए हैं:
A. डेटा डालें
SQL: insert into Products (id, name, description, price) values = (10200, "ZXYW","Description for ZXYW", 300);
Redis: MULTI HMSET product:10200 name ZXYW desc "Description for ZXYW" price 300 ZADD product_list 10200 product:10200 ZADD product_price 300 product:10200 EXEC
B. उत्पाद ID द्वारा क्वेरी करें
SQL: select * from Products where id = 10200
Redis: HGETALL product:10200
C. कीमत के आधार पर क्वेरी करें
SQL: select * from Product where price < 300
Redis: ZRANGEBYSCORE product_price 0 300
यह कुंजियाँ लौटाता है: product:10001, product:10002, product:10003। अब प्रत्येक कुंजी के लिए HGETALL चलाएं।
HGETALL product:10001 HGETALL product:10002 HGETALL product:10003
DataFrames का उपयोग करके अपनी टेबल्स को स्वचालित रूप से Redis डेटा संरचनाओं में मैप करें
अब, यदि आप अपने समाधानों में SQL इंटरफेस को बनाए रखना चाहते हैं और केवल अंतर्निहित डेटा स्टोर को Redis में बदलकर इसे तेज बनाना चाहते हैं, तो आप Apache Spark और Spark-Redis लाइब्रेरी का उपयोग करके ऐसा कर सकते हैं।
Spark-Redis लाइब्रेरी आपको DataFrame APIs का उपयोग करके Redis डेटा को स्टोर और एक्सेस करने की अनुमति देती है। दूसरे शब्दों में, आप SQL कमांड का उपयोग करके डेटा डाल, अपडेट और क्वेरी कर सकते हैं, लेकिन डेटा आंतरिक रूप से Redis डेटा संरचनाओं में मैप होता है।
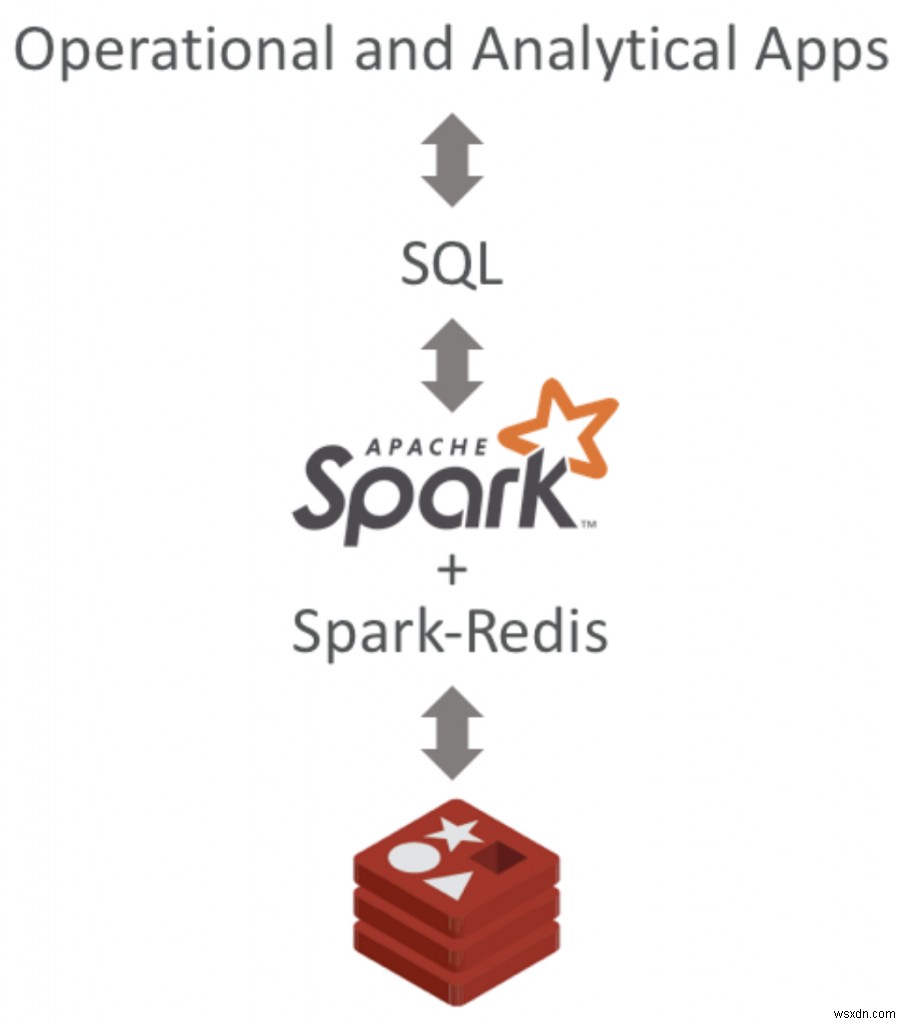
सबसे पहले, आपको spark-redis डाउनलोड करना होगा और लाइब्रेरी बिल्ड करके jar फाइल प्राप्त करनी होगी। उदाहरण के लिए, spark-redis 2.3.1 के साथ, आपको spark-redis-2.3.1-SNAPSHOT-jar-with-dependencies.jar मिलता है।
फिर आपको यह सुनिश्चित करना होगा कि आपका Redis इंस्टेंस चल रहा है। हमारे उदाहरण में, हम Redis को localhost और डिफ़ॉल्ट पोर्ट 6379 पर चलाएंगे।
आप Apache Spark इंजन पर अपनी क्वेरीज़ भी चला सकते हैं। यहां एक उदाहरण है कि आप यह कैसे कर सकते हैं:
$ spark-shell --jars spark-redis-2.3.1-SNAPSHOT-jar-with-dependencies.jar
scala> import org.apache.spark.sql.SparkSession scala> val spark = SparkSession .builder() .appName("redis-sql") .master("local[*]") .config("spark.redis.host","localhost") .config("spark.redis.port","6379").getOrCreate() scala> import spark.sql scala> import spark.implicits._ scala> sql("create table if not exists products(id string, name string, description string, price int) using org.apache.spark.sql.redis options (table 'product')") scala> sql("insert into products values = ('10200','ZXYW','Description of ZXYW', 300)") scala> val results = sql("select * from products") scala> results.show() +-----+----+-------------------+-----+ | id|name| description|price| +-----+----+-------------------+-----+ |10200|ZXYW|Description of ZXYW| 300| +-----+----+-------------------+-----+
अब आप अपने Redis क्लाइंट का उपयोग करके इस डेटा को Redis डेटा संरचनाओं के रूप में एक्सेस कर सकते हैं:
127.0.0.1:6379> keys product* 1) "product:2e3f8611dbe94a588706a2aaea547caa"
एक अधिक प्रभावी दृष्टिकोण scan कमांड का उपयोग करना होगा क्योंकि यह आपको डेटा के माध्यम से नेविगेट करते समय पेजिनेट करने की अनुमति देता है।
127.0.0.1:6379> scan 0 match product* 1) "3" 2) 1) "product:2e3f8611dbe94a588706a2aaea547caa" 127.0.0.1:6379> hgetall product:2e3f8611dbe94a588706a2aaea547caa 1) "name" 2) "ZXYW" 3) "price" 4) "300" 5) "description" 6) "Description of ZXYW" 7) "id" 8) "10200"
और वहां हमारे पास है - डिस्रप्शन के बिना Redis SQL क्वेरी चलाने के दो सरल तरीके। एक कदम आगे बढ़ते हुए, आप हमारे नए व्हाइटपेपर में Why Your SQL Server Needs Redis के बारे में जानना चाह सकते हैं।
लेकिन Redis के साथ रियल-टाइम डेटा के संबंध में, यह इसका उपयोग करके रियल-टाइम अनुभव प्रदान करने के कई तरीकों में से केवल एक है।
यदि आप जानना चाहते हैं कि Redis कैसे आपको रियल-टाइम डेटा ट्रांसमिशन की गारंटी दे सकता है, तो हमसे संपर्क करना सुनिश्चित करें।