यह पोस्ट मेरी राय में दुनिया की दो सबसे रोमांचक चीजों के बारे में है: प्रोबेबिलिस्टिक डेटा संरचनाएं और Redis मॉड्यूल। अगर आपने एक या दूसरे के बारे में सुना है तो आप निश्चित रूप से मेरे उत्साह से संबंधित हो सकते हैं, लेकिन अगर आप पृथ्वी पर सबसे अच्छी चीजों के बारे में जानना चाहते हैं तो बस पढ़ना जारी रखें।
मैं इस कथन से शुरू करूंगा: बड़े पैमाने पर लो-लेटेंसी डेटा प्रोसेसिंग चुनौतीपूर्ण है। शामिल डेटा की मात्रा और गति रियल-टाइम विश्लेषण को अत्यधिक मांग वाला बना सकती है। अपने उच्च प्रदर्शन और बहुमुखी प्रतिभा के कारण, Redis आमतौर पर ऐसी चुनौतियों को हल करने के लिए उपयोग किया जाता है। सब-मिलीसेकंड लेटेंसी में डेटा के कई रूपों को स्टोर, मैनिपुलेट और सर्व करने की इसकी क्षमता इसे कई मामलों में आदर्श डेटा कंटेनर बनाती है जहां ऑनलाइन गणना की आवश्यकता होती है।
लेकिन सब कुछ सापेक्ष है, और ऐसे पैमाने हैं जो इतने चरम हैं कि वे सटीक रियल-टाइम विश्लेषण को व्यावहारिक असंभव बना देते हैं। जटिल समस्याएं केवल बड़ी होने पर अधिक कठिन हो जाती हैं, लेकिन हम भूल जाते हैं कि सरल समस्याएं उसी नियम का पालन करती हैं। यहां तक कि संख्याओं को जोड़ने जैसी बुनियादी चीज भी एक स्मारकीय कार्य बन सकती है जब डेटा बहुत बड़ा, बहुत तेज हो या जब हमारे पास इसे संसाधित करने के लिए पर्याप्त संसाधन न हों। और जबकि संसाधन हमेशा सीमित और महंगे होते हैं, डेटा लगातार बढ़ रहा है जैसे किसी का व्यवसाय नहीं।
काउंट-मिन स्केच क्या है?
काउंट-मिन स्केच (जिसे CM स्केच भी कहा जाता है) एक प्रोबेबिलिस्टिक डेटा संरचना है जो एक बार आप समझ लें कि यह कैसे काम करता है और, अधिक महत्वपूर्ण बात, इसका उपयोग कैसे करना है, तो अत्यधिक उपयोगी है।
सौभाग्य से, CM स्केच की सरल विशेषताएं इसे नौसिखियों के लिए अपेक्षाकृत आसान बनाती हैं (बेहतर होता कि मेरे कई दोस्त इस टॉप-के ब्लॉग को फॉलो नहीं कर पाते)।

CM स्केच कई वर्षों से एक Redis मॉड्यूल रहा है और हाल ही में RedisBloom मॉड्यूल v2.0 के हिस्से के रूप में फिर से लिखा गया था। लेकिन CM स्केच में गोता लगाने से पहले, यह समझना महत्वपूर्ण है कि आप किसी भी प्रोबेबिलिस्टिक डेटा संरचना का उपयोग क्यों करेंगे। गति, स्थान और सटीकता के त्रिकोण में, प्रोबेबिलिस्टिक डेटा संरचनाएं कुछ सटीकता का त्याग करके स्थान प्राप्त करती हैं—संभावित रूप से बहुत सारा स्थान! गति पर प्रभाव एल्गोरिदम और सेट आकार के आधार पर भिन्न होता है।
- सटीकता: परिभाषा के अनुसार, केवल अपने डेटा का हिस्सा रखने और स्टोरेज में टकराव की अनुमति देने से सटीकता कम हो जाती है। फिर भी आप अपने उपयोग के मामले के आधार पर अधिकतम त्रुटि दर निर्धारित कर सकते हैं।
- मेमोरी स्थान: बड़ी डेटा की दुनिया में जहां अरबों घटनाएं रिकॉर्ड की जाती हैं, केवल आंशिक डेटा संग्रहीत करने से स्टोरेज स्थान आवश्यकताओं और लागत को जबरदस्त रूप से कम किया जा सकता है।
- गति: कुछ पारंपरिक डेटा संरचनाएं अपेक्षाकृत अक्षमता से काम करती हैं, जिससे प्रतिक्रिया समय धीमा हो जाता है। (उदाहरण के लिए, एक सॉर्टेड सेट इसमें सभी तत्वों के क्रम को बनाए रखता है, लेकिन आप केवल शीर्ष तत्वों में रुचि रख सकते हैं। क्योंकि प्रोबेबिलिस्टिक एल्गोरिदम केवल एक आंशिक सूची बनाए रखते हैं, वे अधिक कुशल होते हैं और अक्सर क्वेरी का उत्तर बहुत तेजी से दे सकते हैं।
सही प्रोबेबिलिस्टिक डेटा संरचना आपको अपने डेटासेट में केवल कुछ जानकारी रखने की अनुमति देती है ताकि सटीकता कम हो। बेशक, कई मामलों में (बैंक खाते, उदाहरण के लिए), कम सटीकता अस्वीकार्य है। लेकिन किसी फिल्म की सिफारिश करने या वेबसाइट उपयोगकर्ताओं को विज्ञापन दिखाने के लिए, अपेक्षाकृत दुर्लभ गलती की लागत कम है और स्थान बचत पर्याप्त हो सकती है।
मूल रूप से, CM स्केच आपके डेटासेट में सभी वस्तुओं की गिनती को कई काउंटर सरणियों में एकत्रित करके काम करता है। क्वेरी पर, यह सभी सरणियों में आइटम की न्यूनतम गिनती लौटाता है, जो टकराव के कारण होने वाली गिनती मुद्रास्फीति को कम करने का वादा करता है। कम उपस्थिति दर या स्कोर वाली वस्तुएं ("माउस फ्लो") की गिनती त्रुटि दर से नीचे होती है, इसलिए आप उनके वास्तविक गिनती के बारे में कोई डेटा खो देते हैं और उन्हें शोर के रूप में माना जाता है। उच्च उपस्थिति दर या स्कोर वाली वस्तुओं ("हाथी फ्लो") के लिए, बस प्राप्त गिनती का उपयोग करें। CM स्केच का आकार स्थिर होने और अनंत संख्या में वस्तुओं के लिए उपयोग किए जा सकने पर विचार करते हुए, आप स्टोरेज स्थान में भारी बचत की संभावना देख सकते हैं।
पृष्ठभूमि के लिए, स्केच डेटा संरचनाओं का एक वर्ग है और उनके साथ आने वाले एल्गोरिदम। वे आपके डेटा की प्रकृति को पकड़ते हैं ताकि इसके बारे में सवालों का जवाब दिया जा सके जबकि निरंतर या सबलिनियर स्थान का उपयोग किया जाता है। CM स्केच का वर्णन ग्राहम कॉर्मोड और एस. मुथु मुथुकृष्णन ने 2005 के पेपर "एन इम्प्रूव्ड डेटा स्ट्रीम समरी: द काउंट-मिन स्केच एंड इट्स एप्लिकेशन्स." में किया था।
काउंट-मिन स्केच: क्या और कैसे
CM स्केच अपने प्राथमिक उपयोग मामलों का समर्थन करने के लिए काउंटरों की कई सरणियों का उपयोग करता है। आइए सरणियों की संख्या को "गहराई" और प्रत्येक सरणी में काउंटरों की संख्या को "चौड़ाई" कहें।
जब भी हमें कोई आइटम प्राप्त होता है, हम एक हैश फ़ंक्शन (जो एक तत्व - एक शब्द, वाक्य, संख्या, या बाइनरी - को एक संख्या में बदल देता है जिसे सेट/सरणी में स्थान के रूप में या फिंगरप्रिंट के रूप में उपयोग किया जा सकता है) का उपयोग करके आइटम का स्थान गणना करते हैं और प्रत्येक सरणी के लिए उस काउंटर को बढ़ाते हैं। प्रत्येक संबंधित काउंटर का मान आइटम के वास्तविक मान के बराबर या उससे अधिक होता है। जब हम पूछताछ करते हैं, तो हम उन्हीं हैश फ़ंक्शन के साथ सभी सरणियों से गुजरते हैं और अपने आइटम से जुड़े काउंटर को लाते हैं। फिर हम न्यूनतम मान लौटाते हैं क्योंकि हम जानते हैं कि हमारे मान बढ़े हुए हैं (या बराबर हैं)।
भले ही हम जानते हैं कि कई आइटम अधिकांश काउंटरों में योगदान करते हैं, प्राकृतिक टकराव के कारण (जब अलग-अलग आइटम को समान स्थान मिलता है), हम 'शोर' को तब तक स्वीकार करते हैं जब तक यह हमारी वांछित त्रुटि दर के भीतर रहता है।
काउंट-मिन स्केच उदाहरण
गणित निर्देशित करता है कि 10 की गहराई और 2,000 की चौड़ाई के साथ, त्रुटि न होने की संभावना 99.9% है और त्रुटि दर 0.1% है। (यह कुल वृद्धि का प्रतिशत है, अद्वितीय वस्तुओं का नहीं)।
वास्तविक संख्याओं में, इसका मतलब है कि यदि आप 1 मिलियन अद्वितीय आइटम जोड़ते हैं, तो औसतन, प्रत्येक आइटम को 500 का मान प्राप्त होगा (1M/2K)। हालांकि यह असंगत लगता है, यह हमारी 0.1% त्रुटि दर के भीतर अच्छी तरह से आता है, जो 1 मिलियन आइटम पर 1,000 है।
इसी तरह, यदि 10 हाथी प्रत्येक 10,000 बार दिखाई देते हैं, तो सभी सेट पर उनका मूल्य 10,000 या अधिक होगा। जब भी हम भविष्य में उन्हें गिनते हैं, हम अपने सामने एक हाथी देखेंगे। अन्य सभी संख्याओं के लिए (यानी, सभी चूहे जिनकी वास्तविक गिनती 1 है), उनके सभी सेट पर हाथी से टकराने की संभावना नहीं है (चूंकि CM स्केच केवल न्यूनतम गिनती पर विचार करता है) क्योंकि ऐसा होने की संभावना कम है और CM स्केच को इनिशियलाइज़ करते समय गहराई बढ़ाने पर यह और कम हो जाती है।
काउंट-मिन स्केच किसके लिए अच्छा है?
अब जब हम CM स्केच के व्यवहार को समझते हैं, तो हम इस छोटे जानवर के साथ क्या कर सकते हैं? यहां कुछ सामान्य उपयोग मामले हैं:
- दो संख्याओं को क्वेरी करें और उनकी गिनती की तुलना करें।
- आने वाली वस्तुओं का एक प्रतिशत सेट करें, मान लें 1%। जब भी किसी वस्तु की मिन-गिनती कुल गिनती के 1% से अधिक होती है, तो हम सच लौटाते हैं। इसका उपयोग ऑनलाइन गेम के शीर्ष खिलाड़ी को निर्धारित करने के लिए किया जा सकता है, उदाहरण के लिए।
- CM स्केच में एक मिन-हीप जोड़ें और एक टॉप-के डेटा संरचना बनाएं। जब भी हम किसी आइटम को बढ़ाते हैं, तो हम जांचते हैं कि नई मिन-गिनती हीप में न्यूनतम से अधिक है या नहीं और तदनुसार अपडेट करते हैं। RedisBloom में टॉप-के मॉड्यूल के विपरीत, जो समय के साथ धीरे-धीरे क्षय होता है, CM स्केच कभी नहीं भूलता और इसलिए इसका व्यवहार HeavyKeeper-आधारित टॉप-के से थोड़ा अलग है।
RedisBloom में, CM स्केच के लिए API सरल और आसान है:
- CM स्केच डेटा संरचना को इनिशियलाइज़ करने के लिए: INITBYDIM {key} {width} {depth} या CMS.INITBYPROB {key} {error} {probability}
- किसी आइटम के काउंटर बढ़ाने के लिए: CMS.INCRBY {key} {item} {increment}
- आइटम के काउंटरों में मिली न्यूनतम गिनती प्राप्त करने के लिए: CMS.QUERY {key} {item}
इस पोस्ट के शीर्ष पर एनिमेटेड उदाहरण बनाने के लिए निम्न कमांड का उपयोग किया गया था:
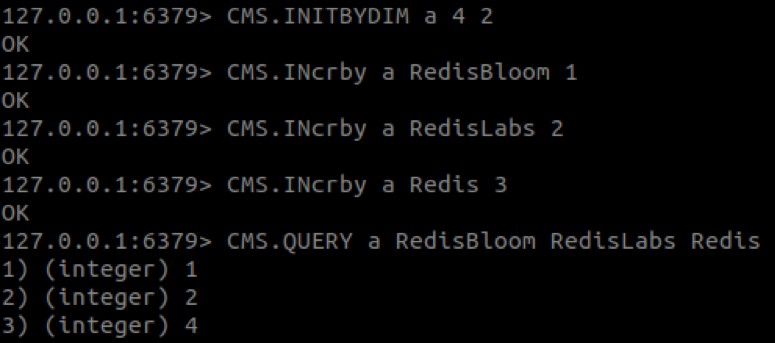
जैसा कि आप देख सकते हैं, 'Redis' का मान 3 के बजाय 4 है। यह व्यवहार अपेक्षित है क्योंकि, CM स्केच में, किसी आइटम की गिनती बढ़ी हुई होने की संभावना है।
एक स्केची व्यवसाय
सॉफ़्टवेयर इंजीनियरिंग ट्रेड-ऑफ बनाने के बारे में है, और ऐसी चुनौतियों को लागत-प्रभावी तरीके से संबोधित करने का एक लोकप्रिय दृष्टिकोण दक्षता के पक्ष में सटीकता को त्यागना है। यह दृष्टिकोण Redis के HyperLogLog के कार्यान्वयन द्वारा दर्शाया गया है, एक डेटा संरचना जिसे सेट कार्डिनैलिटी के बारे में क्वेरी का कुशलता से उत्तर देने के लिए डिज़ाइन किया गया है। HyperLogLog "स्केच" कहे जाने वाले डेटा संरचनाओं के एक परिवार का सदस्य है, जो अपने वास्तविक-विश्व कलात्मक समकक्षों की तरह, अपने विषयों के सन्निकटन के माध्यम से जानकारी व्यक्त करते हैं।
मोटे तौर पर, स्केच डेटा संरचनाएं (और उनके साथ आने वाले एल्गोरिदम) हैं जो आपके डेटा की प्रकृति को पकड़ते हैं—आपके डेटा के बारे में आपके सवालों के जवाब, बिना वास्तव में डेटा को संग्रहीत किए। औपचारिक रूप से कहा जाए तो, स्केच उपयोगी हैं क्योंकि उनकी सबलिनियर एसिम्प्टोटिक कम्प्यूटेशनल जटिलता होती है, इस प्रकार कम कंप्यूटिंग शक्ति और/या स्टोरेज की आवश्यकता होती है। लेकिन कोई मुफ्त लंच नहीं है और दक्षता में लाभ उत्तरों की सटीकता से ऑफसेट होता है। हालांकि, कई मामलों में, त्रुटियां स्वीकार्य हैं जब तक उन्हें एक सीमा के तहत रखा जा सकता है। एक अच्छा डेटा स्केच वह है जो आसानी से अपनी त्रुटियों को स्वीकार करता है, और वास्तव में, कई स्केच अपनी त्रुटियों (या उन त्रुटियों की संभावना) को पैरामीटराइज़ करते हैं ताकि उन्हें उपयोगकर्ता द्वारा परिभाषित किया जा सके।
अच्छे स्केच कुशल होते हैं और उनकी त्रुटि की बाउंड प्रायिकता होती है, लेकिन उत्कृष्ट स्केच वे हैं जिन्हें समानांतर में गणना की जा सकती है। एक समानांतर स्केच वह है जिसे डेटा के भागों पर स्वतंत्र रूप से तैयार किया जा सकता है और जो इसके भागों को एक सार्थक और सुसंगत समग्र में संयोजित करने की अनुमति देता है। क्योंकि एक उत्कृष्ट स्केच का प्रत्येक टुकड़ा एक अलग स्थान और/या समय पर गणना की जा सकती है, समानांतरता स्केलिंग चुनौतियों को हल करने के लिए एक सीधा विभाजन-और-विजय दृष्टिकोण लागू करना संभव बनाती है।
एक लगातार समस्या
उपरोक्त HyperLogLog एक उत्कृष्ट स्केच है लेकिन यह केवल एक विशिष्ट प्रकार के प्रश्न का उत्तर देने के लिए उपयुक्त है। एक और अमूल्य उपकरण काउंट मिन स्केच (CMS) है, जैसा कि G. कॉर्मोड और S. मुथुकृष्णन द्वारा "एन इम्प्रूव्ड डेटा स्ट्रीम समरी: द काउंट-मिन स्केच एंड इट्स एप्लिकेशन्स" पेपर में वर्णित है। इस सरल उपकरण को नमूनों की आवृत्ति के बारे में उत्तर प्रदान करने के लिए बनाया गया था, जो विश्लेषणात्मक प्रक्रियाओं के एक बड़े प्रतिशत में एक सामान्य बिल्डिंग ब्लॉक है।
पर्याप्त समय और संसाधन दिए जाने पर, नमूनों की आवृत्ति की गणना एक सरल प्रक्रिया है - बस प्रत्येक नमूने (देखी गई चीज़) के लिए अवलोकन (देखे गए समय) की गिनती रखें और फिर उसे अवलोकनों की कुल संख्या से विभाजित करें ताकि उस नमूने की आवृत्ति प्राप्त हो सके। हालांकि, हाई-स्केल लो-लेटेंसी डेटा प्रोसेसिंग के संदर्भ में, कभी भी पर्याप्त समय या संसाधन नहीं होते। उत्तर तुरंत दिए जाने हैं क्योंकि डेटा स्ट्रीम करता है, इसके पैमाने की परवाह किए बिना, और नमूनाकरण स्थान का विशाल आकार प्रत्येक नमूने के लिए एक काउंटर रखना अव्यवहारिक बनाता है।
इसलिए प्रत्येक नमूने को सटीक रूप से ट्रैक करने के बजाय, हम आवृत्ति का अनुमान लगाने की कोशिश कर सकते हैं। इसके बारे में जाने का एक तरीका है अवलोकनों को बेतरतीब ढंग से नमूना करना और आशा करना कि नमूना आम तौर पर पूरे के गुणों को दर्शाता है। इस दृष्टिकोण के साथ समस्या यह है कि वास्तविक यादृच्छिकता सुनिश्चित करना एक कठिन कार्य है, इसलिए यादृच्छिक नमूनाकरण की सफलता हमारी चयन प्रक्रिया और/या डेटा के गुणों द्वारा सीमित हो सकती है। यहीं पर CMS एक ऐसा दृष्टिकोण लेकर आता है जो इतना मौलिक रूप से अलग है, कि पहली नज़र में, यह एक उत्कृष्ट स्केच के विपरीत लग सकता है: न केवल CMS प्रत्येक अवलोकन को रिकॉर्ड करता है, प्रत्येक को कई काउंटरों में रिकॉर्ड किया जाता है!
बेशक, एक मोड़ है, और यह उतना ही चतुर है जितना सरल है। मूल पेपर (और इसका हल्का संस्करण जिसे "काउंट-मिन डेटा संरचना के साथ डेटा का सन्निकटन" कहा जाता है) इसे समझाने का बहुत अच्छा काम करता है, लेकिन मैं वैसे भी इसे सारांशित करने की कोशिश करूंगा। CMS की चतुराई उस तरीके में है जिस तरह से यह नमूनों को संग्रहीत करता है: प्रत्येक अद्वितीय नमूने को स्वतंत्र रूप से ट्रैक करने के बजाय, यह इसके हैश मान का उपयोग करता है। एक नमूने का हैश मान एक निरंतर-आकार (पेपर में d के रूप में पैरामीटराइज़्ड) काउंटर सरणी के सूचकांक के रूप में उपयोग किया जाता है। कई (पैरामीटर w) अलग-अलग हैश फ़ंक्शन और उनकी संबंधित सरणियों को नियोजित करके, स्केच संरचना को क्वेरी करते समय पाए जाने वाले हैश टकराव को नमूने के लिए सभी प्रासंगिक काउंटरों में से न्यूनतम मान चुनकर संभालता है।
एक उदाहरण की आवश्यकता है, तो आइए डेटा संरचना के आंतरिक कामकाज को स्पष्ट करने के लिए एक सरल स्केच बनाएं। स्केच को सरल रखने के लिए, हम छोटे पैरामीटर मानों का उपयोग करेंगे। हम w को 3 पर सेट करेंगे, जिसका अर्थ है कि हम तीन हैश फ़ंक्शन का उपयोग करेंगे - जिन्हें क्रमशः h1, h2, और h3 दर्शाया गया है, और d को 4। स्केच के काउंटरों को संग्रहीत करने के लिए हम कुल 12 तत्वों के साथ एक 3×4 सरणी का उपयोग करेंगे जिसे 0 से इनिशियलाइज़ किया गया है।
अब हम जांच सकते हैं कि जब नमूनों को स्केच में जोड़ा जाता है तो क्या होता है। मान लें कि नमूने एक-एक करके आते हैं और पहले नमूने के लिए हैश, जिसे s1 दर्शाया गया है, हैं: h1(s1) = 1, h2(s1) = 2 और h3(s1) = 3। स्केच में s1 रिकॉर्ड करने के लिए हम प्रत्येक हैश फ़ंक्शन के प्रासंगिक सूचकांक पर काउंटर को 1 से बढ़ाएंगे। निम्न तालिका सरणी की प्रारंभिक और वर्तमान अवस्थाओं को दिखाती है:
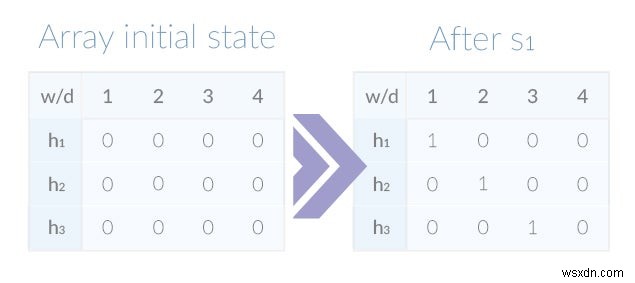
हालांकि स्केच में केवल एक नमूना है, हम पहले से ही इसे प्रभावी ढंग से क्वेरी कर सकते हैं। याद रखें कि एक नमूने के लिए अवलोकनों की संख्या इसके सभी काउंटरों का न्यूनतम है, इसलिए s1 के लिए यह द्वारा प्राप्त किया जाता है:
min(array[1][h1(s1)], array[2][h2(s1)], array[3][h3(s1)]) =
 min(array[1][1], array[2][2], array[3][3]) =
 min(1,1,1) = 1
स्केच अभी तक न जोड़े गए नमूनों के बारे में क्वेरी का भी उत्तर देता है। मान लें कि h1(s2) = 4, h2(s2) = 4, h3(s2) = 4, ध्यान दें कि s2 के लिए क्वेरी करने पर परिणाम 0 मिलेगा। आइए s2 और s3 (h1(s3) = 1, h2(s3) = 1, h3(s3) = 1) को स्केच में जोड़ना जारी रखें, जिससे निम्न प्राप्त होता है:
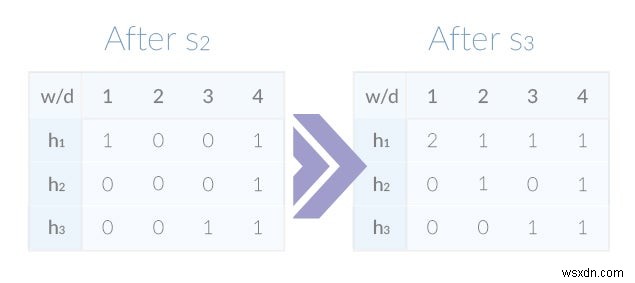
हमारे गढ़े गए उदाहरण में, लगभग सभी नमूनों के हैश अद्वितीय काउंटरों पर मैप होते हैं, एक अपवाद h1(s1) और h1(s3) की टक्कर है। चूंकि दोनों हैश समान हैं, h1 का पहला काउंटर अब मान 2 रखता है। चूंकि स्केच सभी काउंटरों का न्यूनतम चुनता है, s1 और s3 के लिए क्वेरी अभी भी 1 का सही परिणाम लौटाती हैं। अंततः, हालांकि, एक बार पर्याप्त टकराव होने पर, क्वेरी के परिणाम कम सटीक हो जाएंगे।
CMS के दो पैरामीटर - w और d - इसकी स्थान/समय आवश्यकताओं के साथ-साथ इसकी त्रुटि की संभावना और अधिकतम मूल्य निर्धारित करते हैं। स्केच को इनिशियलाइज़ करने का एक अधिक सहज तरीका त्रुटि की संभावना और सीमा प्रदान करना है, जिससे यह w और d के लिए आवश्यक मान प्राप्त कर सके। समानांतरीकरण संभव है क्योंकि किसी भी संख्या में सब-स्केच को सरणियों के योग के रूप में तुच्छ रूप से मर्ज किया जा सकता है, जब तक कि उनके निर्माण में समान पैरामीटर और हैश फ़ंक्शन का उपयोग किया जाता है।
काउंट-मिन स्केच के बारे में कुछ अवलोकन
काउंट मिन स्केच की दक्षता को इसकी आवश्यकताओं की समीक्षा करके प्रदर्शित किया जा सकता है। CMS की स्थान जटिलता w, d, और उसके द्वारा उपयोग किए जाने वाले काउंटरों की चौड़ाई का गुणनफल है। उदाहरण के लिए, 0.01% त्रुटि दर वाला स्केच जो 0.01% संभावना पर है, 10 हैश फ़ंक्शन और 2000-काउंटर सरणियों का उपयोग करके बनाया जाता है। 16-बिट काउंटरों के उपयोग को मानते हुए, परिणामी स्केच की डेटा संरचना की कुल मेमोरी आवश्यकता 40KB पर आती है (कुल अवलोकनों की संख्या और कुछ पॉइंटर्स को संग्रहीत करने के लिए कुछ अतिरिक्त बाइट्स की आवश्यकता होती है)। स्केच का अन्य कम्प्यूटेशनल पहलू इसी तरह सुखद है - क्योंकि हैश फ़ंक्शन सस्ते में उत्पादित और गणना किए जाते हैं, डेटा संरचना तक पहुंचना, चाहे पढ़ने के लिए या लिखने के लिए, निरंतर समय में भी किया जाता है।
CMS में और भी बहुत कुछ है; स्केच के लेखकों ने यह भी दिखाया है कि इसका उपयोग अन्य समान प्रश्नों का उत्तर देने के लिए कैसे किया जा सकता है। इनमें पर्सेंटाइल का अनुमान लगाना और हैवी हिटर्स (लगातार आइटम) की पहचान करना शामिल है लेकिन इस पोस्ट के दायरे से बाहर हैं।
CMS निश्चित रूप से एक उत्कृष्ट स्केच है, लेकिन कम से कम दो चीजें हैं जो इसे पूर्णता प्राप्त करने से रोकती हैं। CMS के बारे में मेरा पहला आरक्षण यह है कि यह पक्षपाती हो सकता है, और इस प्रकार कम अवलोकनों वाले नमूनों की आवृत्तियों को अधिक आंकता है। CMS का पक्षपात अच्छी तरह से जाना जाता है और कई सुधार सुझाए गए हैं। सबसे हालिया काउंट मिन लॉग स्केच ("G. पिटेल और G. फौक्वियर से लगभग काउंटरों के साथ लगभग गिनती") है, जो अनिवार्य रूप से CMS के रैखिक रजिस्टरों को लॉगरिदमिक वाले से बदल देता है ताकि सापेक्ष त्रुटि कम हो और काउंटर रजिस्टरों की चौड़ाई बढ़ाए बिना उच्च गिनती की अनुमति मिल सके।
जबकि उपरोक्त आरक्षण सभी के द्वारा साझा किया जाता है (हालांकि केवल वे जो डेटा संरचनाओं को समझते हैं), मेरा दूसरा आरक्षण Redis समुदाय के लिए विशिष्ट है। समझाने के लिए, मुझे Redis मॉड्यूल पेश करने होंगे।
एक Redis मॉड्यूल
Redis मॉड्यूल का अनावरण इस साल की शुरुआत में RedisConf में एंटीरेज़ द्वारा किया गया था और शाब्दिक रूप से हमारी दुनिया को उल्टा कर दिया। सर्वर-लोडेबल डायनामिक लाइब्रेरी से अधिक या कम कुछ भी नहीं, मॉड्यूल Redis उपयोगकर्ताओं को Redis की तुलना में तेजी से आगे बढ़ने और पहले कभी न सपने देखे गए स्थानों पर जाने की अनुमति देते हैं। और जबकि यह पोस्ट मॉड्यूल क्या हैं या उन्हें कैसे बनाया जाए, इसका परिचय नहीं है, यह एक है (साथ ही यह पोस्ट, और यह वेबिनार)।
कई कारण हैं जिनसे मैं काउंट मिन स्केच Redis मॉड्यूल लिखना चाहता था, इसकी अत्यधिक उपयोगिता के अलावा। इसका एक हिस्सा सीखने का अनुभव था और इसका एक हिस्सा मॉड्यूल API का मूल्यांकन था, लेकिन ज्यादातर यह सिर्फ Redis में एक नई डेटा संरचना को मॉडल करने में बहुत मजेदार था। मॉड्यूल स्केच में अवलोकन जोड़ने, इसे क्वेरी करने, और कई स्केच को एक में मर्ज करने के लिए एक Redis इंटरफ़ेस प्रदान करता है।
मॉड्यूल स्केच के डेटा को एक Redis स्ट्रिंग में संग्रहीत करता है और की के कंटेंट को इसकी आंतरिक डेटा संरचना में मैप करने के लिए डायरेक्ट मेमोरी एक्सेस (DMA) का उपयोग करता है। मैंने अभी तक इस पर संपूर्ण प्रदर्शन बेंचमार्क नहीं किए हैं, लेकिन स्थानीय रूप से इसका परीक्षण करने से मेरा प्रारंभिक प्रभाव यह है कि यह किसी भी कोर Redis कमांड जितना प्रदर्शनशील है। हमारे अन्य मॉड्यूल की तरह, काउंटमिनस्केच ओपन सोर्स है और मैं आपको इसे आज़माने और इसे हैक करने के लिए प्रोत्साहित करता हूं।
साइन ऑफ करने से पहले, मैं अपना वादा निभाना चाहता हूं और CMS के बारे में अपना Redis-विशिष्ट आरक्षण साझा करना चाहता हूं। यह मुद्दा, जो अन्य स्केच और डेटा संरचनाओं पर भी लागू होता है, यह है कि CMS को उपयोग करने से पहले इसे सेट अप/इनिशियलाइज़/बनाने की आवश्यकता होती है। CMS पैरामीटर सेटअप जैसे अनिवार्य इनिशियलाइज़ेशन चरण की आवश्यकता, Redis के मौलिक पैटर्न में से एक को तोड़ती है - डेटा संरचनाओं को उपयोग से पहले स्पष्ट रूप से घोषित करने की आवश्यकता नहीं होती क्योंकि वे ऑन-डिमांड बनाए जा सकते हैं। मॉड्यूल को अधिक Redis-ईश बनाने और उस एंटी-पैटर्न के आसपास काम करने के लिए, मॉड्यूल डिफ़ॉल्ट पैरामीटर मानों का उपयोग करता है जब एक नया स्केच अंतर्निहित रूप से निहित होता है (यानी गैर-मौजूदा की पर CMS.ADD कमांड का उपयोग करना) लेकिन दिए गए पैरामीटर के साथ नए खाली स्केच बनाने की भी अनुमति देता है।
प्रोबेबिलिस्टिक डेटा संरचनाएं, या स्केच, अद्भुत उपकरण हैं जो हमें बड़े डेटा की वृद्धि और लेटेंसी बजट के संकुचन के साथ कुशल और पर्याप्त रूप से सटीक तरीके से तालमेल रखने देते हैं। इस पोस्ट में उल्लिखित दो स्केच, और अन्य जैसे ब्लूम फ़िल्टर और T-डाइजेस्ट, आधुनिक डेटा मॉन्गर के शस्त्रागार में तेजी से अनिवार्य उपकरण बन रहे हैं। मॉड्यूल आपको कस्टम डेटा प्रकारों और कमांड के साथ Redis का विस्तार करने की अनुमति देते हैं जो नेटिव गति से काम करते हैं और डेटा तक स्थानीय पहुंच रखते हैं। संभावनाएं अनंत हैं और कुछ भी असंभव नहीं है।
Redis मॉड्यूल और उन्हें कैसे विकसित करें, इसके बारे में अधिक जानना चाहते हैं? क्या कोई डेटा संरचना है, चाहे प्रोबेबिलिस्टिक हो या नहीं, जिस पर आप चर्चा करना या Redis में जोड़ना चाहते हैं? किसी भी चीज़ के लिए मेरे ट्विटर अकाउंट या ईमेल के माध्यम से मुझसे संपर्क करने के लिए स्वतंत्र महसूस करें - मैं अत्यधिक उपलब्ध हूँ 🙂