मैं व्यक्तिगत रूप से स्ट्रीम को गलत तरीके से वर्णित करने का दोषी हूँ - मैंने इसे "समय के अनुसार क्रमबद्ध, एक ही कुंजी के तहत हैशमैप-जैसे तत्वों की श्रृंखला" के रूप में परिभाषित किया है। यह गलत है। समय और कुंजी के संबंध में अंतिम भाग ठीक है, लेकिन पहला भाग पूरी तरह से गलत है।
आइए देखें कि स्ट्रीम को क्यों गलत समझा जाता है और वे वास्तव में कैसे व्यवहार करते हैं। हम इस गलतफहमी के अच्छे और बुरे पहलुओं का मूल्यांकन करेंगे और यह आपके सॉफ़्टवेयर को कैसे प्रभावित कर सकता है। अंत में, हम कुछ गैर-स्पष्ट पैटर्न की जांच करेंगे जो Redis Streams के कम-ज्ञात गुणों का लाभ उठाते हैं।
पृष्ठभूमि
सबसे पहले, आइए XADD कमांड को देखें, क्योंकि यहीं से गलतफहमी शुरू होती है। आधिकारिक redis.io दस्तावेज़ीकरण में कमांड सिग्नेचर इस तरह दिखता है:
XADD key ID field value [field value ...]key स्व-व्याख्यात्मक है। id नई एंट्री के लिए टाइमस्टैम्प/सीक्वेंस कॉम्बो है, लेकिन वास्तव में, यह लगभग हमेशा ऑटो जनरेशन को इंगित करने के लिए * होता है। इस भ्रम की जड़ फील्ड और वैल्यू के साथ शुरू होती है। यदि आप HSET के लिए कमांड सिग्नेचर देखते हैं, तो आपको एक बहुत ही समान पैटर्न दिखाई देगा:
HSET key field value [field value ...]दोनों कमांड के सिग्नेचर केवल एक तर्क से भिन्न हैं और XADD में वह तर्क लगभग हमेशा एक ही * होता है। काफी समान दिखता है, समान शर्तों का उपयोग करता है, तो वे समान होने चाहिए, है ना?
ठीक है। समस्या को जारी रखने के लिए, आइए Redis को एक तरफ रखें और देखें कि प्रोग्रामिंग भाषाएं फील्ड-वैल्यू जोड़े से कैसे निपटती हैं। अधिकांश भाग के लिए, कोई फर्क नहीं पड़ता भाषा, फील्ड-वैल्यू को व्यक्त करने का सबसे प्रतिनिधि तरीका फील्ड का एक सेट (कोई दोहराव नहीं) है जो मूल्यों से संबंधित है - कुछ भाषाएं फील्ड के क्रम को बनाए रखेंगी और कुछ नहीं। आइए एक छोटी क्रॉस-भाषा तुलना के साथ गहराई से देखें:
यह Redis हैश के साथ अच्छी तरह से मैप होता है - ये सभी हैश के गुणों को व्यक्त कर सकते हैं, जो अनऑर्डर्ड है और इसमें कोई दोहराव नहीं है। PHP सरणियाँ, Python डिक्शनरी, और JavaScript मैप फील्ड ऑर्डर को परिभाषित कर सकते हैं, लेकिन यदि आप Redis में हैश के साथ काम कर रहे हैं, तो इससे कोई फर्क नहीं पड़ता, आपको बस यह जानना होगा कि आप एप्लिकेशन लेवल पर इस ऑर्डर पर भरोसा नहीं कर सकते।
अधिकांश लोगों के लिए, स्वाभाविक निष्कर्ष यह रहा है कि चूंकि HSET और XADD के कमांड सिग्नेचर में एक संबंध है, तो शायद रिटर्न में भी उनका समान संबंध है। वास्तव में, प्रोटोकॉल लेवल पर RESP2 में, ये दोनों इंटरलीव्ड RESP सरणियों के रूप में लौटाए जाते हैं। यह RESP3 के शुरुआती संस्करणों में जारी रहा जहां HGETALL और XREAD दोनों के लिए प्रतिक्रिया मैप्स थे (इस पर बाद में)।
एक बग ने मेरा मन बदल दिया
आम तौर पर, मैं JavaScript में कोड करता हूं और कभी-कभी Python। Redis के बारे में संवाद करने वाले किसी व्यक्ति के रूप में, मुझे यथासंभव अधिक से अधिक लोगों तक पहुंचने की आवश्यकता है और ये दो भाषाएं काफी अच्छी तरह से समझी जाती हैं, इसलिए किसी भी भाषा में एक डेमो या नमूना कोड डेवलपर दुनिया के एक उच्च प्रतिशत द्वारा समझा जाएगा। हाल ही में, मुझे एक PHP सम्मेलन में बात करने का अवसर मिला और कुछ मौजूदा Python कोड को PHP में बदलने की आवश्यकता थी। मैंने PHP का उपयोग लगभग 20 वर्षों से किया है, लेकिन यह कभी मेरा जुनून नहीं रहा। विशेष डेमो mod_php स्टाइल निष्पादन में अच्छी तरह से फिट नहीं हुआ, इसलिए मैंने swoole और इसके को-रूटीन निष्पादन का उपयोग किया (एक तरफ ध्यान दें, JavaScript दुनिया में सहज होने के कारण, swoole PHP को मेरे लिए बहुत, बहुत परिचित बनाता है)। लाइब्रेरी थोड़ी पुरानी थी और उच्च स्तर के तरीके से रिटर्न को डीकोड करने में किसी वास्तविक क्लाइंट लाइब्रेरी सहायता के बिना रॉ Redis कमांड भेजने की आवश्यकता थी। आम तौर पर, रॉ Redis कमांड भेजना और परिणामों को डीकोड करना थोड़ा अधिक नियंत्रण देता है और बोझिल नहीं है।
इसलिए, XADD को कमांड भेजते समय, मैं फील्ड-वैल्यू हिस्सा बना रहा था और एक ऑफ-बाय-वन त्रुटि थी (इसे PHP में वर्षों की अनुपस्थिति के बाद वापस गोता लगाने पर दोष दें)। इसके परिणामस्वरूप मैंने अनजाने में कुछ इस तरह भेजा:
XADD myKey * field0 value1 field0 value2 field2 value3सहसंबद्ध फील्ड और वैल्यू भेजने के बजाय (field0 से value0 और इसी तरह)।
बाद में कोड में, मैं XREAD के परिणामों को एक लूप में मौजूदा PHP सरणी (जो एसोसिएटिव है) में डाल रहा था, प्रत्येक फील्ड को कुंजी के रूप में और प्रत्येक वैल्यू को असाइन कर रहा था और पहले से सेट किसी भी चीज़ को छोड़ रहा था। तो, मैंने इस तरह की सरणी से शुरू किया:
array(1) { ["foo"]=> string(3) "bar" }
और इस तरह की सरणी के साथ समाप्त हुआ:
array(3) { ["foo"]=> string(3) "bar" ["field0"]=> string(6) "value1" ["field2"]=> string(6) "value3" }
मैं समझ नहीं सका कि यह कैसे संभव था। मैं जल्दी से इस बग को ट्रैक करने में सक्षम था कि value1 को field0 पर क्यों असाइन किया गया (ऊपर वर्णित XADD में ऑफ-बाय-वन त्रुटि), लेकिन field0 को value2 के रूप में क्यों सेट नहीं किया गया? HSET में, फील्ड जोड़ने के लिए यह व्यवहार मूल रूप से अपसर्ट है - यदि फील्ड मौजूद है तो अपडेट करें, अन्यथा फील्ड जोड़ें और मान सेट करें।
MONITOR लॉग्स की जांच और मानों को रीप्ले करके, मैंने XREAD को इस तरह चलाया:
> XREAD STREAMS myKey 0 1) 1) "myKey" 2) 1) 1) "1592409586907-0" 2) 1) "field0" 2) "value1" 3) "field0" 4) "value2" 5) "field2" 6) "value3"
दोहराव मौजूद हैं और रिकॉर्ड किए गए हैं, अपसर्ट नहीं; इसके अतिरिक्त क्रम संरक्षित है. यह हैश की तरह कुछ भी नहीं है!
JSON का उपयोग करके इसके बारे में सोचते हुए, मुझे लगा कि स्ट्रीम एंट्री इस तरह दिखती हैं:
{ "field1" : "value", "field2" : "value", "field3" : "value" }
लेकिन वे वास्तव में इस तरह दिखती हैं:
[ ["field1", "value"], ["field2", "value"], ["field3", "value"] ]
इसका क्या मतलब है?
अच्छी खबर
यदि आपके पास वर्तमान में स्ट्रीम के साथ काम करने वाला कोड है और आप मान रहे हैं कि एंट्री हैश मैप की तरह हैं, तो आप शायद ठीक हैं। आपको केवल डुप्लिकेट फील्ड डालने के संबंध में संभावित बग के लिए देखना होगा, क्योंकि वे दिए गए एप्लिकेशन में आपकी अपेक्षा के अनुरूप व्यवहार नहीं कर सकते हैं। यह हर परिस्थिति या क्लाइंट लाइब्रेरी पर लागू नहीं हो सकता है, लेकिन एक अच्छी प्रथा होगी कि एक डेटा संरचना प्रदान करें जो दोहराव की अनुमति न दे (ऊपर देखें) और XADD को तर्क प्रदान करते समय इसे सीरियलाइज़ करें। अद्वितीय फील्ड इन और अद्वितीय फील्ड आउट।
बुरी खबर
सभी क्लाइंट लाइब्रेरी और टूल इसे सही नहीं करते। अपेक्षाकृत निम्न-स्तरीय क्लाइंट लाइब्रेरी (गैर-विस्तृत: node_redis, hiredis) Redis से आउटपुट को भाषा निर्माणों में बदलने के लिए ज्यादा कुछ नहीं करती हैं। अन्य उच्च-स्तरीय लाइब्रेरी करती हैं Redis के वास्तविक रिटर्न को भाषा निर्माणों में अमूर्त करती हैं - आपको यह जांचना चाहिए कि आपकी पसंद की लाइब्रेरी यह कर रही है या नहीं और यदि ऐसा है तो एक मुद्दा डालें। कुछ उच्च-स्तरीय लाइब्रेरी ने इसे शुरू से ही सही पाया (stackexchange.redis), इसलिए वहां प्रशंसा की जानी चाहिए।
दूसरा भाग जो थोड़ा बुरा है: यदि आप RESP3 के बहुत शुरुआती अपनाने वाले थे, तो आपने XREAD / XREADGROUP को RESP3 मैप प्रकार लौटाते हुए अनुभव किया होगा। अप्रैल की शुरुआत तक, Redis 6 के विकासाधीन संस्करण ने भ्रमित रूप से स्ट्रीम पढ़ते समय दोहराव के साथ मैप्स लौटाए थे। शुक्र है, यह हल हो गया था और Redis 6 का GA संस्करण - पहला समय जब आपको वास्तव में प्रोडक्शन में RESP3 का उपयोग करना चाहिए था - XREAD / XREADGROUP के लिए उचित रिटर्न के साथ शिप किया गया था।
मजेदार हिस्सा
चूंकि मैंने इस बात पर चर्चा की है कि आप स्ट्रीम के बारे में कैसे गलत हैं, आइए थोड़ा सोचें कि आप इस अब तक गलत समझे गए ढांचे का लाभ कैसे उठा सकते हैं।
स्ट्रीम एंट्री में क्रम पर अर्थपूर्ण अर्थ लागू करें
तो, आपके पास वास्तव में इस पैटर्न के साथ खेलने के लिए तीन वेक्टर हैं। वेक्टर ग्राफिक्स के लिए एक पथ संग्रहीत करने की कल्पना करें। प्रत्येक स्ट्रीम एंट्री एक अद्वितीय बहुभुज या पथ होगी और फील्ड और वैल्यू निर्देशांक होंगे। उदाहरण के लिए, SVG के इस टुकड़े को लें:
<polyline points="50,150 50,200 200,200 200,100">
इसे इस तरह व्यक्त किया जा सकता है:
> XADD mySVG * 50 150 50 200 200 200 200 100प्रत्येक अतिरिक्त आकृति उसी कुंजी पर एक और एंट्री होगी। यदि आप Redis हैश के साथ ऐसा कुछ करने का प्रयास करते, तो आपके पास केवल दो निर्देशांक होते और कोई क्रम गारंटी नहीं होती। मान लीजिए, आप बिटफील्ड जैसी चीजों के साथ ऐसा कर सकते हैं, लेकिन आप लंबाई और निर्देशांक आकार के संबंध में बहुत लचीलापन खो देंगे। स्ट्रीम के साथ, आप शायद टाइमस्टैम्प के साथ भी कुछ साफ-सुथरा कर सकते हैं ताकि समय के साथ दिखाई देने वाली आकृतियों की श्रृंखला को दर्शाया जा सके।
सीक्वेंस्ड आइटम का समय-आदेशित सेट बनाएं
इसके लिए एक छोटे हैक की आवश्यकता है, लेकिन यह बहुत कार्यक्षमता प्रदान कर सकता है। कल्पना करें कि आप सरणी-जैसे डेटा का एक क्रम रख रहे हैं। प्रभावी रूप से, सरणियों की एक सरणी - JSON में आप इसे इस तरह सोच सकते हैं:
[ ["A New Hope", "The Empire Strikes Back", "Return of the Jedi"], ["The Phantom Menace", "Attack of the Clones", "Revenge of the Sith"], ["The Force Awakens", "The Last Jedi", "The Rise of Skywalker"] ]
आप इसे एक छोटी बारीकियों के साथ स्ट्रीम एंट्री की एक श्रृंखला के रूप में व्यक्त कर सकते हैं: आपको यह सुनिश्चित करने की आवश्यकता है कि आपके आंतरिक सूचियों में (छद्म) तत्वों की संख्या विषम नहीं है। यदि वे विषम हैं, जैसा कि ऊपर है, तो आपको इसे किसी तरह रिकॉर्ड करना होगा - यहां मैं इसे एक खाली स्ट्रिंग के साथ कर रहा हूं:
> XADD starwars * "A New Hope" "The Empire Strikes Back" "Return of the Jedi" "" "1592427370458-0" > XADD starwars * "The Phantom Menace" "Attack of the Clones" "Revenge of the Sith" "" "1592427393492-0" > XADD starwars * "The Force Awakens" "The Last Jedi" "The Rise of Skywalker" "" "1592427414475-0" > XREAD streams starwars 0 1# "starwars" => 1) 1) "1592427370458-0" 2) 1) "A New Hope" 2) "The Empire Strikes Back" 3) "Return of the Jedi" 4) "" 2) 1) "1592427393492-0" 2) 1) "The Phantom Menace" 2) "Attack of the Clones" 3) "Revenge of the Sith" 4) "" 3) 1) "1592427414475-0" 2) 1) "The Force Awakens" 2) "The Last Jedi" 3) "The Rise of Skywalker" 4) ""
आप इस पैटर्न में बहुत कुछ हासिल करते हैं (किसी भी 0-लंबाई स्ट्रिंग को फ़िल्टर करने के मामूली खर्च पर)।
पेजिनेशन कैश के रूप में स्ट्रीम
एक मुश्किल चीज जो आप अक्सर देखते हैं वह है किसी साइट पर वस्तुओं की सूची (ई-कॉमर्स, मैसेज बोर्ड, आदि)। यह आमतौर पर कैश्ड होता है लेकिन मैंने लोगों को इस प्रकार के डेटा को कैश करने के लिए सबसे अच्छी विधि खोजने की कोशिश करते हुए देखा है - क्या आप संपूर्ण परिणाम सेट को सॉर्टेड सेट जैसी किसी चीज़ में कैश करते हैं और ZRANGE के साथ बाहर की ओर पेजिनेट करते हैं, या क्या आप स्ट्रिंग कुंजी पर पूर्ण पेज संग्रहीत करते हैं? दोनों तरीकों के अपने गुण और कमियां हैं।
जैसा कि यह पता चला है, स्ट्रीम वास्तव में इसके लिए काम करते हैं। उदाहरण के लिए, ई-कॉमर्स लिस्टिंग लें। आपके पास आइटम की एक श्रृंखला है, प्रत्येक की एक ID है। उन वस्तुओं को सॉर्ट की एक सीमित श्रृंखला में सूचीबद्ध किया जाता है जिनमें आमतौर पर एक उलट होता है (A-Z, Z-A, कम से उच्च, उच्च से कम, उच्चतम-से-निम्नतम रेटिंग, निम्नतम-से-उच्चतम रेटिंग, आदि)।
इस प्रकार के डेटा को स्ट्रीम में मॉडल करने के लिए, आप एक विशेष "चंक" आकार निर्धारित करेंगे और इसे एक एंट्री बना देंगे। पूर्ण परिणाम पेज को एंट्री पर क्यों नहीं? यह आपको अपने पेजिनेशन में अलग-अलग आकार के पेज रखने की अनुमति देता है (उदाहरण के लिए, 10 आइटम प्रति पेज 5-5 के 2 चंक से बने हो सकते हैं, जबकि 25 प्रति पेज 5-5 के 5 चंक होंगे)। प्रत्येक एंट्री में फील्ड होंगे जो प्रोडक्ट ID से मैप होंगे और वैल्यू प्रोडक्ट डेटा होंगी। कृत्रिम रूप से कम चंक आकार के साथ इस सरलीकृत उदाहरण पर एक नज़र डालें:
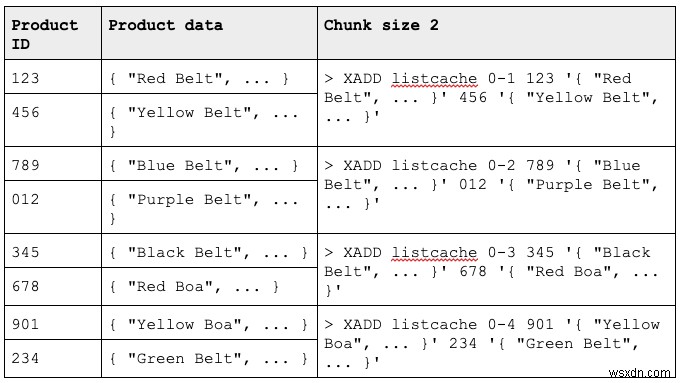
जब आप कैश्ड मान प्राप्त करना चाहते हैं, तो आप COUNT तर्क को उस चंक की संख्या पर सेट करके XRANGE चलाएंगे जो आपके इंटरफेस के लिए एक परिणाम पेज बनाते हैं। इसलिए, यदि आप चार आइटम का पहला पेज प्राप्त करना चाहते हैं तो आप चलाएंगे:
> XRANGE listcache - + COUNT 2 1) 1) "0-1" 2) 1) "123" 2) "{ \"Red Belt\", ... }" 3) "456" 4) "{ \"Yellow Belt\", ... }" 2) 1) "0-2" 2) 1) "789" 2) "{ \"Blue Belt\", ... }" 3) "012" 4) "{ \"Purple Belt\", ... }"
4 आइटम का दूसरा पेज प्राप्त करने के लिए, आपको 1 से बढ़ा हुआ निचला बाउंड स्ट्रीम ID प्रदान करना होगा, हमारे मामले में, निचला बाउंड 0-2 होगा।
> XRANGE listcache 0-3 + COUNT 2 1) 1) "0-3" 2) 1) "345" 2) "{ \"Black Belt\", ... }" 3) "678" 4) "{ \"Red Boa\", ... }" 2) 1) "0-4" 2) 1) "901" 2) "{ \"Yellow Boa\", ... }" 3) "234" 4) "{ \"Green Belt\", ... }"
यह सॉर्टेड सेट या लिस्ट पर कम्प्यूटेशनल जटिलता लाभ प्रदान करता है क्योंकि XRANGE इस उपयोग में प्रभावी रूप से O(1) है, लेकिन कुछ बातें ध्यान में रखनी हैं:
- उलटफेर के लिए XREVRANGE का उपयोग किया जा सकता है, हालांकि यह केवल "चंक" के क्रम को उलट देगा। प्रत्येक चंक के अंदर आपको एप्लिकेशन लॉजिक में क्रम को उलटना होगा जो अपेक्षाकृत तुच्छ होना चाहिए।
- यदि आप मैन्युअल रूप से स्ट्रीम ID को रैखिक रूप से सेट करते हैं तो सूची के विभिन्न हिस्सों में खोजना "मुफ्त" है, इसलिए चंक 1 स्ट्रीम ID 0-1 है, चंक 2 स्ट्रीम ID 0-2 है और इसी तरह। ध्यान दें कि आपको इसे 0 के बजाय 1 से शुरू करना होगा क्योंकि आप 0-0 पर स्ट्रीम एंट्री नहीं जोड़ सकते।
किसी भी कुंजी की तरह, आप समाप्ति का उपयोग करके प्रबंधित कर सकते हैं कि स्ट्रीम कब तक रहता है। इसका एक उदाहरण कि यह कैसे किया जा सकता है, stream-row-cache में है।
मुझे उम्मीद है कि यह पोस्ट आपको इस बारे में कुछ अतिरिक्त संदर्भ देता है कि स्ट्रीम वास्तव में कैसे काम करते हैं और आप अपने एप्लिकेशन में स्ट्रीम के इन अज्ञात गुणों का लाभ कैसे उठा सकते हैं।