"सादगी परम परिष्कार है"—लियोनार्डो दा विंची
"अधिकांश जानकारी अप्रासंगिक है और अधिकांश प्रयास व्यर्थ है, लेकिन केवल विशेषज्ञ जानता है कि क्या अनदेखा करना है"—जेम्स क्लियर, एटॉमिक हैबिट्स
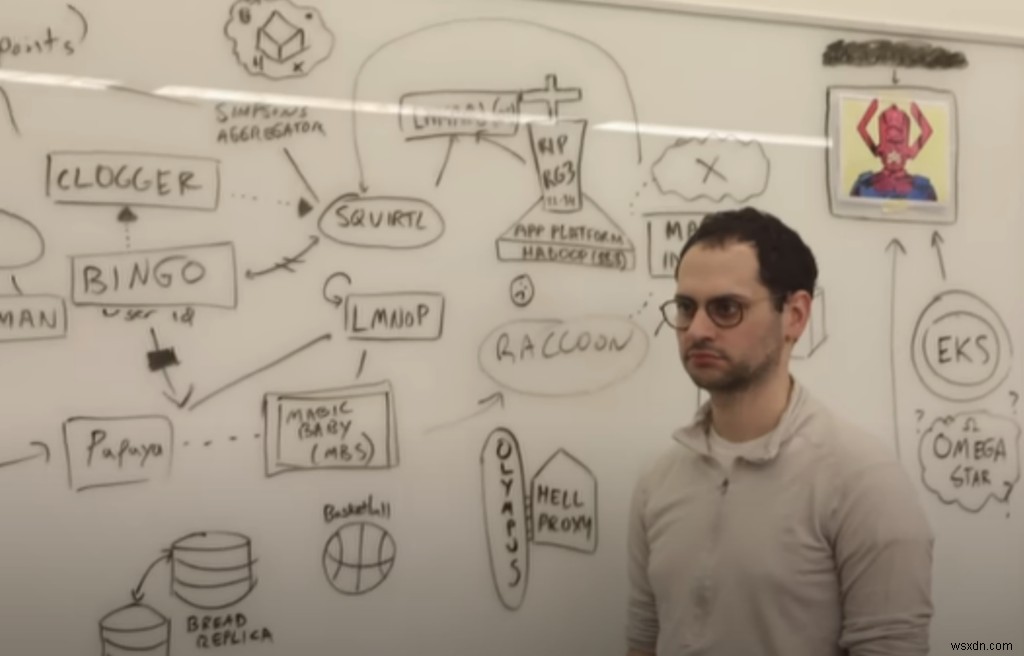
आपके पास बहुत सारे अलग-अलग सिस्टम के साथ एक फैंसी डेटा पाइपलाइन है। सतह पर यह बहुत परिष्कृत दिखता है, लेकिन हुड के नीचे यह वास्तव में एक जटिल गड़बड़ है। इसे अलग-अलग टुकड़ों को जोड़ने के लिए बहुत सारे प्लंबिंग कार्य की आवश्यकता हो सकती है, इसे लगातार निगरानी की आवश्यकता हो सकती है, इसे चलाने, डीबग करने और प्रबंधित करने के लिए अद्वितीय विशेषज्ञता वाली एक बड़ी टीम की आवश्यकता हो सकती है। यह उल्लेख नहीं करने के लिए कि आप जितने अधिक सिस्टम का उपयोग करते हैं, उतने ही अधिक स्थानों पर आप अपने डेटा को डुप्लिकेट कर रहे हैं और इसके आउट-ऑफ-सिंक या स्टेल होने की संभावना उतनी ही अधिक है। इसके अलावा, चूंकि इनमें से प्रत्येक सबसिस्टम को विभिन्न कंपनियों द्वारा स्वतंत्र रूप से विकसित किया जाता है, उनके अपग्रेड या बग फिक्स आपकी पाइपलाइन और आपके डेटा लेयर को तोड़ सकते हैं।
यदि आप सावधान नहीं हैं, तो आप नीचे तीन मिनट के वीडियो में चित्रित स्थिति में समाप्त हो सकते हैं। आगे बढ़ने से पहले इसे देखने की अत्यधिक अनुशंसा करता हूं।
जटिलता इसलिए उत्पन्न होती है क्योंकि भले ही प्रत्येक सिस्टम सतह पर सरल दिखाई दे, वे वास्तव में आपके पाइपलाइन में निम्नलिखित चर लाते हैं और बहुत सारी जटिलता जोड़ सकते हैं:
- प्रोटोकॉल—सिस्टम डेटा कैसे ट्रांसपोर्ट करता है? (HTTP, TCP, REST, GraphQL, FTP, JDBC)
- डेटा प्रारूप—सिस्टम किस प्रारूप का समर्थन करता है? (बाइनरी, CSV, JSON, Avro)
- डेटा स्कीमा और विकास—डेटा कैसे संग्रहीत किया जाता है? (टेबल, स्ट्रीम, ग्राफ, दस्तावेज़)
- SDKs और APIs—क्या सिस्टम आवश्यक SDKs और APIs प्रदान करता है?
- ACID और BASE—क्या यह ACID या BASE स्थिरता प्रदान करता है?
- माइग्रेशन—क्या सिस्टम सभी डेटा को सिस्टम में या उससे दूर माइग्रेट करने का एक आसान तरीका प्रदान करता है?
- स्थायित्व—स्थायित्व के आसपास सिस्टम की क्या गारंटी है?
- उपलब्धता—उपलब्धता के आसपास सिस्टम की क्या गारंटी है? (99.9%, 99.999%)
- स्केलेबिलिटी—यह कैसे स्केल करता है?
- सुरक्षा—सिस्टम कितना सुरक्षित है?
- प्रदर्शन—सिस्टम डेटा प्रोसेस करने में कितना तेज है?
- होस्टिंग विकल्प—क्या यह होस्टेड है या केवल ऑन-प्रिमाइज या मिश्रित?
- क्लाउड—क्या यह मेरे क्लाउड, क्षेत्र, आदि पर काम करता है?
- अतिरिक्त सिस्टम—क्या इसे एक अतिरिक्त सिस्टम की आवश्यकता है? (उदाहरण के लिए Kafka के लिए Zookeeper)
डेटा प्रारूप, स्कीमा और प्रोटोकॉल जैसे चर जिसे "ट्रांसफॉर्मेशन ओवरहेड" कहा जाता है, में जुड़ जाते हैं। प्रदर्शन, स्थायित्व और स्केलेबिलिटी जैसे अन्य चर जिसे "पाइपलाइन ओवरहेड" कहा जाता है, में जुड़ जाते हैं। एक साथ, ये वर्गीकरण जिसे "इम्पीडेंस मिसमैच" के रूप में जाना जाता है, में योगदान करते हैं। यदि हम इसे माप सकते हैं, तो हम जटिलता की गणना कर सकते हैं और अपने सिस्टम को सरल बनाने के लिए इसका उपयोग कर सकते हैं। हम इसमें थोड़ी देर में आएंगे।
अब, आप तर्क दे सकते हैं कि आपका सिस्टम, हालांकि यह जटिल दिखाई दे सकता है, वास्तव में आपकी आवश्यकताओं के लिए सबसे सरल सिस्टम है। लेकिन आप इसे कैसे साबित कर सकते हैं?
दूसरे शब्दों में, आप वास्तव में कैसे मापते हैं और बताते हैं कि आपका डेटा लेयर वास्तव में सरल या जटिल है? और दूसरी बात, आप कैसे अनुमान लगा सकते हैं कि जैसे-जैसे आप अधिक सुविधाएँ जोड़ते हैं, आपका सिस्टम सरल रहेगा? यानी, यदि आप अपने रोडमैप में अधिक सुविधाएँ जोड़ते हैं, तो क्या आपको अधिक सिस्टम जोड़ने की भी आवश्यकता है?
यहीं पर "इम्पीडेंस मिसमैच टेस्ट" आता है। लेकिन पहले देखते हैं कि इम्पीडेंस मिसमैच क्या है और फिर हम टेस्ट में जाएंगे।
इम्पीडेंस मिसमैच क्या है?
यह शब्द विद्युत इंजीनियरिंग में उत्पन्न हुआ जो विद्युत प्रतिबाधा में बेमेल को समझाता है, जिसके परिणामस्वरूप बिंदु A से बिंदु B तक ऊर्जा स्थानांतरित होने पर ऊर्जा की हानि होती है।
सीधे शब्दों में कहें, इसका मतलब है कि आपके पास जो है वह उससे मेल नहीं खाता जो आपको चाहिए। इसका उपयोग करने के लिए, आप जो वर्तमान में है उसे लेते हैं, इसे उसमें बदलते हैं जो आपको चाहिए, और फिर इसका उपयोग करते हैं। इसलिए एक बेमेल और बेमेल को ठीक करने से जुड़ा एक ओवरहेड है।
हमारे मामले में, आपके पास डेटा किसी रूप में या किसी मात्रा में है, और इसका उपयोग करने से पहले हमें इसे बदलने की आवश्यकता है। परिवर्तन कई बार हो सकता है और बीच में कई सिस्टम का उपयोग भी कर सकता है।
डेटाबेस की दुनिया में, इम्पीडेंस मिसमैच दो कारणों से होता है:
- ट्रांसफॉर्मेशनल ओवरहेड: सिस्टम डेटा को प्रोसेस या स्टोर करने का तरीका उससे भिन्न होता है जो डेटा वास्तव में दिखता है, या आप इसके बारे में कैसे सोचते हैं। उदाहरण के लिए: आपके सर्वर में, आपके पास डेटा को कई डेटा संरचनाओं में संग्रहीत करने का लचीलापन है, जैसे संग्रह, स्ट्रीम, सूचियाँ, सेट, सरणियाँ, आदि। यह आपको अपने डेटा को स्वाभाविक रूप से मॉडल करने में मदद करता है। हालांकि, आपको इसे RDBMS या JSON दस्तावेज़ स्टोर में टेबल में मैप करने की आवश्यकता है, ताकि उन्हें संग्रहीत किया जा सके। फिर पढ़ने के लिए विपरीत करें। ध्यान दें कि ऑब्जेक्ट-ओरिएंटेड भाषा मॉडल और रिलेशनल टेबल मॉडल के बीच विशिष्ट बेमेल को "ऑब्जेक्ट-रिलेशनल इम्पीडेंस मिसमैच" के रूप में जाना जाता है।
- पाइपलाइन ओवरहेड: सर्वर में आपके द्वारा प्रोसेस किए जाने वाले डेटा की मात्रा और प्रकार उस डेटा की मात्रा और प्रकार से भिन्न होते हैं जिसे आपका डेटाबेस संभाल सकता है। उदाहरण के लिए: यदि आप मोबाइल उपकरणों से आने वाले लाखों इवेंट प्रोसेस कर रहे हैं, तो आपका सामान्य RDBMS या दस्तावेज़ स्टोर इसे संग्रहीत करने में सक्षम नहीं हो सकता है, या उन इवेंट को आसानी से एग्रीगेट या गणना करने के लिए API प्रदान नहीं कर सकता है। इसलिए आपको विशेष स्ट्रीम-प्रोसेसिंग सिस्टम की आवश्यकता है, जैसे Kafka या Redis Streams, इसे प्रोसेस करने के लिए और शायद इसे संग्रहीत करने के लिए एक डेटा वेयरहाउस भी।
इम्पीडेंस मिसमैच टेस्ट
टेस्ट का लक्ष्य समग्र प्लेटफॉर्म की जटिलता को मापना है और भविष्य में अधिक सुविधाएँ जोड़ने पर जटिलता बढ़ती है या घटती है।
टेस्ट का तरीका केवल "ट्रांसफॉर्मेशनल ओवरहेड" और "पाइपलाइन ओवरहेड" की गणना करना है, "इम्पीडेंस मिसमैच स्कोर" (IMS) का उपयोग करके। यह आपको बताएगा कि आपका सिस्टम अन्य सिस्टम के सापेक्ष पहले से ही जटिल है या नहीं, और क्या वह जटिलता समय के साथ बढ़ती है जैसे-जैसे आप अधिक सुविधाएँ जोड़ते हैं।
IMS की गणना करने का सूत्र यहां है:

सूत्र केवल दोनों प्रकार के ओवरहेड को जोड़ता है और फिर उन्हें सुविधाओं की संख्या से विभाजित करता है। इस तरह, आपको प्रति सुविधा कुल ओवरहेड (यानी जटिलता स्कोर) मिलेगा।
इसे बेहतर ढंग से समझने के लिए, आइए चार अलग-अलग सरल डेटा पाइपलाइनों की तुलना करें और उनके स्कोर की गणना करें। और दूसरी बात, आइए यह भी कल्पना करें कि हम दो चरणों में एक साधारण ऐप बना रहे हैं, ताकि हम देख सकें कि जैसे-जैसे हम समय के साथ अधिक सुविधाएँ जोड़ते हैं, IMS स्कोर कैसे बदलता है।
चरण 1: रीयल-टाइम डैशबोर्ड बनाना
मान लें कि आप मोबाइल उपकरणों से लाखों बटन-क्लिक इवेंट प्राप्त कर रहे हैं और यदि कोई गिरावट या स्पाइक है तो अलर्ट की आवश्यकता है। इसके अतिरिक्त, आप इस पूरी चीज़ को अपने बड़े एप्लिकेशन की एक सुविधा मान रहे हैं।
केस 1: केवल RDBMS का उपयोग करके इन इवेंट को संग्रहीत करना, हालांकि टेबल फिट नहीं हो सकते।
- ट्रांसफॉर्मेशनल ओवरहेड = 1
- आपको इवेंट स्ट्रीम को टेबल में बदलने की आवश्यकता है।
- पाइपलाइन ओवरहेड = 1
- आपकी पाइपलाइन में एक ही DB है।
- सुविधाओं की संख्या = 1
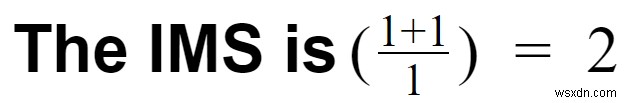
केस 2: इन इवेंट को प्रोसेस करने के लिए Kafka का उपयोग करना और फिर उन्हें RDBMS में संग्रहीत करना।
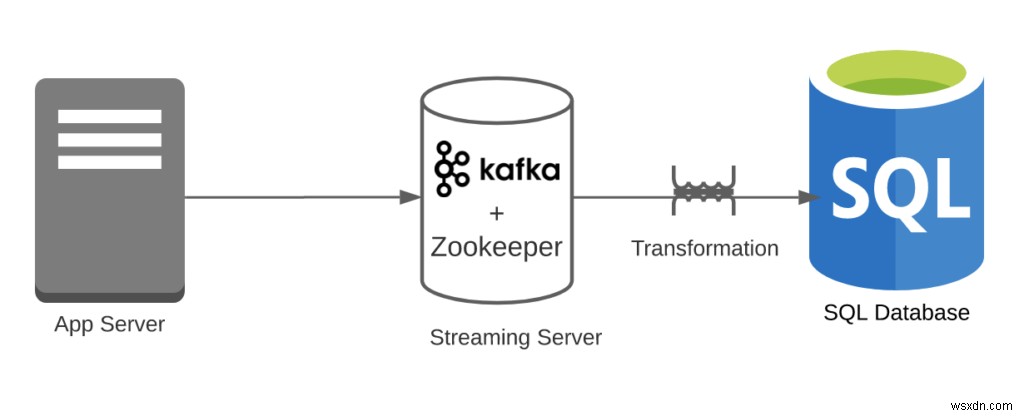
- ट्रांसफॉर्मेशनल ओवरहेड = 1
- Kafka क्लिक स्ट्रीम को आसानी से संभाल सकता है; हालांकि, Kafka से RDBMS एक ओवरहेड है।
- पाइपलाइन ओवरहेड = 2
- आपके पास दो सिस्टम हैं (RDBMS और Kafka)। ध्यान दें कि हम Zookeeper को नजरअंदाज कर रहे हैं।
- सुविधाओं की संख्या = 1
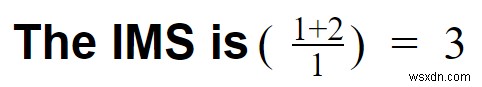
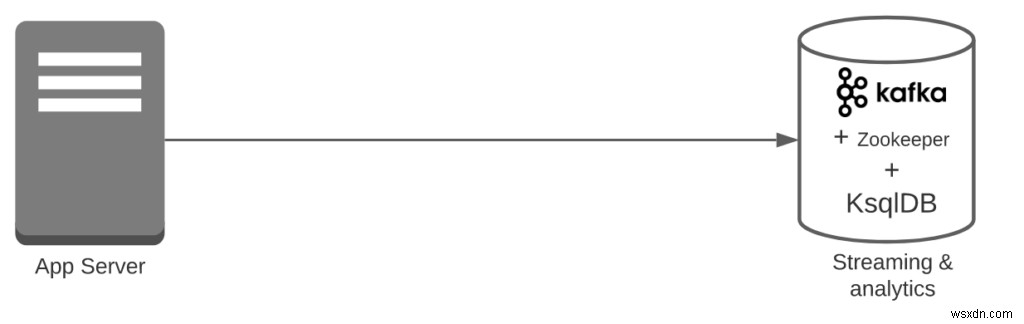
केस 3: इन इवेंट को प्रोसेस करने के लिए Kafka का उपयोग करना और फिर उन्हें KsqlDB में संग्रहीत करना।
- ट्रांसफॉर्मेशनल ओवरहेड = 0
- Kafka क्लिक स्ट्रीम को आसानी से संभाल सकता है
- पाइपलाइन ओवरहेड = 1
- आपके पास केवल एक सिस्टम है (Kafka + KSqlDB)। ध्यान दें कि हम Zookeeper को नजरअंदाज कर रहे हैं।
- सुविधाओं की संख्या = 1
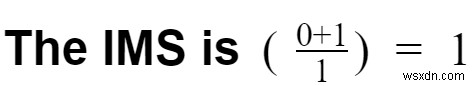
केस 4: इन इवेंट को प्रोसेस करने के लिए Redis Streams का उपयोग करना और फिर उन्हें RedisTimeSeries में संग्रहीत करना (दोनों Redis का हिस्सा हैं और Redis के साथ नेटिव रूप से काम करते हैं)।
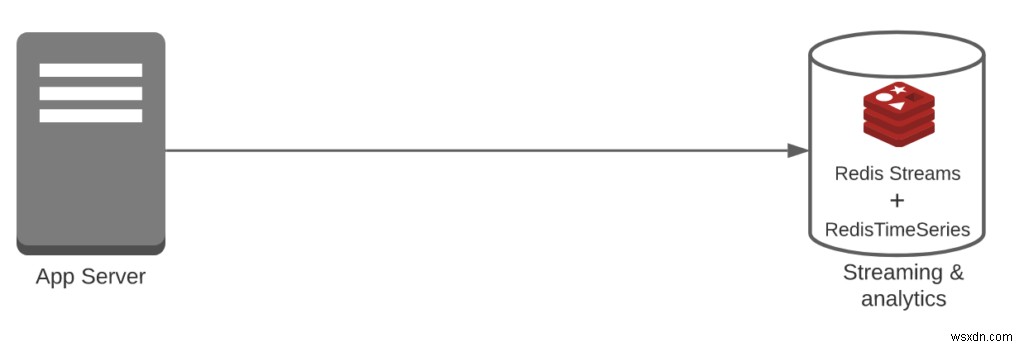
- ट्रांसफॉर्मेशनल ओवरहेड = 0
- Redis Streams क्लिक स्ट्रीम को आसानी से संभाल सकता है
- पाइपलाइन ओवरहेड = 1
- आपके पास केवल एक सिस्टम है (Redis Streams + RedisTimeSeries)
- सुविधाओं की संख्या = 1
चरण 1 के बाद निष्कर्ष:
हमने इस उदाहरण में चार सिस्टम की तुलना की और पाया कि "केस 3" या "केस 4" 1 के IMS के साथ सबसे सरल हैं। इस बिंदु पर, वे दोनों समान हैं, लेकिन क्या वे अधिक सुविधाएँ जोड़ने पर समान रहेंगे?
आइए अपने सिस्टम में अधिक सुविधाएँ जोड़ें और देखें कि IMS कैसे बना रहता है।
चरण 2: IP-व्हाइटलिस्टिंग के साथ रीयल-टाइम डैशबोर्ड बनाना
मान लें कि आप वही ऐप बना रहे हैं लेकिन यह सुनिश्चित करना चाहते हैं कि वे केवल व्हाइट-लिस्टेड IP पतों से आएं। अब आप एक नई सुविधा जोड़ रहे हैं।
केस 1: इन इवेंट को संग्रहीत करने के लिए केवल RDBMS का उपयोग करना, हालांकि टेबल फिट नहीं हो सकते और उन्होंने IP-व्हाइटलिस्टिंग के लिए Redis या MemCached का उपयोग किया।
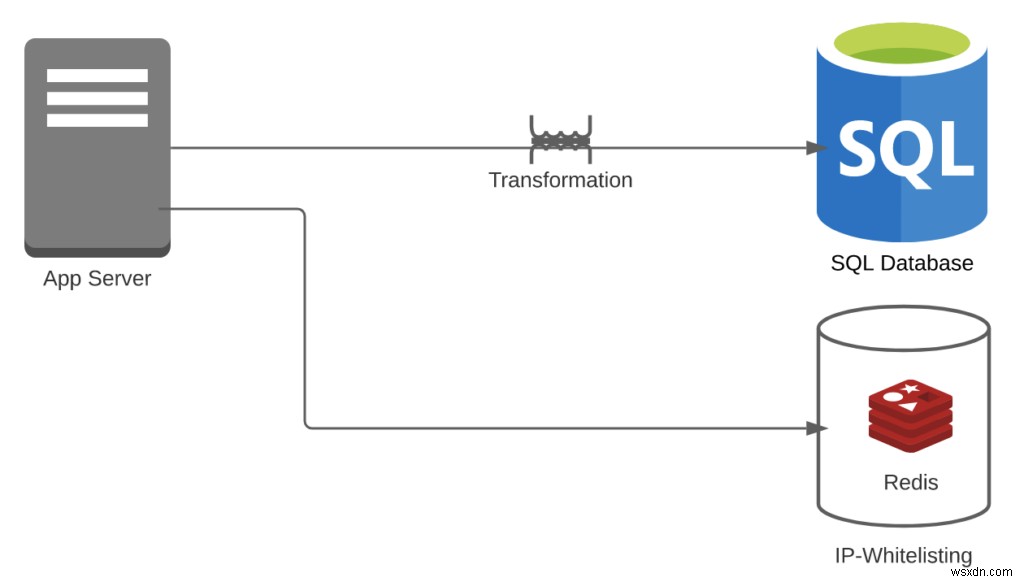
- ट्रांसफॉर्मेशनल ओवरहेड = 1
- IP-व्हाइटलिस्टिंग के लिए, आपको किसी परिवर्तन की आवश्यकता नहीं है। हालांकि, आपको इवेंट स्ट्रीम को टेबल में बदलने की आवश्यकता है
- पाइपलाइन ओवरहेड = 2
- आपके पास Redis + RDBMS है
- सुविधाओं की संख्या = 2
केस 2: Redis + Kafka + RDBMS का उपयोग करना।
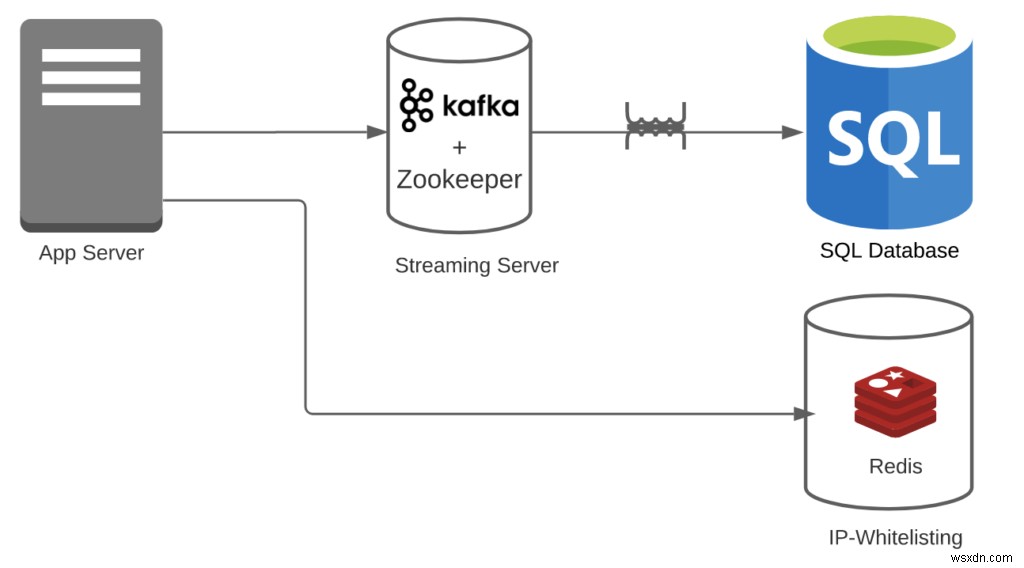
- ट्रांसफॉर्मेशनल ओवरहेड = 1
- IP-व्हाइटलिस्टिंग के लिए, आपको किसी परिवर्तन की आवश्यकता नहीं है। साथ ही, Kafka आसानी से स्ट्रीम को संभाल सकता है।
- पाइपलाइन ओवरहेड = 3
- आपके पास Redis + Kafka + RDBMS है। ध्यान दें: हम इस तथ्य को नजरअंदाज कर रहे हैं कि Kafka को Zookeeper की भी आवश्यकता है। यदि आप इसे जोड़ते हैं, तो संख्या और नीचे जाएगी।
- सुविधाओं की संख्या = 2
केस 3: Redis + Kafka + KsqlDB का उपयोग करना।
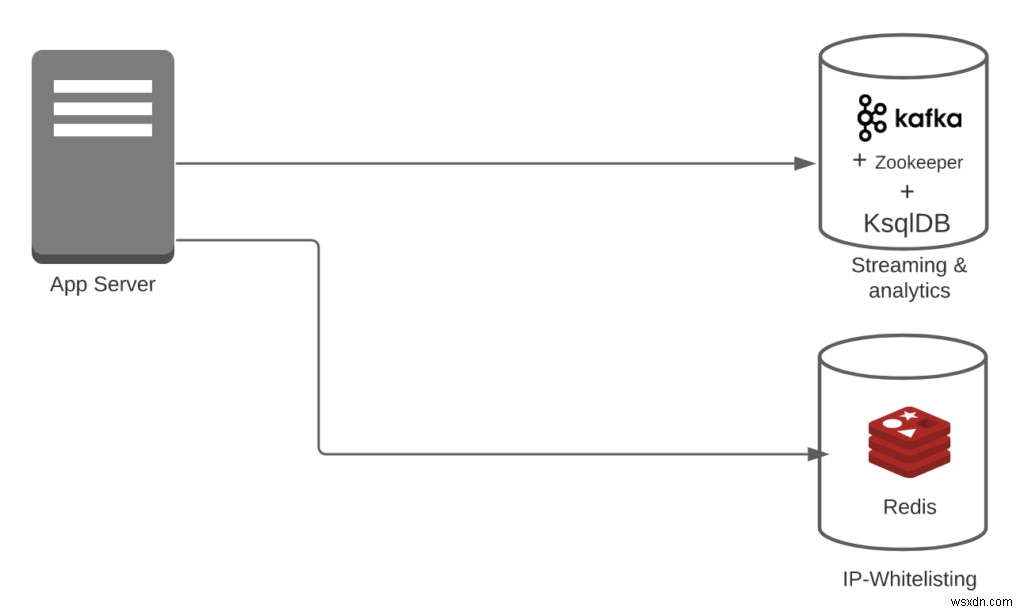
- ट्रांसफॉर्मेशनल ओवरहेड = 0
- IP-व्हाइटलिस्टिंग के लिए, आपको किसी परिवर्तन की आवश्यकता नहीं है। साथ ही, Kafka और KsqlDB आसानी से स्ट्रीम को संभाल सकते हैं।
- पाइपलाइन ओवरहेड = 2
- आपके पास Redis + (Kafka + KsqlDB) है। ध्यान दें: इस मामले में, हम Kafka + KsqlDB को एक ही सिस्टम का हिस्सा मान रहे हैं।
- सुविधाओं की संख्या = 2
केस 4: Redis + Redis Streams + RedisTimeSeries का उपयोग करना।
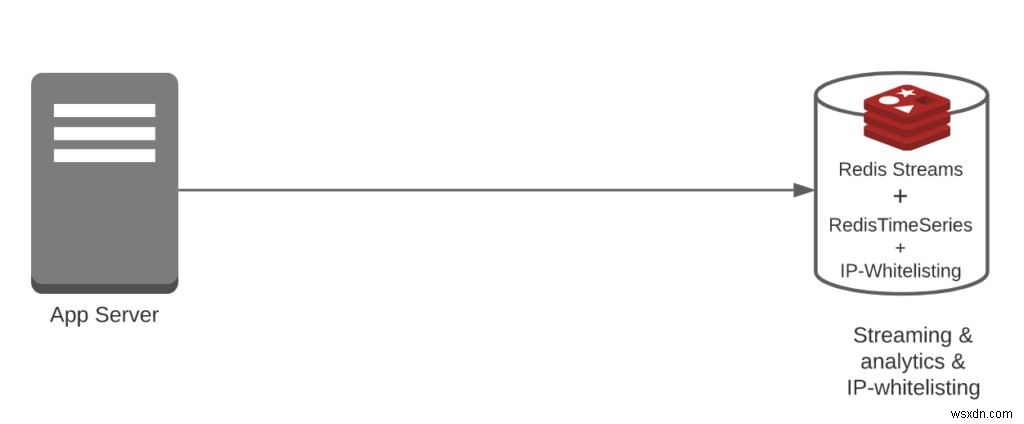
- ट्रांसफॉर्मेशनल ओवरहेड = 0
- IP-व्हाइटलिस्टिंग के लिए, आपको किसी परिवर्तन की आवश्यकता नहीं है। साथ ही, Redis Streams और RedisTimeSeries आसानी से स्ट्रीम और अलर्ट को संभाल सकते हैं।
- पाइपलाइन ओवरहेड = 1
- आपके पास Redis + Redis Streams + Redis TimeSeries है। ध्यान दें: इस मामले में, सभी तीन एक ही सिस्टम का हिस्सा हैं।
- सुविधाओं की संख्या = 2
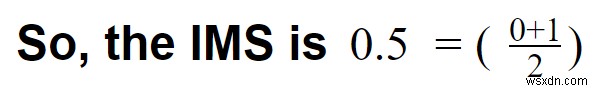
चरण 2 के बाद निष्कर्ष:
जब हमने एक अतिरिक्त सुविधा जोड़ी,
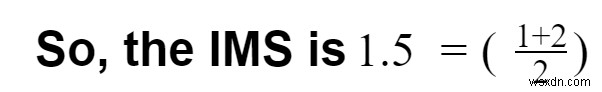
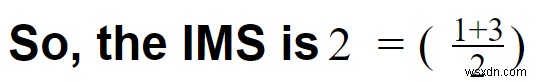
- केस 1 चरण-1 में 2 पर था और घटकर 1.5 हो गया।
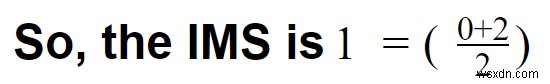
- केस 2 चरण-1 में 3 पर था और घटकर 2 हो गया
- केस 3 चरण-1 में 1 पर था और 1 पर रहा
- केस 4 चरण-1 में 1 पर था और घटकर 0.5 हो गया (सर्वश्रेष्ठ)
इसलिए हमारे उदाहरण में, केस 4, जिसका चरण-1 में सबसे कम IMS स्कोर 1 था, वास्तव में नई सुविधा जोड़ने पर बेहतर हो गया और 0.5 पर समाप्त हुआ।
कृपया ध्यान दें: यदि आप अधिक या अलग सुविधाएँ जोड़ते हैं, तो केस 4 सबसे सरल नहीं रह सकता है। लेकिन यही IMS स्कोर का विचार है। बस सभी सुविधाओं को सूचीबद्ध करें, विभिन्न आर्किटेक्चर की तुलना करें, और देखें कि आपके उपयोग के मामले के लिए कौन सा सबसे अच्छा है।
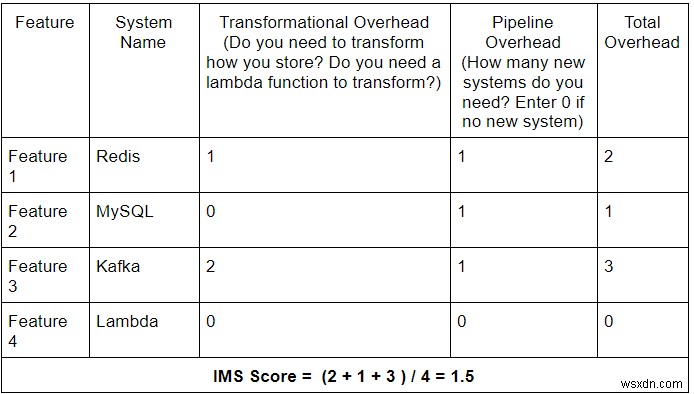
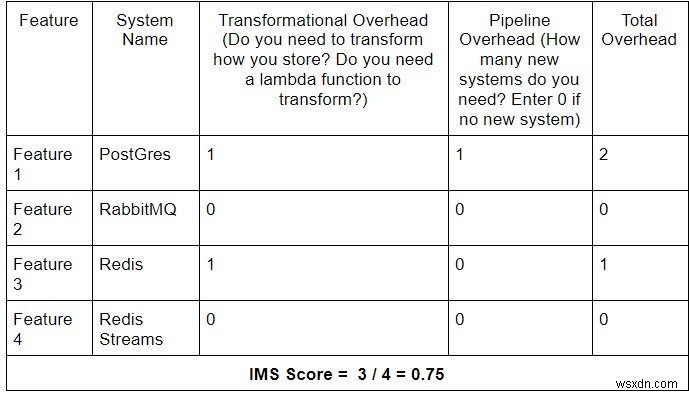
इसे उपयोग करने के लिए और भी सरल बनाने के लिए, हम आपको एक कैलकुलेटर प्रदान कर रहे हैं जिसे आप एक साधारण स्प्रेडशीट में IMS स्कोर की गणना करने के लिए लागू कर सकते हैं।
IMS कैलकुलेटर
यहां इसका उपयोग कैसे करें:
- प्रत्येक डेटा लेयर या डेटा पाइपलाइन के लिए, बस सूचीबद्ध करें:
- वर्तमान में आपके पास जो सुविधाएँ हैं।
- रोडमैप में जो सुविधाएँ हैं। यह महत्वपूर्ण है, क्योंकि आप यह सुनिश्चित करना चाहते हैं कि आपका डेटा लेयर बिना किसी अतिरिक्त ओवरहेड के आगामी सुविधाओं का समर्थन करना जारी रख सके।
- फिर प्रत्येक सुविधा के लिए ट्रांसफॉर्मेशनल ओवरहेड और पाइपलाइन ओवरहेड को मैप करें।
- और अंत में, सभी ओवरहेड के योग को सुविधाओं की संख्या से विभाजित करें।
- विभिन्न सिस्टम के साथ पाइपलाइनों की तुलना और विपरीत करने के लिए चरण 2 और 3 को दोहराएं।
सारांश
परिणामों के बारे में सोचे बिना एक जटिल डेटा लेयर बनाने में बह जाना बहुत आसान है। IMS स्कोर आपको अपने निर्णय के प्रति जागरूक होने में मदद करने के लिए बनाया गया था।
आप अपने उपयोग के मामले के लिए कई सिस्टम की तुलना और विपरीत करने के लिए IMS स्कोर का आसानी से उपयोग कर सकते हैं और देख सकते हैं कि आपकी सुविधाओं के सेट के लिए वास्तव में कौन सा सबसे अच्छा है। आप यह भी सत्यापित कर सकते हैं कि क्या आपका सिस्टम सुविधा विस्तार तक टिक सकता है और यथासंभव सरल रह सकता है।
हमेशा याद रखें:
"सादगी परम परिष्कार है" — लियोनार्डो दा विंची
"अधिकांश जानकारी अप्रासंगिक है और अधिकांश प्रयास व्यर्थ है, लेकिन केवल विशेषज्ञ जानता है कि क्या अनदेखा करना है" — जेम्स क्लियर, एटॉमिक हैबिट्स