मान लीजिए हम एक बाइनरी सर्च ट्री को सीरियलाइज़ और डीसीरियलाइज़ करने के लिए एक एल्गोरिदम डिज़ाइन करना चाहते हैं। सीरियलाइज़ेशन किसी डेटा संरचना या ऑब्जेक्ट को बिट्स के अनुक्रम में बदलने की प्रक्रिया है ताकि इसे फ़ाइल या मेमोरी बफर में संग्रहीत किया जा सके, या नेटवर्क कनेक्शन लिंक पर प्रसारित किया जा सके। बाद में इसे पुनर्निर्मित किया जा सकता है, वह प्रक्रिया डीसीरियलाइज़ेशन है।
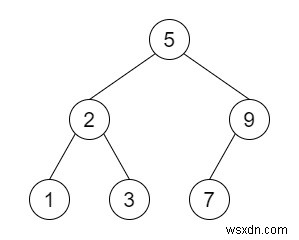
उदाहरण के लिए, यदि इनपुट [5,2,9,1,3,7] है, तो आउटपुट होगा: सीरियलाइज़्ड आउटपुट 5.2.9.1.3.7.N.N.N.N.N.N.N, डीसीरियलाइज़्ड आउटपुट: 1, 2, 3, 5, 7, 9 (इनऑर्डर ट्रैवर्सल)।
इसे हल करने के लिए, हम निम्न चरणों का पालन करेंगे:
- एक फ़ंक्शन serialize() परिभाषित करें। यह root लेगा
- res := एक नई सूची
- एक क्यू परिभाषित करें और root डालें
- जब तक क्यू खाली न हो, करें
- जब तक क्यू खाली न हो, करें
- current := queue[0]
- current को res के अंत में डालें
- क्यू से पहला तत्व हटाएं
- यदि current नॉन-ज़ीरो है, तो
- लूप से बाहर निकलें
- यदि current null है, तो
- लूप से बाहर निकलें
- यदि current.left null नहीं है, तो
- current.left को क्यू के अंत में डालें
- अन्यथा,
- क्यू के अंत में None डालें
- यदि current.right null नहीं है, तो
- current.right को क्यू के अंत में डालें
- अन्यथा,
- क्यू के अंत में None डालें
- जब तक क्यू खाली न हो, करें
- s:= खाली स्ट्रिंग
- i को 0 से res के आकार तक रेंज में, करें
- यदि res[i] नॉन-ज़ीरो है, तो
- s := s concatenate res[i].data
- अन्यथा,
- s := s concatenate "N"
- यदि i res के आकार -1 के समान है, तो
- लूप से बाहर निकलें
- s := s concatenate "."
- यदि res[i] नॉन-ज़ीरो है, तो
- s लौटाएं
- एक फ़ंक्शन deserialize() परिभाषित करें। यह data लेगा
- data := डॉट का उपयोग करके data को विभाजित करने के बाद भागों की एक सूची
- stack := एक नई सूची
- यदि data[0] 'N' के समान है, तो
- None लौटाएं
- root := data[0] डेटा के साथ एक नया नोड बनाएं
- root को stack के अंत में डालें
- i := 1
- current := 0
- जब तक i < data का आकार, करें
- left:= False
- यदि data[i] 'N' के समान नहीं है, तो
- temp := data[i] डेटा के साथ एक नया नोड बनाएं
- stack[current].left := temp
- temp को stack के अंत में डालें
- अन्यथा,
- stack[current].left := None
- i := i + 1
- यदि data[i] 'N' के समान नहीं है, तो
- temp := data[i] डेटा के साथ एक नया नोड बनाएं
- stack[current].right := temp
- temp को stack के अंत में डालें
- अन्यथा,
- stack[current].right := None
- current := current + 1
- i := i + 1
- root लौटाएं
उदाहरण
बेहतर समझ के लिए निम्न कार्यान्वयन देखें:
class TreeNode:    def __init__(self, data, left = None, right = None):       self.data = data       self.left = left       self.right = right def insert(temp,data):    que = []    que.append(temp)    while (len(que)):       temp = que[0]       que.pop(0)       if (not temp.left):          if data is not None:             temp.left = TreeNode(data)          else:             temp.left = TreeNode(0)          break       else:          que.append(temp.left)       if (not temp.right):          if data is not None:             temp.right = TreeNode(data)          else:             temp.right = TreeNode(0)          break       else:          que.append(temp.right) def make_tree(elements):    Tree = TreeNode(elements[0])    for element in elements[1:]:       insert(Tree, element)    return Tree def print_tree(root):    # इनऑर्डर ट्रैवर्सल का उपयोग करके प्रिंट करें    if root is not None:       print_tree(root.left)       print(root.data, end = ', ')       print_tree(root.right) class Codec:    def serialize(self, root):       res =[]       queue = [root]       while queue:          while True and queue:             current = queue[0]             res.append(current)             queue.pop(0)             if current:                break          if not current:             break          if current.left:             queue.append(current.left)          else:             queue.append(None)          if current.right:             queue.append(current.right)          else:             queue.append(None)       s=""       for i in range(len(res)):          if res[i]:             s+=str(res[i].data)          else:             s+="N"          if i == len(res)-1:             break          s+="."       return s    def deserialize(self, data):       data = data.split(".")       stack = []       if data[0]=='N':          return None       root = TreeNode(int(data[0]))       stack.append(root)       i = 1       current = 0       while i
इनपुट
[5,2,9,1,3,7]
आउटपुट
Serialization: 5.2.9.1.3.7.N.N.N.N.N.N.N 1, 2, 3, 5, 7, 9,