PySpark SQL क्वेरी के परिणामों को Matplotlib का उपयोग करके विज़ुअलाइज़ करने के लिए निम्नलिखित चरणों का पालन करें। यह प्रक्रिया बड़े डेटासेट पर SQL क्वेरी चलाने और परिणामों को चार्ट में बदलने के लिए उपयोगी है।
आवश्यक चरण
- फिगर का आकार सेट करें और सबप्लॉट के बीच पैडिंग समायोजित करें।
- Spark कार्यक्षमता के लिए मुख्य एंट्री पॉइंट (SparkContext) प्राप्त करें।
- Hive में संग्रहीत डेटा के साथ एकीकृत Spark SQL का इंस्टेंस (HiveContext) प्राप्त करें।
- ट्यूपल के रूप में रिकॉर्ड की एक सूची बनाएं।
- स्थानीय पायथन संग्रह को वितरित करके RDD बनाएं।
- सूची रिकॉर्ड को डेटाबेस स्कीमा (Row ऑब्जेक्ट) में मैप करें।
- स्कीमा इंस्टेंस बनाकर "my_table" में प्रवेश करें।
- टेबल में रिकॉर्ड डालें।
- SQL क्वेरी पढ़ें और रिकॉर्ड प्राप्त करें।
- प्राप्त रिकॉर्ड को पांडास डेटाफ्रेम में बदलें।
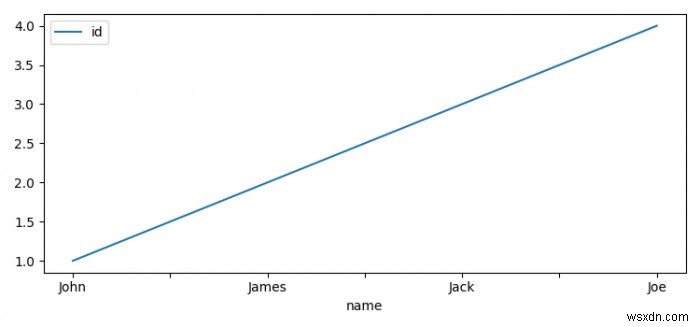
- 'name' विशेषता के साथ इंडेक्स सेट करें और प्लॉट करें।
- फिगर प्रदर्शित करने के लिए show() मेथड का उपयोग करें।
उदाहरण कोड
from pyspark.sql import Row
from pyspark.sql import HiveContext
import pyspark
import matplotlib.pyplot as plt

plt.rcParams["figure.figsize"] = [7.50, 3.50]
plt.rcParams["figure.autolayout"] = True

sc = pyspark.SparkContext()
sqlContext = HiveContext(sc)

test_list = [(1, 'John'), (2, 'James'), (3, 'Jack'), (4, 'Joe')]
rdd = sc.parallelize(test_list)
people = rdd.map(lambda x: Row(id=int(x[0]), name=x[1]))
schemaPeople = sqlContext.createDataFrame(people)
sqlContext.registerDataFrameAsTable(schemaPeople, "my_table")

df = sqlContext.sql("Select * from my_table")
df = df.toPandas()
df.set_index('name').plot()
plt.show()
आउटपुट
उपरोक्त कोड एक बार चार्ट उत्पन्न करेगा जहां X-अक्ष पर नाम और Y-अक्ष पर संबंधित ID मान दिखाए जाएंगे।