
यदि आप AI और तकनीक में नए विकास का पालन करते हैं, तो आपने स्थानीय बड़े भाषा मॉडल, या LLM, सेटअप की सिफारिश करने वाले ढेर सारे तकनीकी प्रभावशाली लोगों को देखा होगा। जब मैंने अपने PC पर पूरी तरह से चलने वाले गोपनीयता-केंद्रित LLM का विचार सुना, तो मैं उत्साहित हो गया और इसे तुरंत आज़माया। बात यह है - जबकि एक स्थानीय LLM के कुछ बहुत विशिष्ट उपयोग के मामलों में लाभ हैं, यह आपके वर्कस्टेशन पर चलते हुए ChatGPT या किसी अन्य बड़ी तकनीक AI को प्रतिस्थापित नहीं करने वाला है। मैं समझाता हूं क्यों...
विषय सूची
लोकल LLM बनाम ChatGPT: वास्तविकता जांच
पहला और सबसे महत्वपूर्ण बॉटलनेक जिसका आप सामना करेंगे वह है हार्डवेयर सीमा। मैं एक औसत नॉन-गेमिंग लैपटॉप उपयोगकर्ता हूं जिसके पास 64 GB 3200 MHz RAM के साथ Dell Latitude 5520 लैपटॉप और दो NVMe M.2 SSDs हैं जिनमें 1 TB से अधिक तेज़ स्टोरेज है। हालांकि, इस बॉलपार्क में अधिकांश वर्कस्टेशन में एक समर्पित GPU की कमी होती है या बॉक्स से बाहर एक लो-एंड वाला होता है।
स्थानीय LLMs चलाने की बात यह है कि वे RAM और स्टोरेज पर कम और आपके PC की कंप्यूटिंग शक्ति पर अधिक निर्भर करते हैं, यानी CPU और GPU। इसलिए, इंटेल इंटीग्रेटेड ग्राफिक्स के साथ मेरा i7 प्रोसेसर बड़े मल्टी-मोडल मॉडल नहीं चला सकता। शुक्र है, मेरे पास अभी भी कई विकल्प थे, जैसे lfm2.5-thinking:1.2b, ministral-3:3b, और granite4:3b, साथ ही अधिक लोकप्रिय llama3 और phi3 मॉडल।
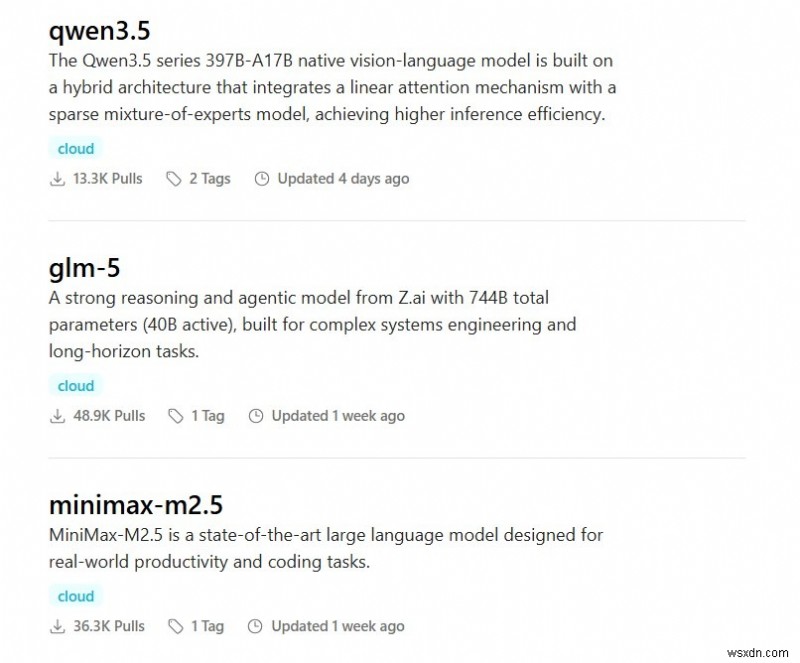
अब, तुलना को परिप्रेक्ष्य में रखने के लिए कुछ गणित करते हैं। मेरे जैसे औसत PC पर चलने वाला एक lfm2.5, जो अनिवार्य रूप से एक छोटा भाषा मॉडल (SLM) है, की दो बड़ी सीमाएं हैं: बहुत कम कंप्यूटिंग शक्ति और SLM का स्वयं का एक छोटा पैरामीटर काउंट, या मस्तिष्क। तुलना में, ChatGPT जैसे क्लाउड LLMs सेकंड में टेराबाइट्स डेटा प्रोसेस करते हुए शाब्दिक सुपरकंप्यूटर्स पर चलते हैं।
उस गणित को ध्यान में रखते हुए, आइए एक स्थानीय lfm2.5-thinking:1.2b और ChatGPT के मुफ्त संस्करण की कुछ प्रतिक्रियाओं को देखें। आपको सीमाएं दिखाने के बाद, हम उन उपयोग के मामलों को भी देखेंगे जहां एक स्थानीय SLM वास्तव में वाणिज्यिक LLMs को मात देता है।
लॉजिक टेस्ट: जहां स्थानीय LLM विफल हुआ
नोट: इस तुलना का उद्देश्य स्थानीय LLMs की आलोचना करना नहीं है — हाई-एंड PC पर सेट अप किए गए स्थानीय LLMs अद्भुत काम कर सकते हैं। लेकिन मेरा इरादा औसत उपयोगकर्ता को, जैसे मुझे, यह दिखाना है कि लो-टू-मिड-रेंज PC पर चलने वाला एक स्थानीय भाषा मॉडल ChatGPT या Gemini के बराबर परिणाम नहीं देगा।
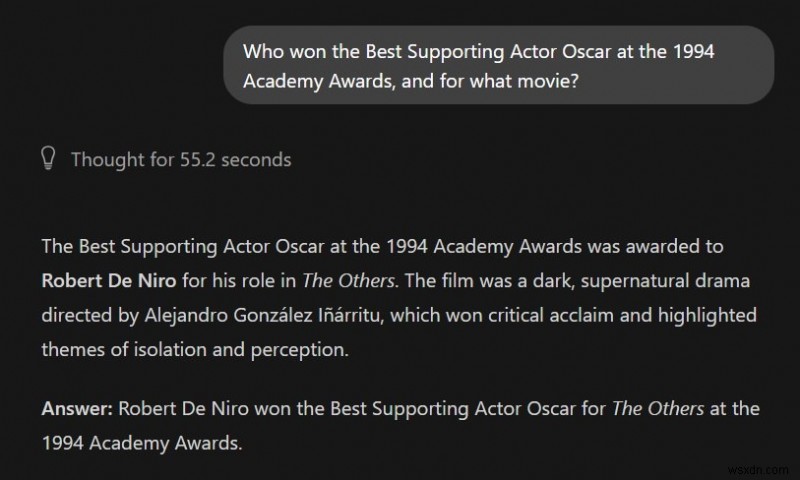
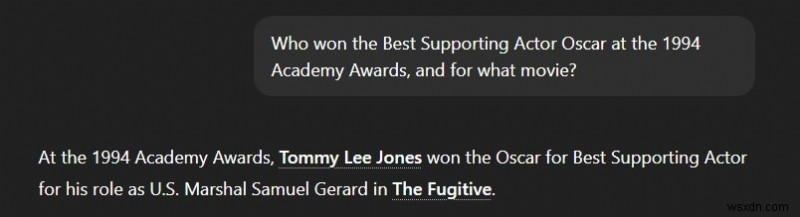
1. "ट्रिविया शून्य" प्रॉम्प्ट:
एक छोटे मॉडल में पूरे विकिपीडिया डेटाबेस को संग्रहीत करने के लिए पैरामीटर काउंट नहीं होता। जब आप इससे एक विशिष्ट ऐतिहासिक तथ्य पूछते हैं, तो यह नहीं कहेगा, "मुझे नहीं पता" — यह सबसे अधिक संभावना है कि मतिभ्रम करेगा।
स्थानीय LLM: गलत, मतिभ्रम उत्तर
ChatGPT: सही उत्तर
2. "टोन विफलता" प्रॉम्प्ट:
छोटे स्थानीय मॉडल आमतौर पर भावनात्मक बारीकियों के साथ संघर्ष करते हैं। वे आक्रामक रूप से रोबोटिक और अत्यधिक निष्क्रिय आउटपुट के बीच बेतहाशा झूलते हैं क्योंकि उनके पास मानव सामाजिक अनुग्रह को समझने के लिए पर्याप्त पैरामीटर नहीं होते।
स्थानीय LLM: बहुत कठोर और बेअदब
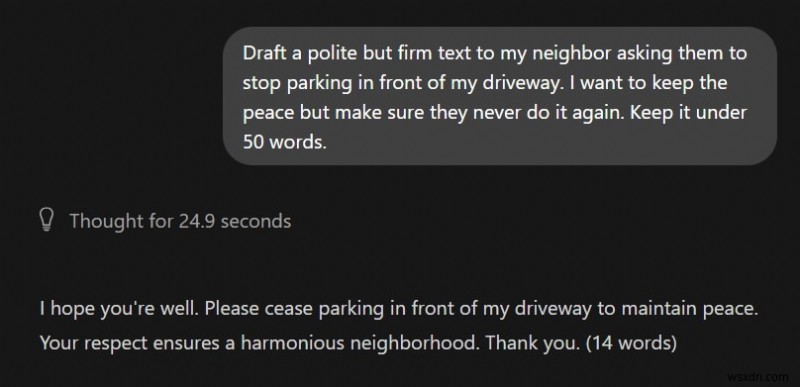
ChatGPT: पूर्ण नहीं, लेकिन स्वीकार्य
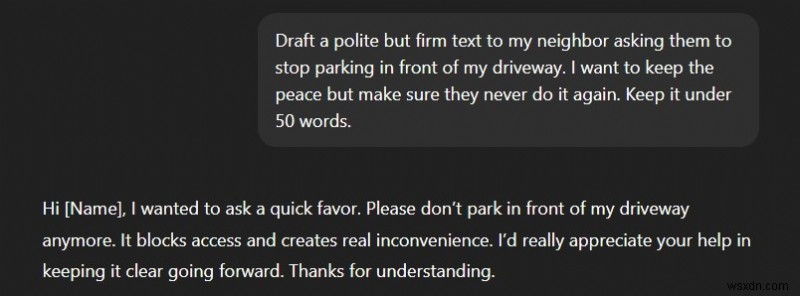
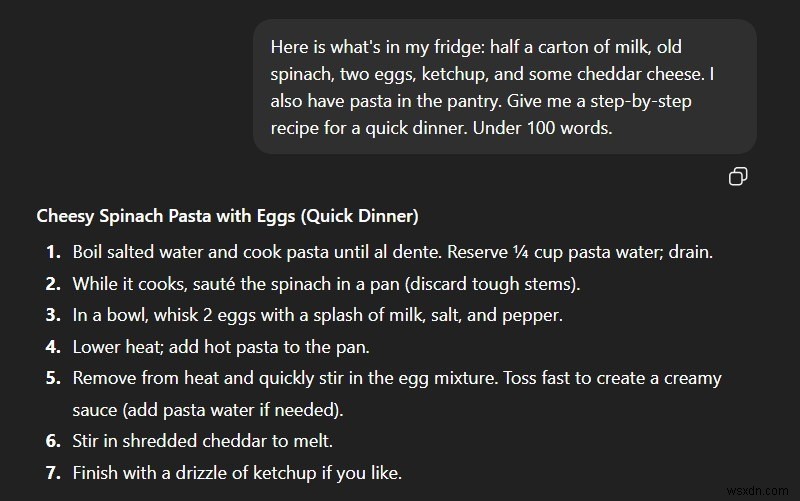
3. "अव्यवस्थित इनपुट विफलता" प्रॉम्प्ट:
हम हमेशा अपने प्रश्नों को सावधानीपूर्वक प्रारूपित और संरचित नहीं करते। स्थानीय SLMs को संरचित प्रतिक्रियाएं प्रदान करने के लिए संरचित प्रॉम्प्ट की आवश्यकता होती है — अन्यथा, वे सब कुछ गड़बड़ कर देते हैं।
स्थानीय LLM: बहुत अस्पष्ट और उपयोगी नहीं
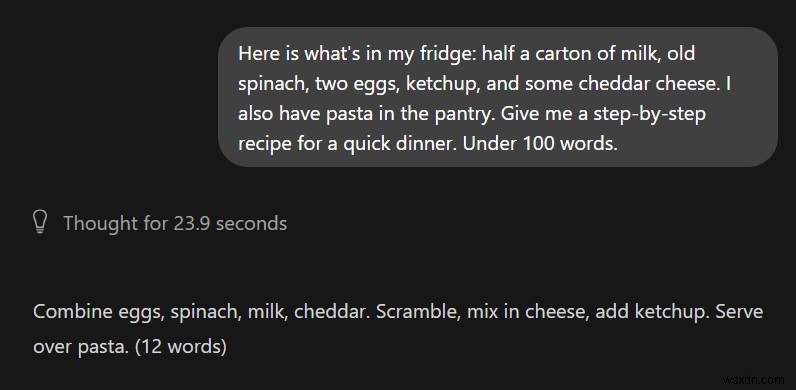
ChatGPT: एक विस्तृत चरण-दर-चरण समाधान
4. "इसे समझाओ जैसे मैं X हूं" विफलता प्रॉम्प्ट:
एक जटिल अमूर्त अवधारणा को पूरी तरह से असंबंधित विषय पर मैप करने के लिए भारी कंप्यूटिंग शक्ति की आवश्यकता होती है। दो अलग-अलग डोमेन को मर्ज करने की कोशिश करते समय छोटे मॉडल अक्सर प्लॉट खो देते हैं।
स्थानीय LLM: कोई मतलब नहीं निकलता
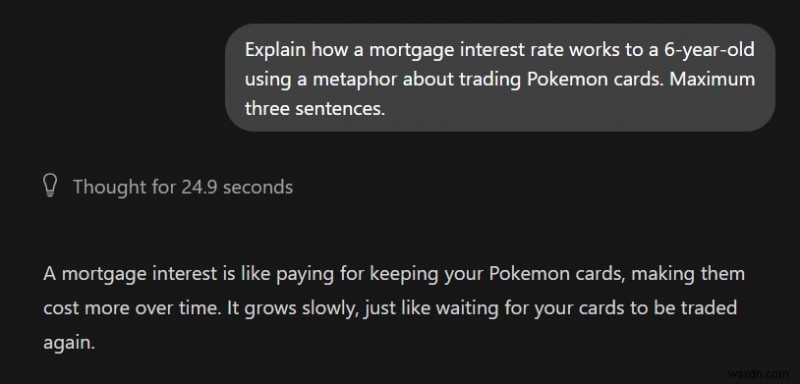
ChatGPT: सादृश्य का सही उपयोग
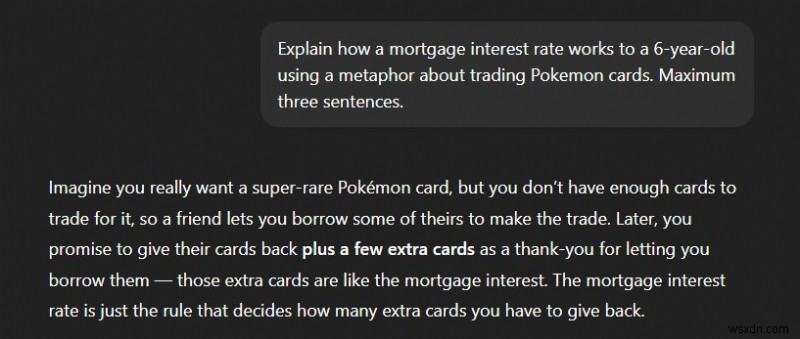
5. "संदर्भ शून्य" प्रॉम्प्ट:
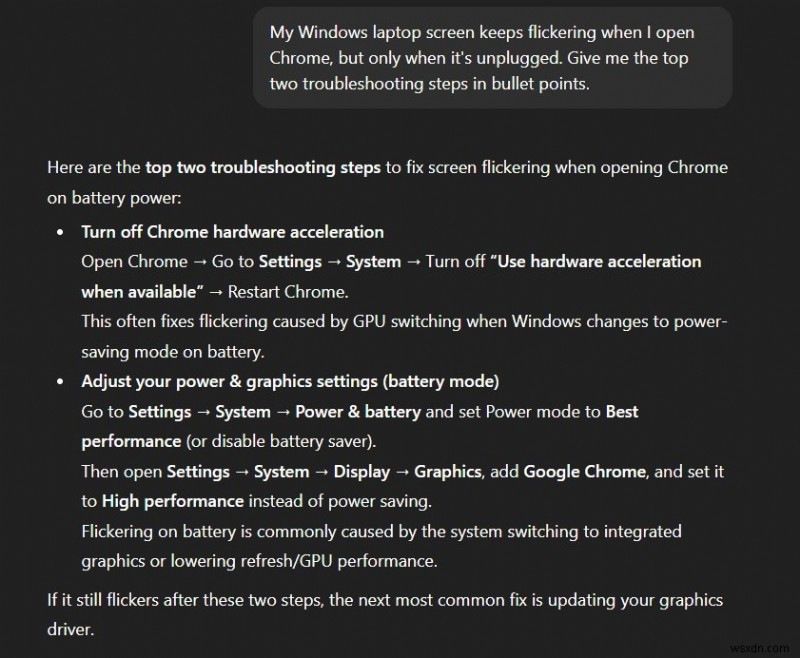
जब आप एक अस्पष्ट तकनीकी प्रश्न पूछते हैं, तो क्लाउड मॉडल अपने विशाल प्रशिक्षण डेटा का उपयोग सबसे आम आधुनिक समाधानों का अनुमान लगाने के लिए करते हैं। छोटे स्थानीय मॉडल ज्यादातर सामान्य, पुरानी सलाह देते हैं।
स्थानीय LLM: सामान्य समाधान
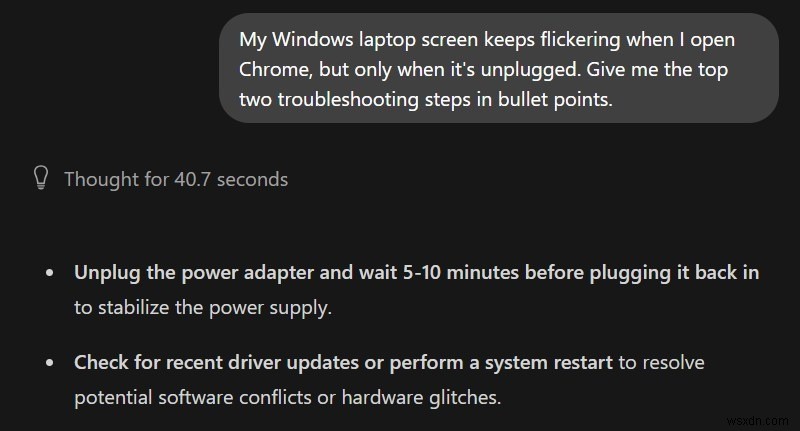
ChatGPT: समस्या को हल करने की अधिक संभावना
'संदर्भ' समस्या
मेरे स्थानीय SLM सेटअप के साथ एक और बड़ी समस्या तब सामने आई जब बातचीत कुछ सवालों से अधिक लंबी चली। फिर से, 64 GB RAM पर्याप्त था, लेकिन प्रोसेसिंग पावर मुख्य बॉटलनेक थी। पंखा वास्तव में जोर से घूमने लगा, लैपटॉप गर्म हो गया, और Ollama को प्रतिक्रिया देने में बहुत अधिक समय लगने लगा, कभी-कभी फ्रीज भी हो जाता था। इसलिए, अपने PC को पिघलने से बचाने के लिए, स्थानीय AI ऐप्स मॉडल की मेमोरी को काफी हद तक सीमित कर देते हैं।
यदि आप ChatGPT या Gemini के साथ लंबी बातचीत करने के आदी हैं तो यह समस्या एक बड़ा डीलब्रेकर हो सकती है — यह निश्चित रूप से मेरे लिए थी। जैसा कि पहले चर्चा की गई, वे क्लाउड LLMs अल्ट्रा-फास्ट सर्वर्स पर चलते हैं जो अत्याधुनिक GPUs द्वारा संचालित होते हैं, जिससे उन्हें बड़े संदर्भ विंडो को आसानी से संभालने की क्षमता मिलती है।
जब स्थानीय AI वास्तव में जीतता है
इस बिंदु पर, आप सोच रहे होंगे कि एक स्थानीय LLM व्यावहारिक रूप से बेकार है, लेकिन रुकिए, बहुत सारी स्थितियां हैं जहां वे वास्तव में सुपर काम आते हैं। यहां कुछ उदाहरण हैं:
'डिजिटल सेफ' (पूर्ण गोपनीयता)
 छवि स्रोत: Freepik AI
यदि आप गोपनीय दस्तावेजों पर काम कर रहे हैं जिन्हें आप ChatGPT या Gemini के सर्वर पर अपलोड नहीं करना चाहते हैं, तो एक स्थानीय LLM उन फाइलों को संसाधित करने के लिए आपका 100% निजी समाधान है। या आप बस इसके साथ अपनी व्यक्तिगत समस्याओं के बारे में बात कर सकते हैं बिना किसी मानव मॉडरेटर के चिंता किए जो आपके निजी मामलों को "AI की प्रतिक्रियाओं में सुधार" के लिए पढ़ रहा हो।
'एयरप्लेन मोड' सहायक
क्लाउड AI को काम करने के लिए लगातार इंटरनेट कनेक्शन की आवश्यकता होती है। यह आमतौर पर कोई समस्या नहीं है, दुनिया के अधिकांश हिस्सों में विश्वसनीय कनेक्टिविटी के लिए धन्यवाद। हालांकि, ऐसी स्थितियां हैं जहां इंटरनेट उपलब्ध नहीं है या आप बस इससे कनेक्ट नहीं करना चाहते हैं। तभी एक स्थानीय LLM संभावित रूप से दिन बचा सकता है।
बिना फ़िल्टर वाला रचनात्मक लेखक
अधिकांश वाणिज्यिक AI चैटबॉट इसे जनता के लिए उपयुक्त बनाने के लिए एक फ़िल्टर्ड अनुभव प्रदान करते हैं। यदि आप किसी रचनात्मक प्रोजेक्ट पर काम कर रहे हैं, जैसे अपराध उपन्यास, तो यह विशेष रूप से कमजोर करने वाला हो सकता है। सभी मुफ्त भाषा मॉडल उन प्रकार की अनफ़िल्टर्ड प्रतिक्रियाएं प्रदान नहीं करते हैं, लेकिन कुछ अनसेंसर्ड वाले हैं जिन्हें आप आज़मा सकते हैं।
असली "शून्य लागत" सहायक
 छवि स्रोत: Freepik AI
एक बार जब आप Ollama या GPT4ALL जैसे ऐप सेट अप करते हैं, तो आपको वास्तव में सब्सक्रिप्शन-मुक्त, असीमित समाधान मिलता है। आप बिना किसी कष्टप्रद दैनिक सीमा को पार किए जितना चाहें उतना उपयोग कर सकते हैं। यदि आप अपनी अपेक्षाओं को चर्चा की गई स्थानीय SLM सेटअप की सीमाओं के भीतर रखते हैं, तो यह आपकी कम से कम कुछ प्रीमियम AI सब्सक्रिप्शन छोड़ने का एक अच्छा तरीका है, सभी नहीं।
अल्टीमेट रोलप्ले समाधान
यदि आप कुछ टर्मिनल कमांड के साथ टिंकर करने में सहज हैं, तो आप संभावित रूप से अपने स्थानीय LLM को एक विषय विशेषज्ञ के रूप में कार्य करने के लिए अनुकूलित कर सकते हैं। उदाहरण के लिए, आप इसे एक कंटेंट एडिटर, एक कॉपीराइटर, एक कानूनी सलाहकार, या शाब्दिक रूप से किसी भी पेशेवर की तरह कार्य करने के लिए बना सकते हैं जो आप चाहते हैं।
निजी वेब सहायक
यह थोड़ा उन्नत उपयोग का मामला है, लेकिन आप अपने स्थानीय LLM को Harpa AI जैसे वेब सहायक ब्राउज़र एक्सटेंशन से जोड़ सकते हैं। इस तरह आप एक ऑफलाइन, गोपनीयता-केंद्रित AI ब्राउज़र अनुभव प्राप्त कर सकते हैं जो Perplexity Comet और ChatGPT Atlas जैसे प्रीमियम उत्पाद अक्सर कॉर्पोरेट डेटा निगरानी के साथ प्रदान करते हैं।
हाइब्रिड सेटअप ही असली जवाब है
इस पूरे अनुभव से गुजरने के बाद जिसे मैंने आपके साथ साझा किया है, मैं इस निष्कर्ष पर पहुंचा हूं कि एक हाइब्रिड AI सेटअप इसके बारे में जाने का सबसे अच्छा तरीका है। एक स्थानीय SLM को संभाल कर रखना उपयोगी है, जब भी मुझे निजी अनुभव की आवश्यकता होती है तो इसे चालू करने के लिए तैयार। हालांकि, सामान्य-उद्देश्य, अनुसंधान-भारी कार्यों के लिए, मैं Gemini Pro का उपयोग करना पसंद करता हूं। इस तरह, मुझे दोनों दुनियाओं का सर्वश्रेष्ठ मिलता है, दोनों अद्भुत प्रौद्योगिकियों का पूरा उपयोग करते हुए।
वैसे, Ollama और GPT4ALL आपके एकमात्र विकल्प नहीं हैं। Open WebUI एक स्थानीय LLM सेट अप करने का एक और आसान तरीका है।


