परिचय
C भाषा में फ़ाइलों को पढ़ने के लिए कई फ़ंक्शन हैं, जिनमें सबसे अधिक उपयोग किए जाने वाले read() और fread() फ़ंक्शन हैं। यह भाषा getchar() जैसे फ़ंक्शन के साथ वर्ण दर वर्ण पढ़ने के तरीके भी प्रदान करती है।
फ़ाइल प्रोसेसिंग फ़ंक्शन, उनके कॉल मेथड, इनपुट और आउटपुट आर्गुमेंट आदि को जानना महत्वपूर्ण है ताकि उनका कुशलतापूर्वक उपयोग किया जा सके क्योंकि वे प्रोग्रामर के लिए सिस्टम में संग्रहीत जानकारी को संग्रहीत और निपटाने के लिए उपलब्ध संसाधन हैं।
इस LinuxHint लेख में, आप सीखेंगे कि फ़ाइलों को पढ़ने के लिए read() फ़ंक्शन का उपयोग कैसे करें।
हम इस फ़ंक्शन के बारे में सब कुछ समझाएंगे: इसका सिंटैक्स, कॉल मेथड, इनपुट और आउटपुट आर्गुमेंट, वे प्रत्येक किस प्रकार के डेटा को स्वीकार करते हैं, और उन्हें सही तरीके से कैसे घोषित करें।
फिर हम व्यावहारिक उदाहरणों में इस सुविधा के उपयोग को लागू करके सीखे हुए को लागू करेंगे।
ताकि आप read() फ़ंक्शन का उपयोग करने के तरीके से पूरी तरह अवगत हों, हमने एक विशेष खंड जोड़ा है जो इस फ़ंक्शन का उपयोग करते समय होने वाली सभी त्रुटियों का वर्णन करता है, साथ ही उनका पता लगाने और पहचान करने के तरीके भी, ताकि त्रुटि की स्थिति में आपके पास त्वरित समाधान के लिए आवश्यक तकनीकें हों।
C भाषा में read() फ़ंक्शन का सिंटैक्स
size_t read(int fd, void *buf, size_t count);read() फ़ंक्शन का विवरण
read() फ़ंक्शन "fd" इनपुट आर्गुमेंट में निर्दिष्ट उसके डिस्क्रिप्टर द्वारा निर्दिष्ट खुली फ़ाइल की सामग्री को पढ़ता है। यह फ़ंक्शन फ़ाइल की सामग्री को पढ़ता है और उसे "buf" द्वारा इंगित बफर में "count" बाइट्स की संख्या के साथ कॉपी करता है। "fd" पहचानकर्ता एक पूर्णांक है जो फ़ाइल खोले जाने पर open() फ़ंक्शन के परिणाम के रूप में वापस किया जाता है।
यदि read() फ़ंक्शन सफलतापूर्वक वापस आता है, तो यह पढ़े गए बाइट्स की संख्या लौटाता है। परिणाम 0 के बराबर होने का अर्थ है कि फ़ाइल अंत तक पढ़ी गई थी, और -1 का अर्थ है कि एक त्रुटि हुई।
विशिष्ट त्रुटि की पहचान ग्लोबल "errno" वेरिएबल से उसका कोड प्राप्त करके की जा सकती है। बाद में, आपको एक खंड मिलेगा जो read() फ़ंक्शन का उपयोग करते समय होने वाली त्रुटियों और उनका पता लगाने और पहचानने की तकनीकों का वर्णन करता है।
read() फ़ंक्शन "unistd.h" हेडर में घोषित है। इसका उपयोग करने के लिए, आपको इस फ़ाइल को अपने कोड में निम्नानुसार शामिल करना होगा:
#include <unistd.h>read() फ़ंक्शन से फ़ाइल कैसे पढ़ें
इस उदाहरण में, हम बताएंगे कि open() और read() फ़ंक्शन का उपयोग करके फ़ाइल को कैसे खोलें और पढ़ें।
इस उद्देश्य के लिए, हमने पहले लिनक्स मैनेजर के माध्यम से "example.txt" नाम की एक टेक्स्ट फ़ाइल बनाई और इसे "Documents" डायरेक्टरी में सहेजा। फिर, हमने इसमें इस लेख का पहला पैराग्राफ लिखा।
फ़ाइल को पढ़ने के लिए कोड विकसित करने का पहला कदम आवश्यक हेडर्स को शामिल करना और एक main() फ़ंक्शन बनाना है जो एक खाली मान लौटाता है। हम इसमें "fd" पूर्णांक को परिभाषित करते हैं जो फ़ाइल डिस्क्रिप्टर के रूप में कार्य करता है, एक 1024 वर्ण बफर जिसे "buff" कहा जाता है जहां read() द्वारा पढ़ी गई जानकारी संग्रहीत होती है। सरणी path उस फ़ाइल का पथ और नाम संग्रहीत करती है जिसे हम पढ़ना चाहते हैं।
आवश्यक वेरिएबल को परिभाषित करने के बाद, हम फ़ाइल को खोलने के लिए open() फ़ंक्शन को कॉल करते हैं। हम इस फ़ंक्शन को पथ सरणी को पहले इनपुट आर्गुमेंट के रूप में फ़ाइल के पथ और नाम के साथ और दूसरे आर्गुमेंट के रूप में O_RDONLY फ्लैग को निर्दिष्ट करके कॉल करते हैं। आउटपुट आर्गुमेंट के रूप में, हम "fd" पूर्णांक पास करते हैं जहां open() डिस्क्रिप्टर लौटाता है जिसका उपयोग हम फ़ाइल को पढ़ने के लिए करते हैं।
एक बार फ़ाइल खुल जाने पर, हम read() फ़ंक्शन को कॉल करके उसकी सामग्री को पढ़ते हैं और open() फ़ंक्शन द्वारा लौटाए गए "fd" डिस्क्रिप्टर को पहले आर्गुमेंट के रूप में पास करते हैं। दूसरे आर्गुमेंट के रूप में, हम "buff" बफर का पॉइंटर पास करते हैं जहां हम पढ़ी जाने वाली सामग्री को संग्रहीत करते हैं और अंत में बफर का आकार जो इस मामले में 1024 बाइट्स है।
फिर हम कमांड कंसोल में buff में संग्रहीत सामग्री को प्रदर्शित करने के लिए printf() फ़ंक्शन का उपयोग करते हैं। इस उदाहरण के लिए पूरा कोड यहां दिया गया है:
#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>
#include <fcntl.h>

int main() {
    int fd;
    char buff[1024];
    char path[] = "Documents/example.txt";
    fd = open(path, O_RDONLY);
    read(fd, buff, 1024);
    printf("\n\n%s\n\n", buff);
}
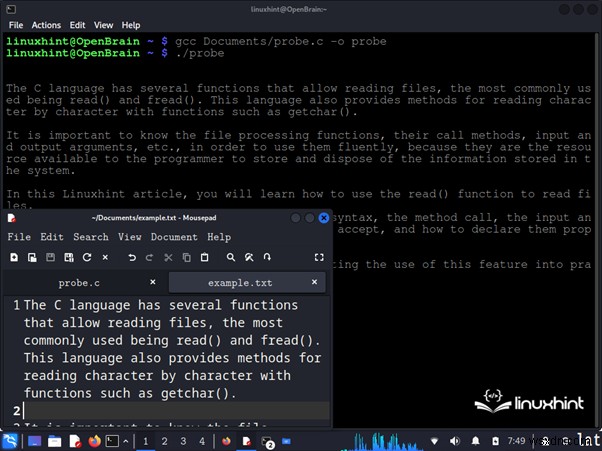
निम्न आकृति में, हम इस कोड का संकलन और निष्पादन देखते हैं। जैसा कि हम देख सकते हैं, read() "example.txt" फ़ाइल की पूरी सामग्री को "buff" में डालता है और printf() फ़ंक्शन इसे कमांड कंसोल पर प्रिंट करता है:
read() फ़ंक्शन का उपयोग करते समय होने वाली त्रुटियों का पता लगाना और पहचानना
read() का उपयोग करने से विभिन्न त्रुटियां उत्पन्न हो सकती हैं। जब ऐसा होता है, तो यह फ़ंक्शन -1 के बराबर परिणाम लौटाता है।
यह निर्धारित करने का सबसे आसान तरीका है कि कोई त्रुटि हुई है या नहीं, एक "if" कंडीशन का उपयोग करना जहां कंडीशन -1 का रिटर्न वैल्यू है। अब, आइए देखें कि आप इस मेथड का उपयोग कैसे कर सकते हैं यह निर्धारित करने के लिए कि कोई त्रुटि हुई है:
int n;
n = read(fd, buff, 1024);
if (n == -1) {
    printf("फ़ाइल को पढ़ने का प्रयास करते समय एक त्रुटि हुई।");
}
यदि read() फ़ंक्शन त्रुटि के साथ वापस आता है, तो यह "if" स्टेटमेंट में प्रवेश करता है और "फ़ाइल को पढ़ने का प्रयास करते समय एक त्रुटि हुई" संदेश प्रिंट करता है।
जब कोई त्रुटि होती है, तो एक न्यूमेरिक कोड स्वचालित रूप से ग्लोबल "errno" वेरिएबल में संग्रहीत होता है जो "errno.h" हेडर में परिभाषित होता है। इस कोड का उपयोग हुई त्रुटि की पहचान करने के लिए किया जा सकता है।
निम्नलिखित read() फ़ंक्शन द्वारा उत्पन्न होने वाली त्रुटियों का एक अंश है जो "errno.h" हेडर में परिभाषित हैं, साथ ही प्रत्येक त्रुटि का संक्षिप्त विवरण और संबद्ध पूर्णांक मान:
| त्रुटि | errno में मान | विवरण |
|---|---|---|
| EAGAIN | 11 | फिर से प्रयास करें |
| EBADF | 9 | गलत फ़ाइल नंबर |
| EDESTADDRREQ | 89 | गंतव्य पता आवश्यक |
| EFAULT | 14 | गलत पता |
| EFBIG | 27 | फ़ाइल बहुत बड़ी |
| EINTR | 4 | सिस्टम कॉल बाधित |
| EINVAL | 22 | अमान्य आर्गुमेंट |
| EIO | 5 | I/O त्रुटि |
| EPERM | 1 | ऑपरेशन अनुमत नहीं |
त्रुटि की पहचान करने का सबसे आसान तरीका एक स्विच खोलना है जहां "errno" वेरिएबल जंप कंडीशन है और प्रत्येक केस एक त्रुटि परिभाषा है।
अब, आइए एक उदाहरण देखें जहां हम एक नकारात्मक चिह्न के साथ एक डिस्क्रिप्टर दर्ज करने का प्रयास करते हैं, जिसके परिणामस्वरूप एक त्रुटि होती है। त्रुटि की पहचान करने के लिए, हम पिछले स्निपेट में देखी गई "if" कंडीशन का उपयोग करते हैं। इसकी पहचान करने के लिए, हम इस फ़ंक्शन द्वारा उत्पन्न तीन सबसे आम त्रुटियों के साथ एक स्विच खोलते हैं।
#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>
#include <fcntl.h>
#include <errno.h>

int main() {
    int fd, n;
    char buff[1024];
    char path[] = "Documents/example.txt";
    fd = open(path, O_RDONLY);

    n = read(99999999, buff, 1024);
    if (n == -1) {
        switch(errno) {
            case EBADF: {
                printf("गलत फ़ाइल नंबर। त्रुटि: %i\n", errno);
                break;
            }
            case EINVAL: {
                printf("अमान्य आर्गुमेंट। त्रुटि: %i\n", errno);
                break;
            }
            case EIO: {
                printf("I/O त्रुटि। त्रुटि: %i\n", errno);
                break;
            }
        }
    }
}
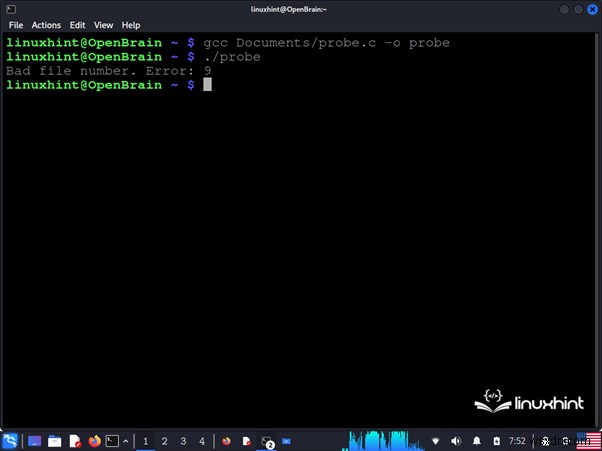
जैसा कि हम निम्न आकृति में देख सकते हैं, read() फ़ंक्शन एक त्रुटि लौटाता है जब एक अमान्य डिस्क्रिप्टर को इनपुट आर्गुमेंट के रूप में पास किया जाता है, और "errno" वेरिएबल से प्राप्त मान जो जंप कंडीशन के रूप में उपयोग किया जाता है, हमें EBADF केस में प्रवेश करके त्रुटि की पहचान करने की अनुमति देता है।
निष्कर्ष
इस LinuxHint लेख में, हमने आपको दिखाया कि read() फ़ंक्शन का उपयोग कैसे करें, जो C भाषा में फ़ाइलों को पढ़ने के लिए लागू सबसे आम फ़ंक्शन में से एक है।
हमने इसके सिंटैक्स और एक खंड को देखा जो इसके सैद्धांतिक संचालन, इनपुट और आउटपुट आर्गुमेंट और इसके डेटा प्रकारों का वर्णन करता है। बाद में, हमने कोड और छवियों के साथ एक व्यावहारिक उदाहरण में सीखे हुए को लागू किया जो दिखाता है कि open() और read() फ़ंक्शन का उपयोग करके फ़ाइल को कैसे खोलें और पढ़ें।
इस फ़ंक्शन का उपयोग करते समय संभावित त्रुटि का निवारण करने के लिए आवश्यक साधन रखने के लिए, हमने एक विशेष खंड जोड़ा है जो C भाषा द्वारा त्रुटियों का पता लगाने और पहचानने के लिए प्रदान की जाने वाली विधियों की व्याख्या करता है।