AI रिसर्च एजेंट्स का परिचय
अकादमिक शोध तेजी से आगे बढ़ता है - हर दिन arXiv और अन्य प्री-प्रिंट सर्वर पर नए पेपर दिखाई देते हैं। मैन्युअल रूप से बनाए रखना भारी पड़ सकता है। इस गाइड में, हम एक AI रिसर्च असिस्टेंट बनाएंगे जो:
- एक शोधकर्ता के प्राकृतिक-भाषा प्रश्न को समझता है
- arXiv सारांशों के वेक्टर डेटाबेस में सबसे प्रासंगिक पेपर्स ढूंढता है
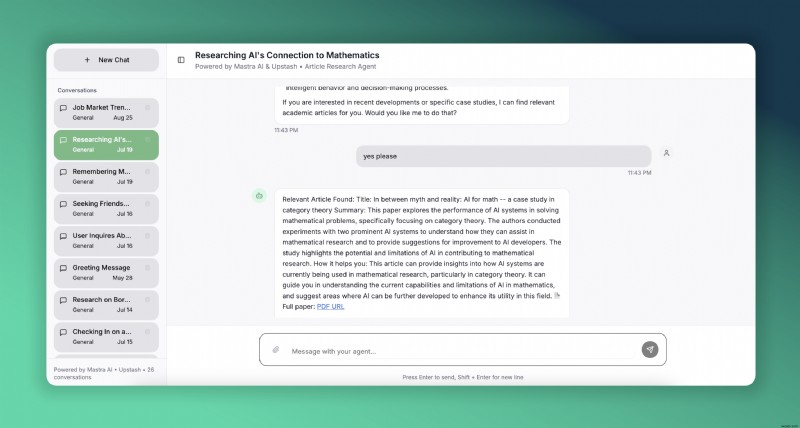
- मुख्य अंतर्दृष्टि को सारांशित करता है और बताता है कि वे प्रश्न का उत्तर कैसे देते हैं
- गहन पठन के लिए सीधा PDF लिंक प्रदान करता है
हम इसे Mastra, AI एजेंट्स बनाने के लिए एक ओपन-सोर्स TypeScript फ्रेमवर्क, और सर्वरलेस Redis और वेक्टर स्टोरेज के लिए Upstash के साथ पूरा करेंगे। यहां हमारे आर्टिकल एजेंट का एक लाइव डेमो है जो AI शोध पर केंद्रित है। यह आपके लिए Vercel पर डिप्लॉय किया गया है।
Mastra क्या है?
Mastra एक बैटरीज-इनक्लूडेड फ्रेमवर्क है जो प्रोडक्शन-ग्रेड AI एजेंट्स बनाना सरल बनाता है।
- एजेंट्स और वर्कफ़्लोज़ — एजेंट्स, टूल्स, और मल्टी-स्टेप वर्कफ़्लोज़ कंपोज़ करें
- रिट्रीवल-अगमेंटेड जनरेशन (RAG) - बिल्ट-इन मेमोरी और वेक्टर स्टोर्स
- मल्टी-LLM - OpenAI, Claude, और अधिक के साथ काम करता है।
हम एक एजेंट बनाएंगे जो Upstash Redis का उपयोग मेमोरी के लिए करता है। इसमें प्रासंगिक शोध लेख खोजने के लिए एक टूल भी होगा, जिसे हमने पहले Upstash वेक्टर डेटाबेस में एम्बेड किया है।
गहन जानकारी के लिए, Mastra दस्तावेज देखें।
प्रोजेक्ट के लिए टेक स्टैक
- Mastra फ्रेमवर्क AI एजेंट्स और टूल्स बनाने के लिए
- Upstash Redis एजेंट को वार्तालाप मेमोरी देने के लिए
- Upstash Vector शोध लेख सारांशों के एम्बेडिंग स्टोर करने के लिए
- Next.js और Vercel वेब एप्लिकेशन बनाने और डिप्लॉय करने के लिए
हम अपने डेमो एप्लिकेशन के लिए अनुरोधों को सीमित करने के लिए Upstash Ratelimit का भी उपयोग करेंगे।
कार्यान्वयन वॉकथ्रू
इस एप्लिकेशन को बनाने में दो मुख्य घटक बनाना शामिल है: Mastra सर्वर और वेब एप्लिकेशन। जबकि वे एक ही प्रोजेक्ट में हो सकते हैं, उन्हें अलग रखना क्लीनर है। आइए Mastra सर्वर से शुरू करें।
Mastra प्रोजेक्ट बनाना
अपने टर्मिनल में निम्न कमांड चलाकर एक नया Mastra प्रोजेक्ट बनाएं।
npm create mastra@latestयह कुछ प्रश्न पूछेगा; इस प्रोजेक्ट के लिए, डिफ़ॉल्ट सेटिंग्स ठीक हैं।
एजेंट्स और टूल्स बनाना
एजेंट को कॉन्फ़िगर करने में पहला कदम इसके नाम, उद्देश्य, और टूल्स को परिभाषित करना है। दिए गए कार्यों के लिए अच्छा प्रदर्शन करने वाले भाषा मॉडल को चुनना भी महत्वपूर्ण है। इस प्रोजेक्ट में, हमारे पास एक एजेंट और एक टूल होगा।
export const articleAgent = new Agent({
  name: "articleAgent",
  instructions: instruction,
  model: openai('gpt-4o'),
  tools: { articleQueryTool },
  memory: memory
});
एजेंट को कॉन्फ़िगर करना ऊपर दिखाए अनुसार सरल है। हम अपने articleAgent को एक instruction (जो सिस्टम प्रॉम्प्ट के रूप में कार्य करता है), इसके समर्पित tools, model, और एक और महत्वपूर्ण घटक: memory के साथ परिभाषित करते हैं।
एजेंट की मेमोरी
Mastra एजेंट्स को चैट इतिहास और सिमेंटिक रिकॉल दोनों क्षमताएं प्रदान करता है। स्टोरेज में मेमोरी को बनाए रखकर, एजेंट अधिक व्यक्तिगत और सटीक उत्तर प्रदान कर सकता है। आइए हमारे एजेंट की मेमोरी कॉन्फ़िगरेशन देखें।
export const memory = new Memory({
  storage: myUpstashStore,
  options: {
    lastMessages: 10,
    semanticRecall: false,
    threads: { generateTitle: true }
  }
});
चैट इतिहास सक्षम करने के लिए, हम अपने स्टोरेज विकल्प के रूप में Upstash Redis का उपयोग करते हैं। हम इसे UpstashStore ऑब्जेक्ट के रूप में इनिशियलाइज़ करते हैं, जो MastraStorage को एक्सटेंड करता है, यह सुनिश्चित करते हुए कि यह हमारे Mastra एजेंट के साथ निर्बाध रूप से काम करता है।
export const myUpstashStore = new UpstashStore({
  url: process.env.UPSTASH_REDIS_REST_URL!,
  token: process.env.UPSTASH_REDIS_REST_TOKEN!,
});
हमने पहले अपने एजेंट में एक सिमेंटिक रिकॉल सुविधा जोड़ने का उल्लेख किया था, जो इसे वर्तमान संदर्भ से संबंधित पिछले मैसेजेस पर विचार करने की अनुमति देता है। उसके लिए, एजेंट को एक वेक्टर डेटाबेस और मैसेजेस को प्रोसेस करने के लिए एक एम्बेडर की आवश्यकता होती है। चूंकि हमारा सार्वजनिक डेमो व्यक्तिगत उपयोग के लिए नहीं है और विभिन्न थ्रेड्स में मैसेजेस याद रखने की आवश्यकता नहीं है, हम इस सुविधा का उपयोग नहीं करेंगे, लेकिन इसे इस तरह लागू किया जा सकता है।
export const myUpstashVector = new UpstashVector({
  url: process.env.UPSTASH_VECTOR_REST_URL!,
  token: process.env.UPSTASH_VECTOR_REST_TOKEN!,
});
export const memory = new Memory({
  storage: myUpstashStore,
  vector: myUpstashVector,
  embedder: openai.embedding("text-embedding-3-small"),
  options: {
    lastMessages: 10,
    semanticRecall: { topK: 3, messageRange: 2, scope: 'resource' },
    threads: { generateTitle: true }
  }
});
सिमेंटिक रिकॉल कॉन्फ़िगरेशन में, topK पुनर्प्राप्त करने के लिए समान मैसेजेस की संख्या निर्दिष्ट करता है, messageRange प्रत्येक मिलान के साथ शामिल करने के लिए आसपास के संदर्भ को परिभाषित करता है, और scope को 'resource' पर सेट करने से एजेंट 'resource' नामक उपयोगकर्ता से जुड़े सभी थ्रेड्स में खोज करता है। यह क्रॉस-थ्रेड मेमोरी Upstash के साथ उपलब्ध एक शक्तिशाली सुविधा है।
टूल्स
एक टूल बनाना एजेंट बनाने के लगभग जितना सरल है। हम एक नाम, विवरण, इनपुट और आउटपुट स्कीमा, और एक फ़ंक्शन प्रदान करते हैं जब एजेंट को टूल की क्षमताओं की आवश्यकता होती है।
export const articleQueryTool = createTool({
  id: 'get-relevant-article',
  description: 'Get relevant article information',
  inputSchema: z.object({
    question: z.string().describe('the question about the field'),
  }),
  outputSchema: z.object({
    bestOption: z.object({
      abstract: z.string().describe('the abstract of the article'),
      title: z.string().describe('the title of the article'),
      pdfUrl: z.string().describe('the PDF URL of the article')
    })
  }),
  execute: async ({ context }) => {
    return await querySimilar(context.question);
  },
});
हम इनपुट और आउटपुट स्कीमा को मान्य करने के लिए Zod का उपयोग करते हैं। यह सुसंगत प्रतिक्रियाओं को बनाए रखने में मदद करता है और LLM से संभावित त्रुटियों को कम करता है। हम टूल के उपयोग के लिए एक फ़ंक्शन भी परिभाषित करते हैं। हमारा टूल शोध लेखों के एक बड़े संग्रह को क्वेरी करेगा, जिसे arXiv API के माध्यम से समय-समय पर अपडेट किया जाता है और हमारे Upstash वेक्टर डेटाबेस में एम्बेड किया जाता है।
const querySimilar = async (query: string) => {
  const { embedding } = await embed({
    value: query,
    model: openai.embedding("text-embedding-3-small"),
  });
  const results = await myMastraUpstashVector.query({
    indexName: "arxiv",
    queryVector: embedding,
    topK: 3,
  });
  if (results && results.length > 0) {
    const bestMatch = results[0];
    const metadata = bestMatch.metadata as ArxivPaper;
    return {
      bestOption: {
        abstract: metadata.abstract,
        title: metadata.title,
        pdfUrl: metadata.pdfUrl
      }
    };
  }
  throw new Error("No relevant information found");
}
हम UpstashVector इंस्टेंस के माध्यम से अपने वेक्टर डेटाबेस पर सरल ऑपरेशन कर सकते हैं, जो MastraVector को एक्सटेंड करता है। ऊपर, हम पहले से एम्बेड किए गए समान लेख सारांशों के लिए क्वेरी करते हैं और टूल को सर्वोत्तम परिणाम लौटाते हैं। ध्यान दें कि हम क्वेरी के लिए उसी एम्बेडिंग मॉडल का उपयोग करते हैं जैसा हमने लेखों के लिए किया था। हम बाद में लेख एम्बेडिंग के बारे में अधिक विस्तार से बताएंगे।
Mastra इंस्टेंस
export const mastra = new Mastra({
  storage: myMastraUpstashStore,
  agents: { articleAgent },
  deployer: new VercelDeployer()
});
हम बस निर्दिष्ट करते हैं कि किन एजेंट्स का उपयोग करना है, और हमारा Mastra ऑब्जेक्ट तैयार है। हम इन-मेमोरी स्टोरेज से परे डेटा को स्थायी करने के लिए स्टोरेज भी प्रदान करते हैं। आप उपलब्ध डिप्लॉयमेंट कॉन्फ़िगरेशन से भी चुन सकते हैं; हम Vercel का उपयोग करके डिप्लॉय करेंगे।
create-mastra-app से डिफ़ॉल्ट विकल्पों के साथ, हमारे पास पहले से ही आवश्यक फ़ाइल संरचना है:
.
└── mastra
    ├── agents
    │   └── index.ts
    ├── tools
    │   └── index.ts
    └── index.ts
डिप्लॉय करने से पहले केवल एक कदम शेष है: हमारे एनवायरनमेंट वेरिएबल्स।
OPENAI_API_KEY=
UPSTASH_VECTOR_REST_URL=
UPSTASH_VECTOR_REST_TOKEN=
UPSTASH_REDIS_REST_URL=
UPSTASH_REDIS_REST_TOKEN=
स्थानीय विकास के लिए इन्हें अपनी .env.local फाइल में डालें और उन्हें अपने डिप्लॉयमेंट एनवायरनमेंट में जोड़ें।
अब हम अपने Mastra सर्वर को बिल्ड और डिप्लॉय करने के लिए तैयार हैं।
npm run build && vercel --prodडिप्लॉय कैसे करें, यह देखने के लिए Vercel दस्तावेज देखें।
विकास करते समय, हम अपने सर्वर के आउटपुट को देखने के लिए Mastra Playground का उपयोग कर सकते हैं। निम्न कमांड चलाएं:
npm run devयह एक वेब इंटरफ़ेस का लिंक प्रदान करेगा जहां आप हमारे एजेंट के साथ चैट कर सकते हैं, टूल्स को स्पष्ट रूप से चला सकते हैं, और हमारे सर्वर की क्षमताओं का पता लगा सकते हैं।
अब एप्लिकेशन के दूसरे भाग के बारे में बात करने का समय है।
Next.js सर्वर
एक बार Mastra सर्वर सेट हो जाने पर, हमें तीन चीजों को संभालने की आवश्यकता है: UI, Mastra सर्वर के साथ संचार, और एक आर्टिकल सर्विस जो arXiv API से बात करती है और सारांशों को Upstash Vector में एम्बेड करती है। Mastra के पास सर्वर की कार्यक्षमताओं को उजागर करने के लिए एक क्लाइंट SDK है। इसके माध्यम से, आप एजेंट्स, टूल्स, मेमोरी, और अधिक तक पहुंच सकते हैं। इसका उपयोग सीधा है, लेकिन हम कुछ उदाहरण साझा करेंगे। अधिक विवरण के लिए, आप यहां दस्तावेज देख सकते हैं। Next.js प्रोजेक्ट में, आप बस क्लाइंट SDK को इंस्टॉल और उपयोग कर सकते हैं।
npm install @mastra/client-js@latestअपने कोड में, इसका उपयोग करने के लिए MastraClient का एक इंस्टेंस बनाएं।
import { MastraClient } from "@mastra/client-js";
export const mastra_sdk = new MastraClient({
  baseUrl: process.env.NEXT_PUBLIC_MASTRA_API!,
  retries: 3,
});
आपको NEXT_PUBLIC_MASTRA_API को अपने Mastra सर्वर के पते पर सेट करना होगा। यदि आप स्थानीय रूप से विकसित कर रहे हैं, तो यह एक localhost पता होगा। चूंकि 3000 पोर्ट पर शायद संघर्ष होगा, आप Mastra सर्वर के कॉन्फ़िगरेशन को स्थानीय रूप से चलाते समय बदल सकते हैं, जैसा कि नीचे दिखाया गया है:
export const mastra = new Mastra({
  storage: myMastraUpstashStore,
  agents: { articleAgent },
  server: { port: 4111, timeout: 10000, }
});
अब, जब हम Mastra सर्वर को स्थानीय रूप से npm run dev के साथ चलाते हैं, तो यह पोर्ट 4111 पर सर्व किया जाता है। जब हम Next.js प्रोजेक्ट को स्थानीय रूप से चलाते हैं तो हम NEXT_PUBLIC_MASTRA_API को https://localhost:4111 पर सेट कर सकते हैं।
आइए देखें कि हम Mastra के क्लाइंट SDK का उपयोग कैसे कर सकते हैं।
export const MASTRA_CONFIG = {
  resourceId: process.env.NEXT_PUBLIC_RESOURCE_ID || "articleAgent",
  agentId: "articleAgent",
  baseUrl: process.env.NEXT_PUBLIC_MASTRA_API || "https://localhost:4111",
  retries: 3,
};
// यह दूसरी फ़ाइल में निर्यात किया गया है ताकि हम इसे कोडबेस में कहीं भी उपयोग कर सकें।
// अपना एजेंट प्राप्त करें और बस अपने एजेंट ऑब्जेक्ट के माध्यम से अपनी प्रतिक्रिया स्ट्रीम करें।
const agent = mastra_sdk.getAgent(MASTRA_CONFIG.agentId);
const response = await agent.stream({
  messages: [message],
  resourceId: MASTRA_CONFIG.resourceId,
  threadId: threadId
});
आप अपने टूल्स और एजेंट्स प्राप्त कर सकते हैं, और एक बार जब आपके पास वे हों, तो आप वास्तविक ऑब्जेक्ट्स के साथ लगभग वह सब कुछ कर सकते हैं जो आप क्लाइंट SDK के माध्यम से कर सकते थे।
चूंकि हम इस डेमो प्रोजेक्ट को सार्वजनिक रूप से प्रकाशित करेंगे, इसलिए एजेंट पर भारी लोड से बचना महत्वपूर्ण है। यहीं Upstash Ratelimit काम आता है। हर स्ट्रीम अनुरोध से पहले, हम जांचेंगे कि क्या उपयोगकर्ता रेट-लिमिटेड है। अपने रेट लिमिटर को कॉन्फ़िगर करने के लिए, हमें Upstash Redis की आवश्यकता होगी। हम अपने Mastra एजेंट के लिए उसी Redis डेटाबेस का उपयोग कर सकते हैं।
import { Ratelimit } from '@upstash/ratelimit';
import { Redis } from '@upstash/redis';
// पूरे प्रोजेक्ट में उसी Redis DB का उपयोग
export const rateLimit = new Ratelimit({
  redis: new Redis({
    url: process.env.UPSTASH_REDIS_MEMORY_URL!,
    token: process.env.UPSTASH_REDIS_MEMORY_TOKEN!
  }),
  limiter: Ratelimit.slidingWindow(10, '10s'),
  prefix: 'upstash-ratelimit',
});
// हर स्ट्रीम से पहले नीचे दिए गए फ़ंक्शन को प्राप्त करें।
export async function isRateLimited(id: string): Promise {
  const { success } = await rateLimit.limit(id);
  return !success;
}
इस तरह, हम सुनिश्चित करते हैं कि हमारे एंडपॉइंट भारी लोड के अधीन नहीं होंगे।
Mastra के साथ चैट एजेंट्स बनाते समय, Mastra के थ्रेड जनरेशन की कुछ विशेषताओं को जानना मददगार हो सकता है। याद रखें कि जब हमने एजेंट के लिए मेमोरी कॉन्फ़िगर की, तो हमने threads ऑब्जेक्ट में generateTitle को true पर सेट किया। यह Mastra को नए बनाए गए थ्रेड्स के लिए स्वचालित रूप से शीर्षक जनरेट करता है। लेकिन यहां पकड़ है: एक थ्रेड को स्पष्ट रूप से बनाना संभव है, लेकिन स्वचालित शीर्षक जनरेशन उस तरह ट्रिगर नहीं होता है। आमतौर पर, एक नया थ्रेड बनाने का तरीका इस प्रकार है:
const thread = await mastraClient.createMemoryThread({
  title: "New Conversation",
  metadata: { category: "support" },
  resourceId: "resource-1",
  agentId: "agent-1",
});
हालांकि, यह एजेंट की स्वचालित रूप से शीर्षक जनरेट करने की क्षमता को छीन लेता है, क्योंकि आप इसे मैन्युअल रूप से सेट कर रहे हैं। title फील्ड को खाली छोड़ना भी काम नहीं करता। इस मामले में, हम देख सकते हैं कि Playground क्या करता है। याद रखें Playground, जिसे Mastra विकास के दौरान आपके सर्वर की क्षमताओं का अनुभव करने के लिए प्रदान करता है? यदि हम ब्राउज़र के डेवलपर टूल्स में नेटवर्क टैब का निरीक्षण करते हैं, तो हम देखते हैं कि जब एक नया थ्रेड बनाया जाता है, तो यह वास्तव में इसे बनाने के लिए API अनुरोध नहीं भेजता। इसके बजाय, यह आपके पहले मैसेज सबमिट करने का इंतजार करता है। उसके बाद, यह एक नए जनरेटेड थ्रेड ID के साथ एक स्ट्रीम अनुरोध भेजता है। यह Mastra को बताता है कि इस ID के साथ कोई थ्रेड मौजूद नहीं है, इसलिए इसे एक बनाना चाहिए और, यदि generateTitle सच है, तो पहले मैसेज के आधार पर एक शीर्षक जनरेट करना चाहिए।
आइए हमारे प्रोजेक्ट के अंतिम घटक के साथ जारी रखें: arXiv लेख।
arXiv लेख
arXiv विभिन्न क्षेत्रों में लगभग 2.4 मिलियन शोध लेखों का एक ओपन-एक्सेस आर्काइव है। articleQueryTool Upstash वेक्टर डेटाबेस को क्वेरी करता है, जिसे arXiv API के माध्यम से प्राप्त लेखों द्वारा खिलाया जाता है। API उपयोग करने में सरल है; आप अधिक विवरण यहां पा सकते हैं।
हमारे प्रोजेक्ट में, हम लेखों को दैनिक रूप से प्राप्त और स्टोर करते हैं। पहली बार सर्वर चलने पर, यह निर्दिष्ट श्रेणियों से लगभग 30,000 लेख प्राप्त करता है। उसके बाद, यह पिछले दिन प्रकाशित नए लेख प्राप्त करता है। लेख श्रेणियों को निर्दिष्ट करने और प्रारंभिक बड़े बैच को प्राप्त करने के लिए, हम संबंधित एनवायरनमेंट वेरिएबल्स सेट करते हैं। हम arXiv के टैक्सोनॉमी का उपयोग करके वांछित लेख श्रेणियों को कॉमा से अलग करके प्रदान करना चाहिए। आप यहां श्रेणियों को देख सकते हैं।
CATEGORIES=cs.AI
RUN_BEGINNING_STACK=false
यदि आप अधिक व्यापक डेटाबेस चाहते हैं, तो आप arXiv के बल्क डेटा एक्सेस का उपयोग कर सकते हैं। इसके बिना, हम प्रति API क्वेरी 30,000 लेखों तक सीमित हैं, जो हमारे उद्देश्यों के लिए पर्याप्त है।
arXiv के लिए एक साधारण क्वेरी इस तरह दिखती है:
const categories = process.env.CATEGORIES?.split(',') || [];
const searchQuery = categories.length === 1 ? `cat:${categories[0]}` : `(${categories.map(c => `cat:${c}`).join(" OR ")})`;
const query = `search_query=${searchQuery}&sortBy=submittedDate&sortOrder=descending`;
const url = `https://export.arxiv.org/api/query?${query}`;
const response = await axios.get(url);
हम हर दिन नवीनतम लेख प्राप्त करने और प्रारंभिक स्टैक प्राप्त करने के लिए समान कॉल करते हैं।
लेख प्राप्त करने के बाद, हम उन्हें सामान्यीकृत करते हैं और Upstash Vector में स्टोरेज के लिए उन्हें एम्बेड करते हैं। यह वही वेक्टर डेटाबेस होना चाहिए जिसका उपयोग हमारा Mastra टूल करता है। "सामान्यीकृत" से, हमारा मतलब प्राप्त लेखों को एक मानक ArxivPaper प्रकार में पार्स करना है, जिसका उपयोग हम अपने कोडबेस में करेंगे।
export interface ArxivPaper {
  id: string;
  title: string;
  abstract: string;
  authors: string[];
  published: string;
  pdfUrl: string;
  category: string;
}
// हमारे लेखों का प्रकार, हमारे कोडबेस में।
async function storeAbstracts(papers: ArxivPaper[]) {
  const embeddingModel = openai.embedding("text-embedding-3-small");
  const embeddings = await embedArticles(papers, embeddingModel)
  const vectorsToUpsert = getVectorsToUpsert(embeddings, papers)
  for (let j = 0; j < vectorsToUpsert.length; j++) {
    await vectorStore.upsert(vectorsToUpsert[j], { namespace: "arxiv" });
  }
}
यह सुनिश्चित करने के लिए कि हमारा डेटाबेस नवीनतम शोध के साथ चालू रहे, हम शेड्यूल्ड टास्क निष्पादन के लिए Upstash QStash को लागू करते हैं। Vercel पर हमारे डिप्लॉयमेंट को देखते हुए, हमें विस्तारित प्रसंस्करण अंतराल के साथ होने वाले फ़ंक्शन टाइमआउट को रोकने की आवश्यकता है। हम अपने सर्वर पर एक सार्वजनिक API एंडपॉइंट को उजागर करके इसे संबोधित करते हैं, जिससे हमारा QStash इंस्टेंस दैनिक डेटाबेस अपडेट फ़ंक्शन को विश्वसनीय रूप से ट्रिगर कर सके।
// src/app/api/arxiv_reneval/route.ts
import { verifySignatureAppRouter } from "@upstash/qstash/nextjs"
import { fetchAndUpsertYesterday} from "@/services/arxiv"
async function handler(request: Request) {
  console.log("Fetching and upserting yesterday's papers...")
  await fetchAndUpsertYesterday()
  console.log("Fetching and upserting yesterday's papers completed")
  return Response.json({ success: true })
}
export const POST = verifySignatureAppRouter(handler)
एक शेड्यूलर को Upstash कंसोल के माध्यम से कॉन्फ़िगर किया जा सकता है ताकि इस एंडपॉइंट पर दैनिक सुबह 6:00 UTC पर अनुरोध स्वचालित रूप से ट्रिगर हों।
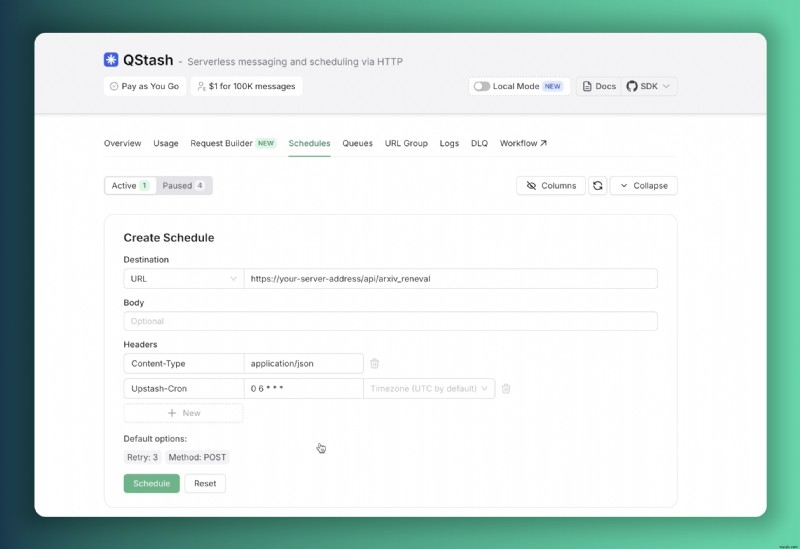
इस शेड्यूलर कॉन्फ़िगरेशन के साथ, हमारा सर्वर प्रत्येक सुबह स्वचालित डेटाबेस अपडेट करेगा, जिससे निरंतर डेटा ताजगी सुनिश्चित होगी।
हमें अपने QStash इंस्टेंस के लिए क्रेडेंशियल्स भी प्रदान करने चाहिए, सभी आवश्यक एनवायरनमेंट वेरिएबल्स उदाहरण एनवी फाइल में दिए गए हैं।
यह बहुत कुछ है। यदि आप चाहें, तो आप कोड के साथ खेल सकते हैं। बस रिपॉजिटरी को फोर्क करें और विकास शुरू करें। आप Mastra भाग के रिपॉजिटरी को यहां और दूसरे को यहां जा सकते हैं। उन्हें फोर्क करने के बाद:
- उन्हें अपने स्थानीय मशीन पर क्लोन करें।
- अपने एनवायरनमेंट वेरिएबल्स भरें (उदाहरण
.envफाइलें प्रदान की गई हैं)। - दोनों प्रोजेक्ट्स के रूट डायरेक्टरी में अलग-अलग टर्मिनल में जाएं।
- निम्न कमांड चलाएं:
npm install
npm run dev
अब आप अपना एप्लिकेशन https://localhost:3000 पर देख सकते हैं।
Mastra के साथ, आप RAG, वर्कफ़्लोज़, और नेटवर्क जैसे इसके अन्य टेम्प्लेट का उपयोग करके अधिक जटिल चीजें बना सकते हैं। ऐसा लगता है कि मेमोरी और स्टोरेज इन सभी उद्देश्यों में महत्वपूर्ण भूमिका निभाते हैं। यहीं Upstash चमकता है।