रेडिस एक बेडरॉक तकनीक है और, जैसे, हम कभी-कभी लोगों को वैकल्पिक आर्किटेक्चर पर विचार करते देखते हैं। कुछ साल पहले, यह KeyDB द्वारा उठाया गया था, और हाल ही में एक नई परियोजना, ड्रैगनफ्लाई, ने सबसे तेज़ रेडिस-कम्पैटिबल इन-मेमोरी डेटास्टोर होने का दावा किया। हम मानते हैं कि ये परियोजनाएं कई दिलचस्प तकनीकों और विचारों को लाती हैं जो चर्चा और बहस के योग्य हैं। यहां रेडिस में, हम इस तरह की चुनौती को पसंद करते हैं, क्योंकि यह हमें उन आर्किटेक्चरल सिद्धांतों की पुष्टि करने की आवश्यकता होती है जिनके साथ रेडिस को शुरू में डिज़ाइन किया गया था (साल्वाटोर सैनफिलिप्पो उर्फ एंटीरेज़ को हैट टिप)।
जबकि हम हमेशा रेडिस के प्रदर्शन और क्षमताओं को नवाचार और आगे बढ़ाने के अवसरों की तलाश में रहते हैं, हम अपना दृष्टिकोण और कुछ प्रतिबिंब साझा करना चाहते हैं कि क्यों रेडिस की आर्किटेक्चर एक इन-मेमोरी, रीयल-टाइम डेटास्टोर (कैश, डेटाबेस, और बीच में सब कुछ) के लिए सर्वश्रेष्ठ श्रेणी में बनी हुई है।
तो अगले खंडों में, हम गति और आर्किटेक्चरल अंतरों पर अपने दृष्टिकोण को उजागर करते हैं क्योंकि यह तुलना से संबंधित है। इस पोस्ट के अंत में, हमने बेंचमार्क और प्रदर्शन तुलना के विवरण भी प्रदान किए हैं बनाम ड्रैगनफ्लाई परियोजना, जिस पर हम नीचे चर्चा करते हैं और आपको स्वयं समीक्षा और पुनरुत्पादन के लिए आमंत्रित करते हैं।
गति
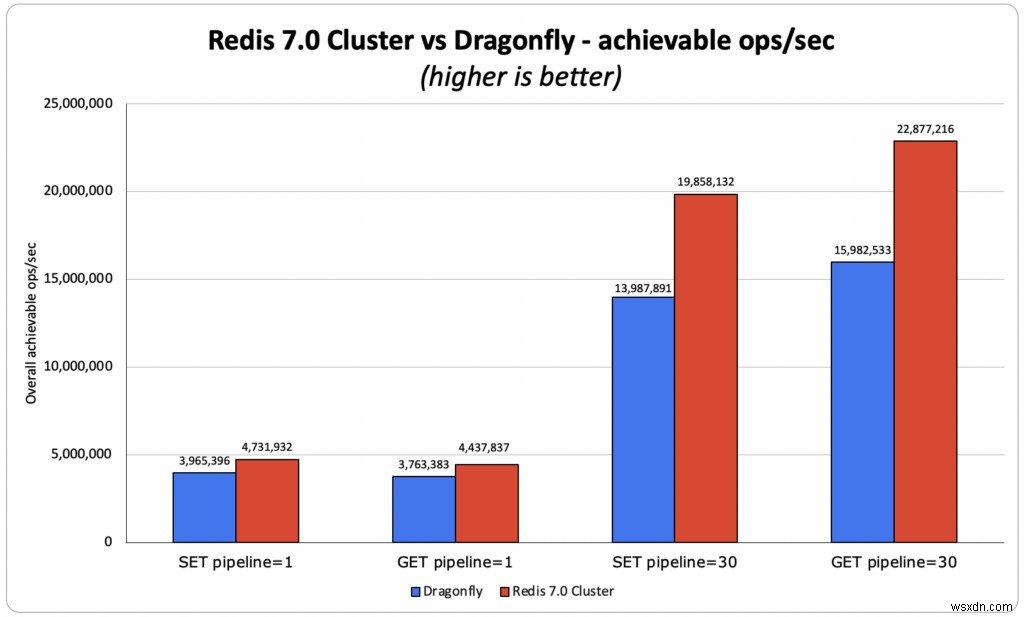
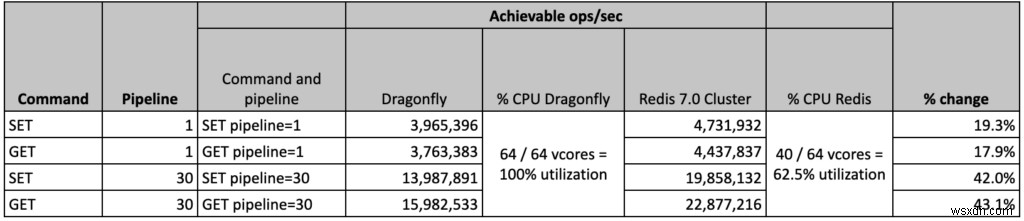
ड्रैगनफ्लाई बेंचमार्क एक स्टैंडअलोन सिंगल-प्रोसेस रेडिस इंस्टेंस (जो केवल एक कोर का उपयोग कर सकता है) की तुलना एक मल्टीथ्रेडेड ड्रैगनफ्लाई इंस्टेंस (जो VM/सर्वर पर उपलब्ध सभी कोर का उपयोग कर सकता है) से करता है। दुर्भाग्य से, यह तुलना यह नहीं दर्शाती कि रेडिस वास्तविक दुनिया में कैसे चलाया जाता है। प्रौद्योगिकी निर्माताओं के रूप में, हम यह समझने का प्रयास करते हैं कि हमारी तकनीक दूसरों से कैसे तुलना करती है, इसलिए हमने वही किया जो हमें उचित तुलना लगता है और एक 40-शार्ड रेडिस 7.0 क्लस्टर (जो इंस्टेंस के अधिकांश कोर का उपयोग कर सकता है) की तुलना ड्रैगनफ्लाई से की, AWS c6gn.16xlarge पर सबसे बड़े इंस्टेंस प्रकार का उपयोग करके ड्रैगनफ्लाई टीम द्वारा उनके बेंचमार्क में उपयोग किए गए प्रदर्शन परीक्षणों के एक सेट का उपयोग करके। हमारे परीक्षणों में, हमने रेडिस को ड्रैगनफ्लाई की तुलना में 18% - 40% अधिक थ्रूपुट प्राप्त करते देखा, यहां तक कि 64 vCores में से केवल 40 का उपयोग करते हुए।
आर्किटेक्चरल अंतर
कुछ पृष्ठभूमि
हम मानते हैं कि इन मल्टीथ्रेडेड परियोजनाओं के रचनाकारों द्वारा किए गए बहुत से आर्किटेक्चरल निर्णय उनके पिछले काम में अनुभव किए गए दर्द बिंदुओं से प्रभावित थे। हम सहमत हैं कि एक मल्टी-कोर मशीन पर सिंगल रेडिस प्रोसेस चलाना, कभी-कभी दर्जनों कोर और सैकड़ों GB मेमोरी के साथ, उन संसाधनों का लाभ नहीं उठाने वाला है जो स्पष्ट रूप से उपलब्ध हैं। लेकिन यह इस तरह से नहीं है कि रेडिस को कैसे उपयोग करने के लिए डिज़ाइन किया गया था; यह सिर्फ वही है जैसे कई रेडिस प्रदाताओं ने अपनी सेवाओं को चलाने के लिए चुना है।
रेडिस मल्टी-प्रोसेस चलाकर (रेडिस क्लस्टर का उपयोग करके) क्षैतिज रूप से स्केल करता है यहां तक कि एक सिंगल क्लाउड इंस्टेंस के संदर्भ में भी। रेडिस (कंपनी) में हमने इस अवधारणा को और विकसित किया और रेडिस एंटरप्राइज बनाया जो एक प्रबंधन परत प्रदान करता है जो हमारे उपयोगकर्ताओं को रेडिस को बड़े पैमाने पर चलाने की अनुमति देता है, उच्च उपलब्धता, तत्काल फेलओवर, डेटा पर्सिस्टेंस, और डिफ़ॉल्ट रूप से सक्षम बैकअप के साथ।
हमने पर्दे के पीछे हमारे द्वारा उपयोग किए जाने वाले कुछ सिद्धांतों को साझा करने का निर्णय लिया ताकि लोगों को यह समझने में मदद मिल सके कि हम प्रोडक्शन वातावरण में रेडिस चलाने के लिए अच्छी इंजीनियरिंग प्रथाओं पर क्या मानते हैं।
आर्किटेक्चरल सिद्धांत
प्रति VM कई रेडिस इंस्टेंस चलाएं
प्रति VM कई रेडिस इंस्टेंस चलाने से हमें:
- पूरी तरह से शेयर्ड-नथिंग आर्किटेक्चर का उपयोग करके रैखिक रूप से, लंबवत और क्षैतिज दोनों तरह से स्केल करने की अनुमति मिलती है। यह हमेशा एक मल्टीथ्रेडेड आर्किटेक्चर की तुलना में अधिक लचीलापन प्रदान करेगा जो केवल लंबवत स्केल करता है।
- रेप्लिकेशन की गति बढ़ाएं, क्योंकि रेप्लिकेशन कई प्रोसेस में समानांतर में किया जाता है।
- VM की विफलता से तेजी से रिकवरी, क्योंकि नए VM के रेडिस इंस्टेंस एक साथ कई बाहरी रेडिस इंस्टेंस से डेटा से भरे जाएंगे।
प्रत्येक रेडिस प्रोसेस को एक उचित आकार तक सीमित करें
हम एक सिंगल रेडिस प्रोसेस को आकार में 25 GB से आगे बढ़ने की अनुमति नहीं देते (और रेडिस ऑन फ्लैश चलाते समय 50 GB)। यह हमें अनुमति देता है:
- कॉपी-ऑन-राइट के लाभों का आनंद लेने के लिए रेडिस को रेप्लिकेशन, स्नैपशॉटिंग, और अपेंड ओनली फाइल (AOF) रीराइट के लिए फोर्क करते समय बड़े मेमोरी ओवरहेड की पेनल्टी का भुगतान किए बिना। और 'हां' यदि आप ऐसा नहीं करते हैं, तो आप (या आपके उपयोगकर्ता) उच्च कीमत चुकाएंगे, जैसा कि यहां दिखाया गया है।
- अपने क्लस्टर्स को आसानी से प्रबंधित करें, शार्ड माइग्रेट करें, रीशार्ड करें, स्केल करें, और तेजी से रीबैलेंस करें, क्योंकि रेडिस का प्रत्येक इंस्टेंस छोटा रखा जाता है।
क्षैतिज स्केलिंग सर्वोपरि है
अपने इन-मेमोरी डेटास्टोर को क्षैतिज स्केलिंग के साथ चलाने का लचीलापन अत्यंत महत्वपूर्ण है। यहां कुछ कारण दिए गए हैं:
- बेहतर रेजिलिएंसी - आप अपने क्लस्टर में जितने अधिक नोड्स का उपयोग करते हैं, आपका क्लस्टर उतना ही मजबूत होता है। उदाहरण के लिए, यदि आप अपना डेटासेट 3-नोड क्लस्टर पर चलाते हैं और एक नोड डिग्रेड होता है, तो यह आपके क्लस्टर का 1/3 है जो प्रदर्शन नहीं कर रहा है; लेकिन यदि आप अपना डेटासेट 9-नोड क्लस्टर पर चलाते हैं और एक नोड डिग्रेड होता है, तो यह आपके क्लस्टर का सिर्फ 1/9 है जो प्रदर्शन नहीं कर रहा है।
- स्केल करना आसान - अपने क्लस्टर में एक अतिरिक्त नोड जोड़ना और अपने डेटासेट के केवल एक हिस्से को उस पर माइग्रेट करना बहुत आसान है, बजाय लंबवत स्केलिंग के, जहां आपको एक बड़ा नोड लाने और अपने पूरे डेटासेट को कॉपी करने की आवश्यकता होती है (और इस संभावित लंबी प्रक्रिया के बीच में होने वाली सभी बुरी चीजों के बारे में सोचें...)
- धीरे-धीरे स्केल करना बहुत अधिक लागत-प्रभावी है - विशेष रूप से क्लाउड में लंबवत स्केलिंग महंगी है। कई मामलों में, आपको अपने इंस्टेंस आकार को दोगुना करने की आवश्यकता होती है भले ही आपको अपने डेटासेट में केवल कुछ GB जोड़ने की आवश्यकता हो।
- हाई थ्रूपुट - रेडिस में, हम कई ग्राहकों को देखते हैं जो छोटे डेटासेट पर हाई थ्रूपुट वर्कलोड चला रहे हैं, बहुत उच्च नेटवर्क बैंडविड्थ और/या उच्च पैकेट प्रति सेकंड (PPS) मांग के साथ। 1GB डेटासेट के साथ 1M+ ops/sec उपयोग के मामले के बारे में सोचें। क्या इसे सिंगल-नोड c6gn.16xlarge क्लस्टर (128GB 64 CPUs और 100gbps $2.7684/hr पर) पर चलाने के बजाय 3-नोड c6gn.xlarge क्लस्टर (8GB. 4 CPU 25Gbps तक $0.1786/hr प्रत्येक) पर 20% से कम लागत पर और बहुत अधिक मजबूत तरीके से चलाना समझ में आता है? लागत-प्रभावशीलता बनाए रखते हुए और रेजिलिएंसी में सुधार करते हुए थ्रूपुट बढ़ाने में सक्षम होना सवाल का एक आसान जवाब लगता है।
- NUMA की वास्तविकताएं - लंबवत स्केलिंग का अर्थ दो-सॉकेट सर्वर चलाना भी है जिसमें कई कोर और बड़ी DRAM होती है; यह NUMA-आधारित आर्किटेक्चर मल्टी-प्रोसेसिंग आर्किटेक्चर जैसे रेडिस के लिए बहुत अच्छा है क्योंकि यह छोटे नोड्स के नेटवर्क की तरह व्यवहार करता है। लेकिन NUMA मल्टीथ्रेडेड आर्किटेक्चर के लिए अधिक चुनौतीपूर्ण है, और अन्य मल्टीथ्रेडेड परियोजनाओं के साथ हमारे अनुभव से, NUMA इन-मेमोरी डेटास्टोर के प्रदर्शन को 80% तक कम कर सकता है।
- स्टोरेज थ्रूपुट सीमाएं - AWS EBS जैसे बाहरी डिस्क, मेमोरी और CPU जितनी तेजी से स्केल नहीं करते। वास्तव में, उपयोग की जा रही मशीन क्लास के आधार पर क्लाउड सेवा प्रदाताओं द्वारा स्टोरेज थ्रूपुट सीमाएं लगाई जाती हैं। इसलिए, पहले से वर्णित मुद्दों से बचने और उच्च डेटा-पर्सिस्टेंस आवश्यकताओं को पूरा करने के लिए क्लस्टर को प्रभावी ढंग से स्केल करने का एकमात्र तरीका क्षैतिज स्केलिंग का उपयोग करना है, यानी, अधिक नोड्स और अधिक नेटवर्क-अटैच्ड डिस्क जोड़कर।
- एफेमेरल डिस्क - एक एफेमेरल डिस्क रेडिस ऑन SSD चलाने का एक शानदार तरीका है (जहां SSD का उपयोग DRAM प्रतिस्थापन के रूप में किया जाता है, लेकिन लगातार स्टोरेज के रूप में नहीं) और डिस्क-आधारित डेटाबेस की लागत का आनंद लेते हुए रेडिस गति बनाए रखें (देखें कि हम रेडिस ऑन फ्लैश के साथ यह कैसे करते हैं)। फिर, जब एफेमेरल डिस्क अपनी सीमा तक पहुंच जाता है, तो अपने क्लस्टर को स्केल करने का सबसे अच्छा तरीका, और कई मामलों में एकमात्र तरीका, अधिक नोड्स और अधिक एफेमेरल डिस्क जोड़कर है।
- कमोडिटी हार्डवेयर - अंत में, हमारे कई ऑन-प्रिमाइसेस ग्राहक हैं जो स्थानीय डेटा सेंटर, निजी क्लाउड, और यहां तक कि छोटे एज डेटा सेंटर में चला रहे हैं; इन वातावरणों में, 64 GB से अधिक मेमोरी और 8 CPUs वाली मशीनें ढूंढना कठिन हो सकता है, और फिर से स्केल करने का एकमात्र तरीका क्षैतिज है।
सारांश
हम अपने समुदाय द्वारा पेश किए गए नई लहर की मल्टीथ्रेडेड परियोजनाओं द्वारा ताजा, दिलचस्प विचारों और प्रौद्योगिकियों की सराहना करते हैं। यह भी संभव है कि इनमें से कुछ अवधारणाएं भविष्य में रेडिस में अपना रास्ता बना लें (जैसे io_uring जिसे हम पहले से ही देख रहे हैं, अधिक आधुनिक डिक्शनरी, थ्रेड्स का अधिक सामरिक उपयोग, आदि)। लेकिन निकट भविष्य के लिए, हम उस शेयर्ड-नथिंग, मल्टी-प्रोसेस आर्किटेक्चर के मूल सिद्धांत को नहीं छोड़ेंगे जो रेडिस प्रदान करता है। यह डिज़ाइन सर्वोत्तम प्रदर्शन, स्केलिंग, और रेजिलिएंसी प्रदान करता है जबकि एक इन-मेमोरी, रीयल-टाइम डेटा प्लेटफॉर्म द्वारा आवश्यक विभिन्न परिनियोजन आर्किटेक्चर का समर्थन भी करता है।
परिशिष्ट रेडिस 7.0 बनाम ड्रैगनफ्लाई बेंचमार्क विवरण
बेंचमार्क सारांश
संस्करण:
- हमने रेडिस 7.0.0 का उपयोग किया और इसे स्रोत से बनाया
- ड्रैगनफ्लाई को 3 जून को स्रोत से बनाया गया था (hash=e806e6ccd8c79e002f721a1a5ecb847bd7a06489) जैसा कि https://github.com/Dragonfly/dragonfly#building-from-source में अनुशंसित है
लक्ष्य:
- सत्यापित करें कि ड्रैगनफ्लाई परिणाम पुनरुत्पादन योग्य हैं और उन पूर्ण शर्तों को निर्धारित करें जिनमें उन्हें प्राप्त किया गया था (यह देखते हुए कि memtier_benchmark पर कुछ कॉन्फ़िगरेशन गायब थे, OS संस्करण, आदि... ) अधिक यहां देखें
- AWS c6gn.16xlarge इंस्टेंस पर सर्वोत्तम प्राप्त करने योग्य OSS रेडिस 7.0.0 क्लस्टर प्रदर्शन निर्धारित करें, ड्रैगनफ्लाई के बेंचमार्क से मेल खाते हुए
क्लाइंट कॉन्फ़िगरेशन:
- OSS रेडिस 7.0 समाधान के लिए रेडिस क्लस्टर के लिए बड़ी संख्या में खुले कनेक्शन की आवश्यकता थी, क्योंकि प्रत्येक memtier_benchmark थ्रेड सभी शार्ड से जुड़ा हुआ है
- OSS रेडिस 7.0 समाधान ने दो memtier_benchmark प्रोसेस के साथ सर्वोत्तम परिणाम प्रदान किए जो बेंचमार्क चला रहे थे लेकिन ड्रैगनफ्लाई बेंचमार्क से मेल खाने के लिए एक ही क्लाइंट VM पर)
संसाधन उपयोग और इष्टतम कॉन्फ़िगरेशन:
- OSS रेडिस क्लस्टर ने 40 प्राथमिक शार्ड के साथ सर्वोत्तम परिणाम प्राप्त किया, जिसका अर्थ है VM पर 24 अतिरिक्त vCPU। हालांकि मशीन पूरी तरह से उपयोग नहीं की गई थी, हमने पाया कि शार्ड की संख्या बढ़ाने से मदद नहीं मिली, बल्कि समग्र प्रदर्शन कम हो गया। हम अभी भी इस व्यवहार की जांच कर रहे हैं।
- दूसरी ओर, ड्रैगनफ्लाई समाधान ने सभी 64 VCPUs के साथ VM को पूरी तरह से टॉप अप किया और 100% उपयोग तक पहुंच गया।
- दोनों समाधानों के लिए, हमने सर्वोत्तम संभव परिणाम प्राप्त करने के लिए क्लाइंट कॉन्फ़िगरेशन को विविध किया। जैसा कि नीचे देखा जा सकता है, हम ड्रैगनफ्लाई डेटा के अधिकांश को दोहराने में कामयाब रहे और पाइपलाइन 30 के बराबर होने पर सर्वोत्तम परिणामों को पार कर गए।
- इसका मतलब है कि रेडिस के साथ हमारे द्वारा प्राप्त संख्याओं को और बढ़ाने की क्षमता है।
अंत में, हमने यह भी पाया कि दोनों रेडिस और ड्रैगनफ्लाई नेटवर्क PPS या बैंडविड्थ द्वारा सीमित नहीं थे, क्योंकि हमने पुष्टि की कि 2 उपयोग किए गए VMs (क्लाइंट और सर्वर के लिए, दोनों c6gn.16xlarge का उपयोग करके) हम > 10M PPS और >30 Gbps तक TCP के लिए ~300B पेलोड के साथ पहुंच सकते हैं।
परिणामों का विश्लेषण
- GET पाइपलाइन 1 सब-मिलीसेकंड:
- OSS रेडिस: 4.43M ops/sec, जहां औसत और p50 दोनों ने सब-मिलीसेकंड लेटेंसी प्राप्त की। औसत क्लाइंट लेटेंसी 0.383 ms थी
- ड्रैगनफ्लाई ने 4M ops/sec का दावा किया:
- हम 3.8M ops/sec पुनरुत्पादित करने में कामयाब रहे, औसत क्लाइंट लेटेंसी 0.390 ms के साथ
- रेडिस बनाम ड्रैगनफ्लाई - रेडिस थ्रूपुट ड्रैगनफ्लाई के दावा किए गए परिणामों से 10% अधिक और ड्रैगनफ्लाई परिणामों से 18% अधिक है, जिन्हें हम पुनरुत्पादित करने में सक्षम थे।
- GET पाइपलाइन 30:
- OSS रेडिस: 22.9M ops/sec औसत क्लाइंट लेटेंसी 2.239 ms के साथ
- ड्रैगनफ्लाई ने 15M ops/sec का दावा किया:
- हम 15.9M ops/sec पुनरुत्पादित करने में कामयाब रहे, औसत क्लाइंट लेटेंसी 3.99 ms के साथ
- रेडिस बनाम ड्रैगनफ्लाई - रेडिस 43% बेहतर है (ड्रैगनफ्लाई पुनरुत्पादित परिणामों के मुकाबले) और 52% (ड्रैगनफ्लाई के दावा किए गए परिणामों के मुकाबले)
- SET पाइपलाइन 1 सब-मिलीसेकंड:
- OSS रेडिस: 4.74M ops/sec, जहां औसत और p50 दोनों ने सब-मिलीसेकंड लेटेंसी प्राप्त की। औसत क्लाइंट लेटेंसी 0.391 ms थी
- ड्रैगनफ्लाई ने 4M ops/sec का दावा किया:
- हम 4M ops/sec पुनरुत्पादित करने में कामयाब रहे, औसत क्लाइंट लेटेंसी 0.500 ms के साथ
- रेडिस बनाम ड्रैगनफ्लाई - रेडिस 19% बेहतर है (हमने वही परिणाम पुनरुत्पादित किए जो ड्रैगनफ्लाई ने दावा किया था)
- SET पाइपलाइन 30:
- OSS रेडिस: 19.85M ops/sec, औसत क्लाइंट लेटेंसी 2.879 ms के साथ
- ड्रैगनफ्लाई ने 10M ops/sec का दावा किया:
- हम 14M ops/sec पुनरुत्पादित करने में कामयाब रहे, औसत क्लाइंट लेटेंसी 4.203 ms के साथ)
- रेडिस बनाम ड्रैगनफ्लाई - रेडिस 42% बेहतर है (ड्रैगनफ्लाई पुनरुत्पादित परिणामों के मुकाबले) और 99% (ड्रैगनफ्लाई के दावा किए गए परिणामों के मुकाबले)
memtier_benchmark कमांड प्रत्येक विविधता के लिए उपयोग किए गए:
- GET पाइपलाइन 1 सब-मिलीसेकंड
- रेडिस:
- 2X: memtier_benchmark –ratio 0:1 -t 24 -c 1 –test-time 180 –distinct-client-seed -d 256 –cluster-mode -s 10.3.1.88 –port 30001 –key-maximum 1000000 –hide-histogram
- ड्रैगनफ्लाई:
- memtier_benchmark –ratio 0:1 -t 55 -c 30 -n 200000 –distinct-client-seed -d 256 -s 10.3.1.6 –key-maximum 1000000 –hide-histogram
- रेडिस:
- GET पाइपलाइन 30
- रेडिस:
- 2X: memtier_benchmark –ratio 0:1 -t 24 -c 1 –test-time 180 –distinct-client-seed -d 256 –cluster-mode -s 10.3.1.88 –port 30001 –key-maximum 1000000 –hide-histogram –pipeline 30
- ड्रैगनफ्लाई:
- memtier_benchmark –ratio 0:1 -t 55 -c 30 -n 200000 –distinct-client-seed -d 256 -s 10.3.1.6 –key-maximum 1000000 –hide-histogram –pipeline 30
- memtier_benchmark –ratio 0:1 -t 55 -c 30 -n 200000 –distinct-client-seed -d 256 -s 10.3.1.6 –key-maximum 1000000 –hide-histogram –pipeline 30
- रेडिस:
- SET पाइपलाइन 1 सब-मिलीसेकंड
- रेडिस:
- 2X: memtier_benchmark –ratio 1:0 -t 24 -c 1 –test-time 180 –distinct-client-seed -d 256 –cluster-mode -s 10.3.1.88 –port 30001 –key-maximum 1000000 –hide-histogram
- ड्रैगनफ्लाई:
- memtier_benchmark –ratio 1:0 -t 55 -c 30 -n 200000 –distinct-client-seed -d 256 -s 10.3.1.6 –key-maximum 1000000 –hide-histogram
- memtier_benchmark –ratio 1:0 -t 55 -c 30 -n 200000 –distinct-client-seed -d 256 -s 10.3.1.6 –key-maximum 1000000 –hide-histogram
- रेडिस:
- SET पाइपलाइन 30
- रेडिस:
- 2X: memtier_benchmark –ratio 1:0 -t 24 -c 1 –test-time 180 –distinct-client-seed -d 256 –cluster-mode -s 10.3.1.88 –port 30001 –key-maximum 1000000 –hide-histogram –pipeline 30
- ड्रैगनफ्लाई:
- memtier_benchmark –ratio 1:0 -t 55 -c 30 -n 200000 –distinct-client-seed -d 256 -s 10.3.1.6 –key-maximum 1000000 –hide-histogram –pipeline 30
- रेडिस:
इंफ्रास्ट्रक्चर विवरण
हमने क्लाइंट (memtier_benchmark चलाने के लिए) और सर्वर (रेडिस और ड्रैगनफ्लाई चलाने के लिए) दोनों के लिए समान VM प्रकार का उपयोग किया, यहां स्पेक है:
- VM:
- AWS c6gn.16xlarge
- aarch64
- ARM Neoverse-N1
- कोर प्रति सॉकेट: 64
- थ्रेड प्रति कोर: 1
- NUMA नोड: 1
- AWS c6gn.16xlarge
- कर्नेल: Arm64 कर्नेल 5.10
- इंस्टॉल्ड मेमोरी: 126GB