हम RediSearch 2.0 के विकास में पहले मील के पत्थर की रिलीज की घोषणा करते हुए खुश हैं। RediSearch एक रीयल-टाइम खोज इंजन है जो आपको अपने Redis डेटा को क्वेरी करके विभिन्न प्रकार के जटिल सवालों के जवाब देने देता है।
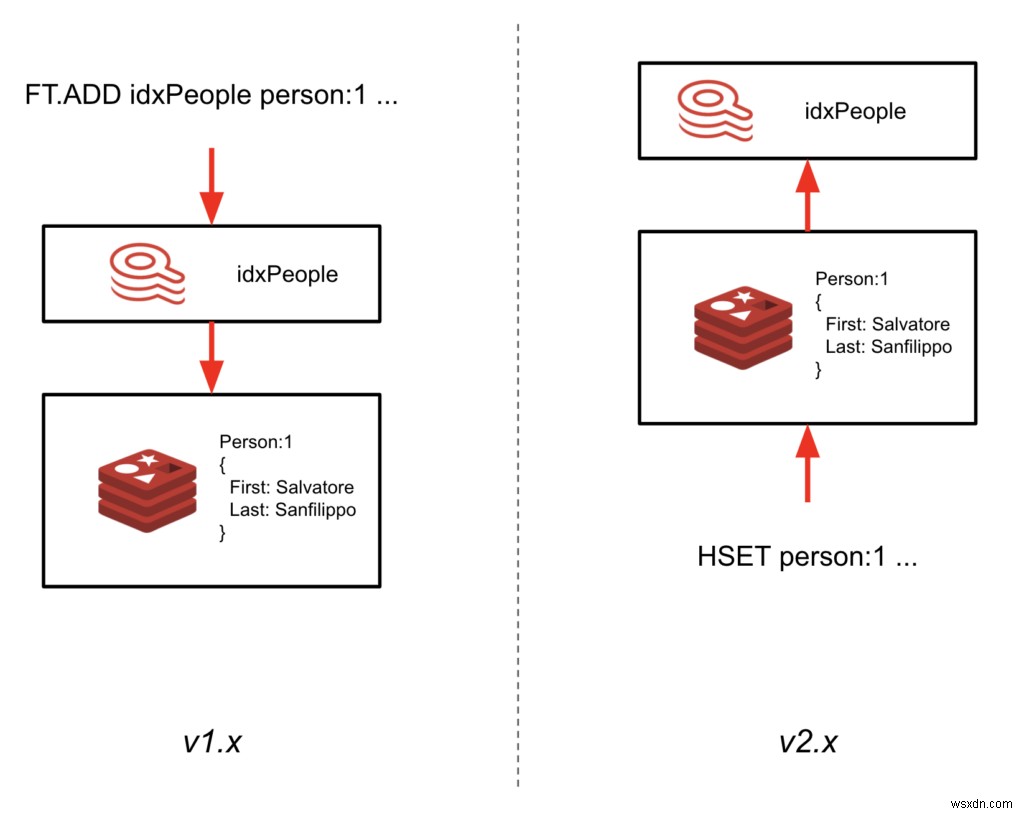
इस मील के पत्थर, जिसे 2.0-M01 नाम दिया गया है, इंडेक्स को डेटा के साथ सिंक में रखने के तरीके का पुन: आर्किटेक्चर करता है। इंडेक्स के माध्यम से डेटा लिखने के बजाय (FT.ADD कमांड का उपयोग करके), RediSearch अब हैश में लिखे गए डेटा का अनुसरण करेगा और स्वचालित रूप से इसे इंडेक्स करेगा।
यहां बड़ा फायदा यह है कि अब आप अपने मौजूदा Redis इंस्टेंस में RediSearch जोड़ सकते हैं और अपने एप्लिकेशन कोड को अपडेट किए बिना एक सेकेंडरी इंडेक्स बना सकते हैं। यह आपको बस RediSearch मॉड्यूल लोड करके और स्कीमा को परिभाषित करके अपने मौजूदा डेटा पर तुरंत RediSearch का उपयोग शुरू करने देता है। RediSearch 2.0 की सामान्य उपलब्धता इस पतझड़ में अपेक्षित है।
(नोट: यह नई सुविधा API में कुछ बदलाव लाती है (नीचे सूचीबद्ध)। हम जितना संभव हो सके बैकवर्ड संगतता बनाए रखने की कोशिश करते हैं, लेकिन इस मामले में यह संभव नहीं था। हम ग्राहक प्रतिक्रिया एकत्र करते हुए आगे बढ़ते हुए समायोजन और सुधार करने की योजना बना रहे हैं।)
API परिवर्तन
जैसा कि ऊपर उल्लेख किया गया है, इस RediSearch 2.0 मील के पत्थर में API में कई बदलाव शामिल हैं:
- इंडेक्स अब की स्पेस में नहीं रहता। यदि आपने डेटाबेस में इंडेक्स सूचीबद्ध करने के लिए इंडेक्स कुंजी (idx:<इंडेक्स नाम>) का उपयोग किया, उदाहरण के लिए, यह अब काम नहीं करेगा। हालांकि, हमने डेटाबेस में सभी इंडेक्स वापस करने के लिए एक कमांड FT._LIST पेश किया।
- इंडेक्स को प्रीफिक्स/फिल्टर के साथ बनाया जाना चाहिए। ये निर्दिष्ट करते हैं कि कौन से दस्तावेज़ RediSearch द्वारा स्वचालित रूप से इंडेक्स किए जाएंगे। आप एक साधारण प्रीफिक्स और/या एक जटिल फिल्टर एक्सप्रेशन निर्दिष्ट कर सकते हैं।
- अपग्रेड संभव नहीं हैं। यदि आपके पास RediSearch के पुराने संस्करण के साथ बनाया गया RDB है, तो RediSearch 2.0 इसे पढ़ने में सक्षम नहीं होगा। वर्तमान में, आपको पूरे डेटा सेट को पुनः इंडेक्स करना होगा। हालाँकि, हम GA रिलीज के लिए एक अपग्रेड प्रक्रिया पर काम कर रहे हैं।
- यह केवल Redis 6 और इसके बाद के संस्करण के साथ काम करता है।
- FT कमांड को उनके Redis-समकक्ष कमांड में मैप किया गया था। यह मौजूदा एप्लिकेशन को अभी भी RediSearch 2.0 के साथ काम करने की अनुमति देता है। मैपिंग इस प्रकार हैं:
- FT.ADD => HSET
- FT.DEL => DEL (डिफ़ॉल्ट रूप से DD)
- FT.GET => HGETALL
- FT.MGET => HGETALL
- इनवर्टेड इंडेक्स अब RDB में सहेजा नहीं जाता है. इसका मतलब यह नहीं है कि स्थिरता समर्थित नहीं है। RediSearch RDB में इंडेक्स परिभाषा को सहेजता है और Redis शुरू होने के बाद पृष्ठभूमि में डेटा को इंडेक्स करता है। आप FT.INFO कमांड का उपयोग करके इंडेक्सिंग स्थिति की जांच करके पता लगा सकते हैं कि पुन: इंडेक्सिंग कब समाप्त होती है।
नया API
API का सबसे बड़ा अपडेट यह है कि इंडेक्स कैसे बनाए जाते हैं। RediSearch 2.0 में इंडेक्स बनाने के लिए कमांड FT.CREATE का उपयोग किया जाता है। API में जोड़ को यहां पीले रंग में हाइलाइट किया गया है:
FT.CREATE {index} ON {structure} [PREFIX {count} {prefix} [{prefix} ..] [FILTER {filter}] [LANGUAGE_FIELD {lang_field}] [LANGUAGE {lang}] [SCORE_FIELD {score_field}] [SCORE {score}] [PAYLOAD_FIELD {payload_field}] [TEMPORARY {seconds}] [MAXTEXTFIELDS] [NOOFFSETS] [NOHL] [NOFIELDS] [NOFREQS] [STOPWORDS {num} {stopword} ...] SCHEMA {field} [TEXT [NOSTEM] [WEIGHT {weight}] [PHONETIC {matcher}] | NUMERIC | GEO | TAG [SEPARATOR {sep}] ] [SORTABLE][NOINDEX] ...
आइए कुछ विवरणों में गोता लगाएँ:
- ON {structure} वर्तमान में केवल HASH का समर्थन करता है
- PREFIX {count} {prefix} इंडेक्स को बताता है कि उसे किन कुंजियों को इंडेक्स करना चाहिए। आप इंडेक्स करने के लिए कई प्रीफिक्स जोड़ सकते हैं। चूंकि तर्क वैकल्पिक है, डिफ़ॉल्ट * है (सभी कुंजियाँ)
- FILTER {filter} पूर्ण RediSearch एकत्रीकरण एक्सप्रेशन भाषा के साथ एक फिल्टर एक्सप्रेशन है। @__key का उपयोग करके अभी जोड़ी गई/बदली गई कुंजी को एक्सेस करना संभव है
- LANGUAGE और SCORE आपको इंडेक्स किए गए सभी दस्तावेजों के लिए डिफ़ॉल्ट भाषा और स्कोर को ओवरराइड करने देते हैं
- LANGUAGE_FIELD, SCORE_FIELD, और PAYLOAD_FIELD आपको दस्तावेज़-विशिष्ट भाषा और स्कोरिंग रखने की अनुमति देते हैं, और पेलोड को दस्तावेज़ के भीतर एक फ़ील्ड के रूप में उपयोग करने देते हैं।
अन्य सीमाएं और परिवर्तन
RediSearch 2.0-M01 मील का पत्थर कुछ अन्य अपडेट भी लाता है:
- NOSAVE अब समर्थित नहीं है।
- हैश को अपडेट करने का अर्थ है कि संपूर्ण दस्तावेज़ इंडेक्स किया जाएगा (कीस्पेस नोटिफिकेशन यह संबोधित नहीं करते कि कौन से फ़ील्ड बदले गए थे)। इसलिए आंशिक अपडेट धीमे होंगे। ध्यान दें कि हम अभी भी इन स्थितियों में प्रदर्शन सुधार के विकल्पों की जांच कर रहे हैं।
- फ़ील्ड नाम अब केस-संवेदनशील हैं, इसलिए "FOO" फ़ील्ड घोषित करना और इसे "foo" के रूप में इंडेक्स करना काम नहीं करेगा।
- FT.ADD कमांड को hset में मैप किया जाएगा जैसा कि यहां दिखाया गया है:
FT.ADD idx doc1 1.0 LANGUAGE eng PAYLOAD payload FIELDS f1 v1 f2 v2
इससे मैप किया गया है
HSET doc1 __score 1.0 __language eng __payload payload f1 v1 f2 v2
इसका मतलब है कि आपके इंडेक्स पर स्कोर, भाषा, और पेलोड फ़ील्ड को क्रमशः __score, __language, __payload कहा जाना चाहिए ताकि मैपिंग अपेक्षा के अनुरूप काम करे।
- FT.ADDHASH अब समर्थित नहीं है। HSET का उपयोग करें।
- FT.OPTIMIZE अब समर्थित नहीं है, RediSearch गार्बेज कलेक्शन फ़ंक्शन इंडेक्स को ऑप्टिमाइज़ करने के लिए जिम्मेदार है।
निष्कर्ष
हम इन परिवर्तनों के बारे में वास्तव में उत्साहित हैं क्योंकि अब आप अपने मौजूदा Redis डेटाबेस में RediSearch लोड कर सकते हैं और अपने मौजूदा डेटा को इंडेक्स कर सकते हैं जो हैश में रहता है, बिना अपने एप्लिकेशन लॉजिक को अपडेट किए जब इन दस्तावेजों में हेरफेर किया जाता है। आप GitHub से सोर्स कोड लेकर या 1:99:1 RedisSarch Docker इमेज का उपयोग करके इस मील के पत्थर रिलीज को आज़मा सकते हैं। यह संस्करण अभी तक प्रोडक्शन-रेडी नहीं है, लेकिन हम इसे अभी आपके साथ साझा करना चाहते थे ताकि आपकी प्रतिक्रिया एकत्र कर सकें। कृपया कोई भी टिप्पणी या समस्या हमारे GitHub रिपॉजिटरी या Redis कम्युनिटी फोरम पर साझा करें।