RediSearch, Redis के लिए फुल-टेक्स्ट खोज क्षमताओं के साथ एक रियल-टाइम सेकेंडरी इंडेक्स, सबसे परिपक्व और फीचर-रिच Redis मॉड्यूल में से एक है। यह हर दिन और भी अधिक लोकप्रिय हो रहा है - पिछले कुछ महीनों में RediSearch Docker पुल्स में 500% की वृद्धि हुई है! वह बढ़ती लोकप्रियता ग्राहकों को रियल-टाइम इन्वेंट्री मैनेजमेंट से लेकर एफेमेरल खोज तक दिलचस्प उपयोग मामलों की एक विस्तृत विविधता के साथ आने के लिए प्रेरित कर रही है।
उस गति को बढ़ाने के लिए, हम अब RediSearch 2.0 के सार्वजनिक पूर्वावलोकन को पेश कर रहे हैं, जिसे डेवलपर अनुभव को बेहतर बनाने और RediSearch का सबसे स्केलेबल संस्करण होने के लिए डिज़ाइन किया गया है। RediSearch 2.0 Redis के एक्टिव-एक्टिव जियो-डिस्ट्रीब्यूशन तकनीक का समर्थन करता है, डाउनटाइम के बिना स्केलेबल है, और Redis ऑन फ्लैश समर्थन शामिल करता है (वर्तमान में निजी पूर्वावलोकन में)। उन लक्ष्यों को प्रदर्शन को नकारात्मक रूप से प्रभावित किए बिना पूरा करने के लिए, हमने RediSearch 2.0 के लिए एक बिल्कुल नई आर्किटेक्चर बनाई - और यह काम किया: RediSearch 2.0, RediSearch 1.6 से 2.4x तेज़ है।
RediSearch 2.0 की नई आर्किटेक्चर के अंदर
आपके Redis डेटाबेस में एक समृद्ध क्वेरी-और-एग्रीगेशन इंजन होने से कैशिंग से परे कई नए उपयोग के मामले सक्षम होते हैं। RediSearch आपको जटिल क्वेरी का उपयोग करके डेटा तक पहुंचने की आवश्यकता होने पर Redis को अपने प्राथमिक डेटाबेस के रूप में उपयोग करने देता है। और भी बेहतर, यह Redis की विश्व-स्तरीय गति, विश्वसनीयता, और स्केलेबिलिटी को संरक्षित करता है, और आपको डेटा को अपडेट और इंडेक्स करने के लिए कोड में जटिलता जोड़ने की आवश्यकता नहीं होती है।
RediSearch 2.0 के लिए हमने इंडेक्स को डेटा के साथ सिंक में रखने के तरीके को फिर से आर्किटेक्ट किया। इंडेक्स के माध्यम से डेटा लिखने (FT.ADD कमांड का उपयोग करके) के बजाय, RediSearch अब हैश में लिखे गए डेटा का अनुसरण करता है और सिंक्रोनस रूप से इसे इंडेक्स करता है। यह पुन: आर्किटेक्चर API में कई बदलावों के साथ आता है, जिन पर हमने पिछले पोस्ट में चर्चा की थी जब RediSearch 2.0 ने अपना पहला मील का पत्थर हासिल किया था।
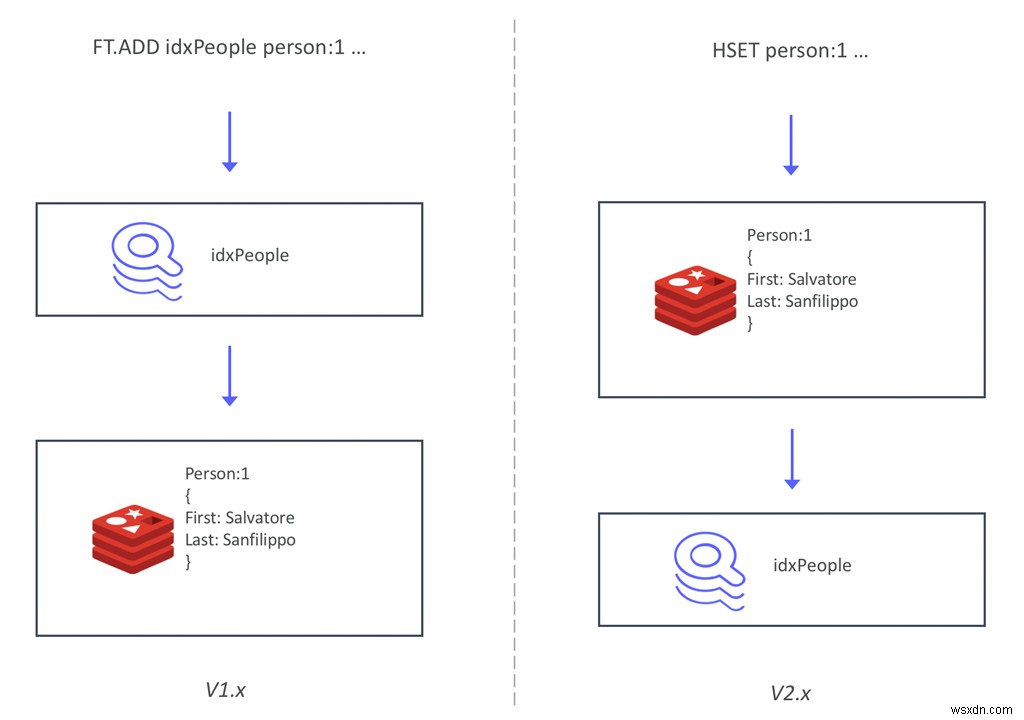
यह नई आर्किटेक्चर दो मुख्य लाभ लाती है। पहला, अपने मौजूदा डेटा के शीर्ष पर एक सेकेंडरी इंडेक्स बनाना अब पहले से कहीं ज्यादा आसान है। आप बस अपने मौजूदा Redis डेटाबेस में RediSearch जोड़ सकते हैं, एक इंडेक्स बना सकते हैं, और इसकी क्वेरी शुरू कर सकते हैं, बिना अपने डेटा को माइग्रेट किए या इंडेक्स में डेटा जोड़ने के लिए नए कमांड का उपयोग किए बिना। यह नए RediSearch उपयोगकर्ताओं के लिए सीखने की अवस्था को काफी कम करता है और आपको अपने मौजूदा Redis डेटाबेस पर इंडेक्स बनाने देता है - बिना उन्हें पुनः आरंभ किए भी।
डेटा को इंडेक्स करने का एक नया तरीका लागू करने के अलावा, हमने इंडेक्स को कीस्पेस से बाहर भी निकाला। यह Redis Enterprise की एक्टिव-एक्टिव तकनीक को सक्षम बनाता है, जो कॉन्फ्लिक्ट-फ्री रेप्लिकेटेड डेटा टाइप्स (CRDTs) पर आधारित है। दो इनवर्टेड इंडेक्स को कॉन्फ्लिक्ट-फ्री मर्ज करना मुश्किल है, लेकिन Redis के पास पहले से ही हैश का एक सिद्ध CRDTs कार्यान्वयन है। तो इस नई आर्किटेक्चर का दूसरा बड़ा लाभ RediSearch 2.0 को और भी अधिक स्केलेबल बना रहा है। क्योंकि RediSearch अब हैश का अनुसरण करता है और इंडेक्स को कीस्पेस से बाहर ले जाया गया था, अब आप RediSearch को एक एक्टिव-एक्टिव जियो-डिस्ट्रीब्यूटेड डेटाबेस में चला सकते हैं।
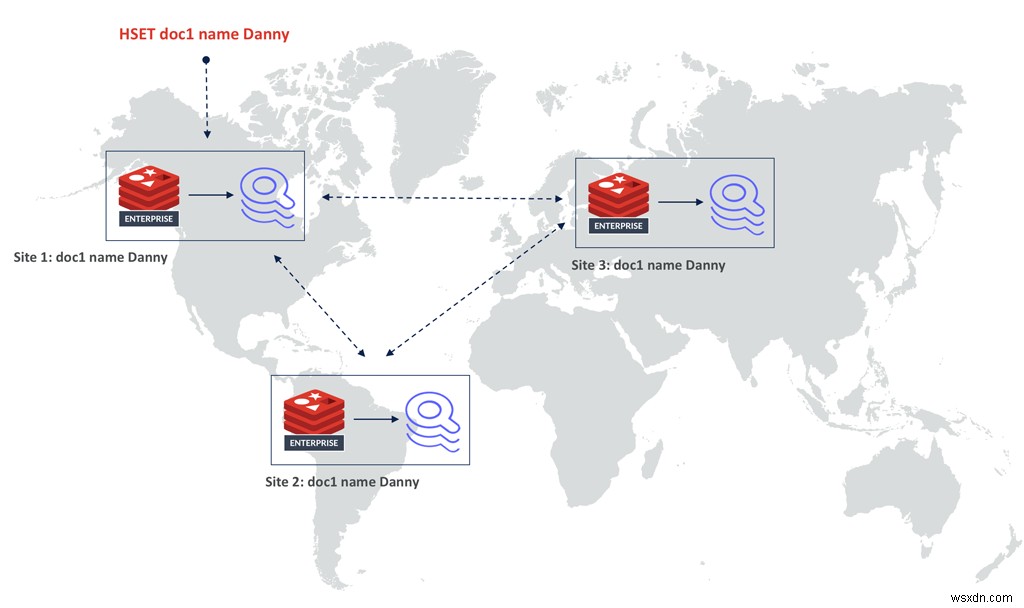
एक डॉक्यूमेंट को रेप्लिकेशन सेट में सभी डेटाबेस में एक स्ट्रॉन्गली इवेंटुअल कंसिस्टेंट तरीके से दोहराया जाएगा। प्रत्येक रेप्लिका में, RediSearch केवल हैश पर सभी अपडेट का अनुसरण करेगा, जिसका अर्थ है कि सभी इंडेक्स भी स्ट्रॉन्गली इवेंटुअल कंसिस्टेंट हैं।
ओपन सोर्स Redis के लिए OSS क्लस्टर समर्थन
हम स्केलेबिलिटी क्षमताओं को बढ़ाने को केवल Redis Enterprise उपयोगकर्ताओं तक सीमित नहीं करना चाहते थे, इसलिए हमने ओपन सोर्स Redis क्लस्टर API के साथ एकल इंडेक्स को कई शार्ड पर स्केल करने के लिए समर्थन जोड़ा। पहले, एकल RediSearch इंडेक्स, और इसके डॉक्यूमेंट, को एकल शार्ड पर रहना पड़ता था। इसका मतलब था कि OSS Redis के लिए डेटासेट आकार और थ्रूपुट एकल Redis प्रोसेस द्वारा संभाले जा सकने वाले तक सीमित था। Redis Enterprise ने क्लस्टर्ड डेटाबेस में डॉक्यूमेंट वितरित करने और क्वेरी समय पर परिणामों को एकत्रित करने की क्षमता की पेशकश की। यह फैन-आउट और एकत्रीकरण एक घटक द्वारा संभाला जाता है जिसे "कोऑर्डिनेटर" कहा जाता है जो अब Redis सोर्स अवेलेबल लाइसेंस के तहत सार्वजनिक रूप से उपलब्ध है इसलिए यह ओपन सोर्स Redis क्लस्टर के साथ-साथ Redis Enterprise के साथ भी काम करेगा। परिणाम अब तक का RediSearch का सबसे स्केलेबल संस्करण है।
मुझे नंबर दिखाओ!
RediSearch 2.0 के इंजेशन प्रदर्शन का आकलन करने के लिए, हमने अपने फुल-टेक्स्ट खोज बेंचमार्क (FTSB) सूट को सार्वजनिक रूप से उपलब्ध NYC टैक्सी डेटासेट के साथ विस्तारित किया। इस डेटासेट का उपयोग उद्योग भर में इसके समृद्ध डेटा प्रकारों (टेक्स्ट, टैग, भौगोलिक, और संख्यात्मक), और बड़ी संख्या में डॉक्यूमेंट के कारण किया जाता है।
यह बेंचमार्क राइट प्रदर्शन पर केंद्रित है, न्यूयॉर्क शहर में येलो कैब में सवारी के ट्रिप-रिकॉर्ड डेटा का उपयोग करके। विशेष रूप से इस बेंचमार्क के लिए हमने जनवरी 2015 डेटासेट का उपयोग किया, जो प्रति डॉक्यूमेंट औसतन 500 बाइट्स के साथ 12 मिलियन से अधिक डॉक्यूमेंट लोड करता है। पूर्ण बेंचमार्क विनिर्देश के लिए कृपया GitHub पर FTSB देखें।
सभी बेंचमार्क विविधताएं Amazon Web Services इंस्टेंस पर चलाई गईं, जो हमारे बेंचमार्क-परीक्षण इंफ्रास्ट्रक्चर के माध्यम से प्रोविज़न की गईं। परीक्षण 15 शार्ड के साथ 3-नोड क्लस्टर पर निष्पादित किए गए, RediSearch एंटरप्राइज संस्करण 1.6 और 2.0 के साथ। बेंचमार्किंग क्लाइंट और RediSearch सक्षम डेटाबेस वाले 3 नोड्स दोनों अलग-अलग c5.9xlarge इंस्टेंस पर चल रहे थे।
चूंकि RediSearch 2.0 Redis में हैश में परिवर्तनों का अनुसरण करने और स्वचालित रूप से उन्हें इंडेक्स करने की क्षमता के साथ आता है, हमने FT.ADD और HSET कमांड के लिए वेरिएंट जोड़े हैं। अपग्रेड को आसान बनाने के लिए, हमने अब अप्रचलित FT.ADD कमांड को RediSearch 2.0 में HSET कमांड पर रीमैप किया है। नीचे दिए गए दो चार्ट RediSearch 1.6 और RediSearch 2.0 दोनों के लिए समग्र इंजेशन दर और लेटेंसी प्रदर्शित करते हैं, जबकि सब-मिलीसेकंड लेटेंसी को बनाए रखते हैं।
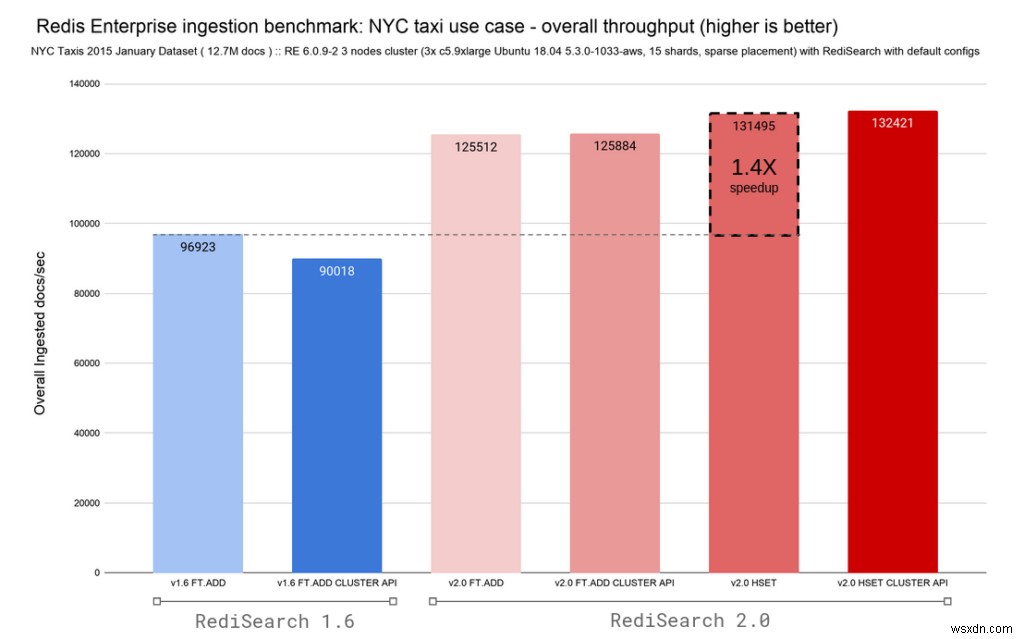
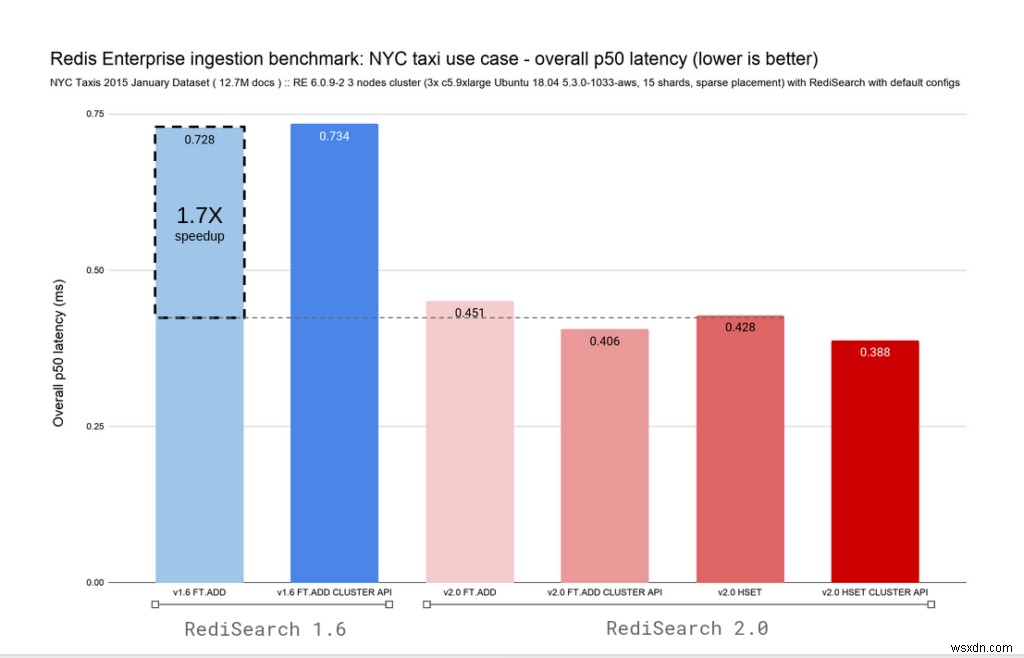
RediSearch हमेशा तेज़ रहा है, लेकिन इस आर्किटेक्चरल परिवर्तन के साथ हमने 96K डॉक्यूमेंट प्रति सेकंड इंडेक्स करने से 132K डॉक्स/सेकंड पर समग्र p50 इंजेशन लेटेंसी 0.4ms पर ले लिया है, जिससे राइट स्केलिंग में भारी सुधार हुआ है।
न केवल आप थ्रूपुट में वृद्धि से लाभान्वित होंगे, बल्कि प्रत्येक इंजेशन भी तेज़ हो जाता है। आर्किटेक्चर में परिवर्तनों के कारण समग्र इंजेशन सुधार के अलावा, अब आप अपने खोज डेटाबेस के इंजेशन को रैखिक रूप से स्केल करने के लिए OSS Redis क्लस्टर API क्षमताओं पर भी भरोसा कर सकते हैं।
थ्रूपुट और लेटेंसी सुधारों को मिलाकर, RediSearch 2.0, RediSearch 1.6 की तुलना में 2.4X तक स्पीडअप देता है।
RediSearch 2.0 के लिए आगे क्या है
संक्षेप में, RediSearch 2.0 सभी Redis उपयोगकर्ताओं के लिए अब तक जारी किया गया सबसे तेज़ और सबसे स्केलेबल संस्करण है। इसके अलावा, RediSearch 2.0 की नई आर्किटेक्चर मौजूदा डेटा के लिए Redis में इंडेक्स बनाने के डेवलपर अनुभव को एक सहज तरीके से सुधारती है और अपने Redis डेटा को किसी अन्य RediSearch-सक्षम डेटाबेस में माइग्रेट करने की आवश्यकता को हटा देती है। यह नई आर्किटेक्चर RediSearch को अन्य डेटा संरचनाओं, जैसे Streams या Strings का अनुसरण और ऑटो-इंडेक्स करने की अनुमति देती है। आगामी रिलीज़ में, यह आपको RedisJSON में नेस्टेड डेटा संरचना जैसी अतिरिक्त डेटा संरचनाओं के साथ काम करने देगा।
हम डेवलपर अनुभव को और बढ़ाने के लिए और अधिक सुविधाएं जोड़ते रहने की योजना बना रहे हैं। आगे देखें, एक नई कमांड जो आपको अपने खोज क्वेरी को प्रोफाइल करने की अनुमति देती है ताकि क्वेरी निष्पादन के दौरान प्रदर्शन बॉटलनेक कहां होते हैं, इसे बेहतर ढंग से समझा जा सके।
शुरू करने के लिए तैयार हैं? Tug Grall के ब्लॉग पर देखें … RediSearch 2.0 के साथ शुरुआत करना! फिर GitHub पर इस ट्यूटोरियल में चरणों का पालन करें या Redis Enterprise Cloud Essentials में एक मुफ्त डेटाबेस बनाएं। (ध्यान दें कि RediSearch 2.0 का सार्वजनिक पूर्वावलोकन दो Redis Enterprise Cloud Essentials क्षेत्रों में उपलब्ध है: मुंबई और ओरेगन।)