वेब स्क्रैपर बनाने की इस श्रृंखला में वापस स्वागत है। इस ट्यूटोरियल में, मैं अपनी पॉडकास्ट साइट से डेटा स्क्रैप करने का एक उदाहरण देखूंगा। मैं विस्तार से बताऊंगा कि मैंने डेटा कैसे निकाला, हेल्पर और यूटिलिटी विधियां अपना काम कैसे पूरा करती हैं, और कैसे सभी पहेली के टुकड़े एक साथ आते हैं।
विषय
- मेरा पॉडकास्ट स्क्रैप करना
- Pry
- स्क्रैपर
- हेल्पर विधियां
- पोस्ट लिखना
मेरा पॉडकास्ट स्क्रैप करना
आइए अब तक जो सीखा है उसे अभ्यास में लाएं। विभिन्न कारणों से, मेरे पॉडकास्ट Between | Screens के लिए एक रीडिज़ाइन लंबे समय से लंबित था। ऐसे मुद्दे थे जो मुझे सुबह उठते ही चिल्लाने पर मजबूर कर देते थे। इसलिए मैंने Middleman के साथ बनी एक पूरी नई स्टैटिक साइट सेट अप करने का फैसला किया और GitHub Pages के साथ होस्ट किया।
मैंने Middleman ब्लॉग को अपनी जरूरतों के अनुसार tweak करने के बाद नए डिज़ाइन पर काफी समय लगाया। जो कुछ बचा था वह था मेरे डेटाबेस-समर्थित Sinatra ऐप से कंटेंट आयात करना, इसलिए मुझे मौजूदा कंटेंट को स्क्रैप करना था और इसे अपनी नई स्टैटिक साइट में ट्रांसफर करना था।
इसे हाथ से schmuck फैशन में करना सवाल ही नहीं था—क्योंकि मैं अपने दोस्तों Nokogiri और Mechanize पर भरोसा कर सकता था जो मेरे लिए काम करेंगे। आपके सामने एक उचित रूप से छोटा स्क्रैप जॉब है जो बहुत जटिल नहीं है लेकिन कुछ दिलचस्प मोड़ प्रदान करता है जो वेब स्क्रैपिंग नौसिखियों के लिए शैक्षिक होना चाहिए।
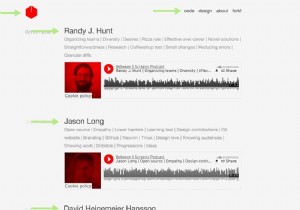
नीचे मेरे पॉडकास्ट के दो स्क्रीनशॉट हैं।
स्क्रीनशॉट पुराना पॉडकास्ट
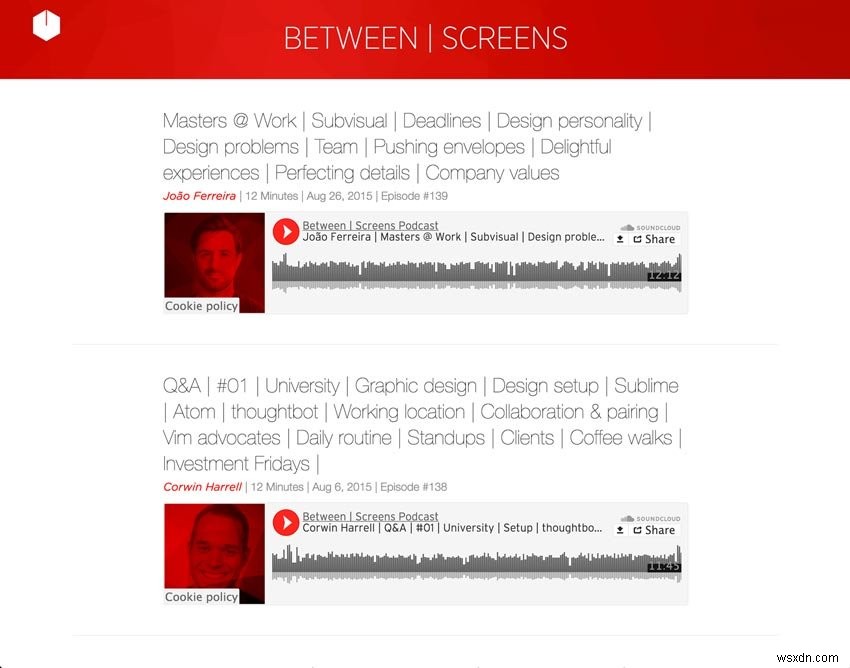
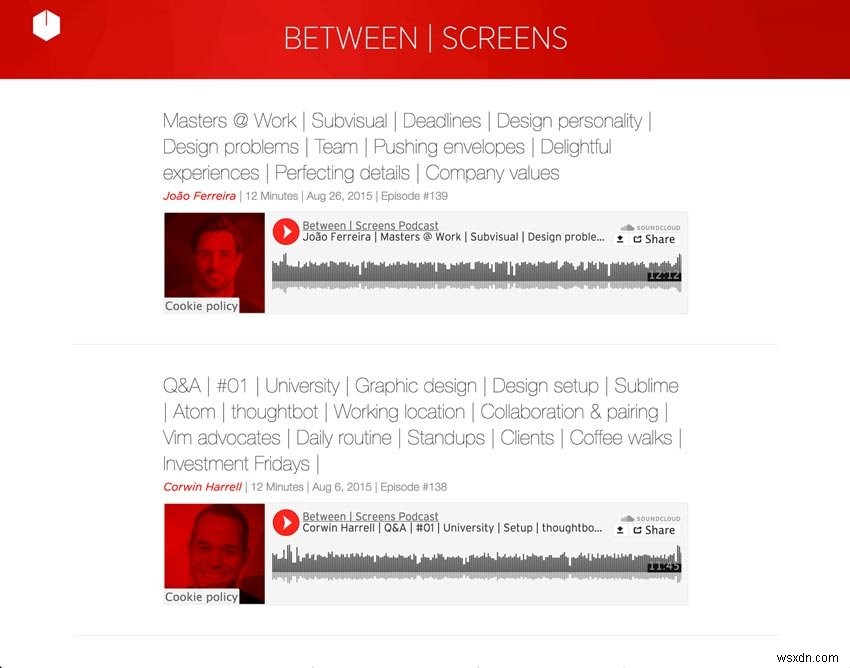
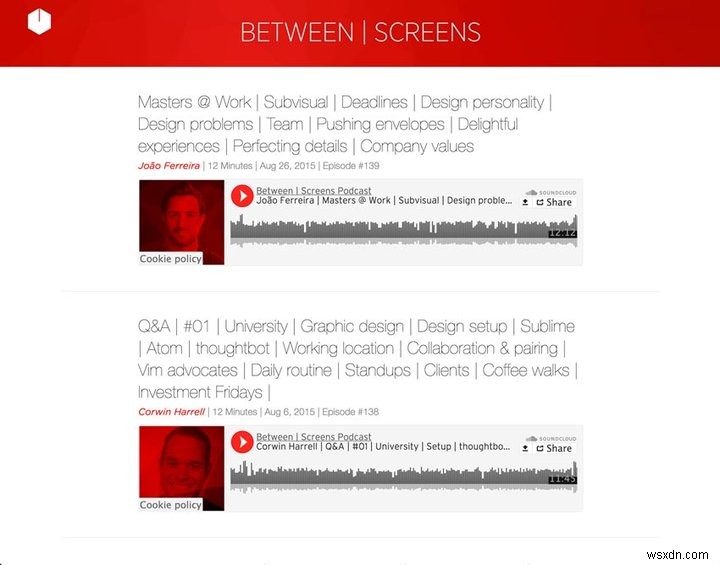
स्क्रीनशॉट नया पॉडकास्ट
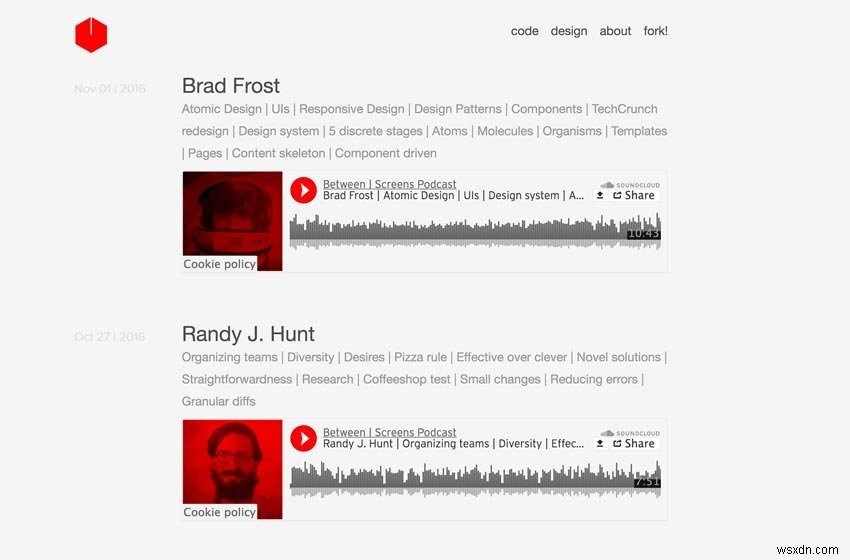
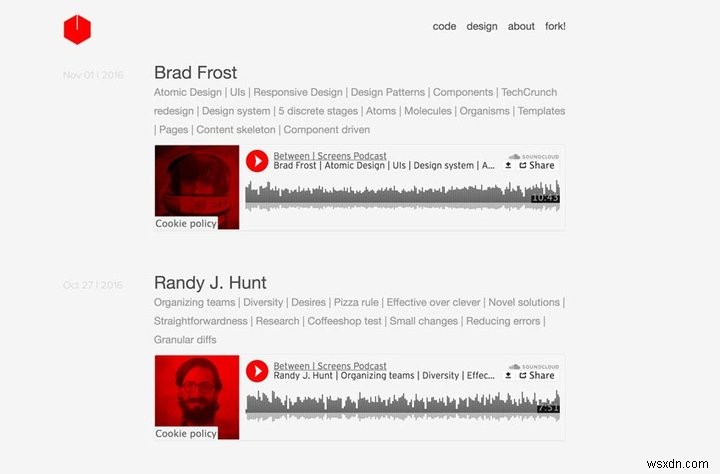
आइए देखें कि हम क्या हासिल करना चाहते हैं। हम 21 पेजिनेटेड इंडेक्स साइटों पर फैले 139 एपिसोड से निम्न डेटा निकालना चाहते हैं:
- शीर्षक
- इंटरव्यूई
- विषय सूची के साथ सबहेडर
- प्रत्येक एपिसोड के लिए साउंडक्लाउड ट्रैक नंबर
- तारीख
- एपिसोड नंबर
- शो नोट्स से टेक्स्ट
- शो नोट्स से लिंक
हम पेजिनेशन के माध्यम से पुनरावृति करते हैं और मैकेनाइज़ को प्रत्येक एपिसोड के लिए हर लिंक पर क्लिक करने देते हैं। निम्नलिखित डिटेल पेज पर, हमें उपरोक्त सभी जानकारी मिल जाएगी जिसकी हमें आवश्यकता है। उस स्क्रैप किए गए डेटा का उपयोग करके, हम प्रत्येक एपिसोड के लिए मार्कडाउन फ़ाइलों के फ्रंट मैटर और "बॉडी" को पॉपुलेट करना चाहते हैं।
नीचे आप देख सकते हैं कि हम निकाले गए कंटेंट के साथ नई मार्कडाउन फ़ाइलों को कैसे लिखेंगे। मुझे लगता है कि यह आपको हमारे आगे के दायरे के बारे में एक अच्छा विचार देगा। यह हमारे छोटे स्क्रिप्ट में अंतिम चरण का प्रतिनिधित्व करता है। चिंता न करें, हम इसे और विस्तार से देखेंगे।
def compose_markdown
def compose_markdown(options={})
  <<-HEREDOC
---
title: #{options[:interviewee]}
interviewee: #{options[:interviewee]}
topic_list: #{options[:title]}
tags: #{options[:tags]}
soundcloud_id: #{options[:sc_id]}
date: #{options[:date]}
episode_number: #{options[:episode_number]}
---
#{options[:text]}
HEREDOC
end
मैं उन कुछ ट्रिक्स को भी जोड़ना चाहता था जो पुरानी साइट नहीं खेल सकती थीं। एक अनुकूलित, व्यापक टैगिंग सिस्टम होना मेरे लिए महत्वपूर्ण था। मैं श्रोताओं को एक गहरी खोज उपकरण देना चाहता था। इसलिए, मुझे हर इंटरव्यूई के लिए टैग की आवश्यकता थी और सबहेडर को टैग में विभाजित करना था। चूंकि मैंने अकेले पहले सीज़न में 139 एपिसोड बनाए थे, इसलिए मुझे साइट को उस समय के लिए तैयार करना था जब कंटेंट की मात्रा को छानना कठिन हो जाए। बुद्धिमानी से रखी गई सिफारिशों के साथ एक गहरी टैगिंग प्रणाली जाने का रास्ता था। इसने मुझे साइट को हल्का और तेज़ रखने की अनुमति दी।
आइए मेरी साइट के कंटेंट को स्क्रैप करने के लिए पूर्ण कोड पर एक नज़र डालें। चारों ओर देखें और यह पता लगाने की कोशिश करें कि क्या हो रहा है इसकी बड़ी तस्वीर। चूंकि मुझे उम्मीद है कि आप चीजों के शुरुआती पक्ष पर हैं, मैं बहुत अधिक अमूर्त करने से दूर रहा और स्पष्टता के पक्ष में गलती की। मैंने कुछ रीफैक्टरिंग की जो कोड स्पष्टता की सहायता के लिए लक्षित थे, लेकिन मैंने आपके लिए जब आप इस लेख के साथ समाप्त हो जाते हैं तो खेलने के लिए हड्डी पर थोड़ा मांस भी छोड़ दिया। आखिरकार, गुणवत्तापूर्ण सीख तब होती है जब आप पढ़ने से आगे जाते हैं और अपने दम पर कुछ कोड के साथ खिलवाड़ करते हैं।
रास्ते में, मैं आपको अपने सामने कोड को कैसे सुधार सकते हैं, इस बारे में सोचना शुरू करने के लिए अत्यधिक प्रोत्साहित करता हूं। यह इस लेख के अंत में आपका अंतिम कार्य होगा। मुझसे एक छोटा संकेत: बड़े तरीकों को छोटे तरीकों में तोड़ना हमेशा एक अच्छी शुरुआत है। एक बार जब आप समझ जाते हैं कि कोड कैसे काम करता है, तो आपको उस रीफैक्टरिंग पर ध्यान केंद्रित करने में मज़ा आएगा।
मैंने पहले से ही छोटे, केंद्रित हेल्पर्स में कई विधियों को निकालना शुरू कर दिया है। आपको अपने पिछले लेखों से कोड स्मेल्स और उनके रीफैक्टरिंग के बारे में जो सीखा है उसे आसानी से लागू करने में सक्षम होना चाहिए। यदि यह अभी भी आपके सिर के ऊपर से निकल जाता है, तो चिंता न करें—हम सभी वहां रहे हैं। बस लगे रहें, और किसी बिंदु पर चीजें तेजी से क्लिक करना शुरू कर देंगी।
पूर्ण कोड
require 'Mechanize'
require 'Pry'
require 'date'

# Helper Methods
# (Extraction Methods)
def extract_interviewee(detail_page)
  interviewee_selector = '.episode_sub_title span'
  detail_page.search(interviewee_selector).text.strip
end

def extract_title(detail_page)
  title_selector = ".episode_title"
  detail_page.search(title_selector).text.gsub(/[?#]/, '')
end

def extract_soundcloud_id(detail_page)
  sc = detail_page.iframes_with(href: /soundcloud.com/).to_s
  sc.scan(/\d{3,}/).first
end

def extract_shownotes_text(detail_page)
  shownote_selector = "#shownote_container > p"
  detail_page.search(shownote_selector)
end

def extract_subtitle(detail_page)
  subheader_selector = ".episode_sub_title"
  detail_page.search(subheader_selector).text
end

def extract_episode_number(episode_subtitle)
  number = /[#]\d*/.match(episode_subtitle)
  clean_episode_number(number)
end

# (Utility Methods)
def clean_date(episode_subtitle)
  string_date = /[^|]*([,])(.....)/.match(episode_subtitle).to_s
  Date.parse(string_date)
end

def build_tags(title, interviewee)
  extracted_tags = strip_pipes(title)
  "#{interviewee}"+ ", #{extracted_tags}"
end

def strip_pipes(text)
  tags = text.tr('|', ',')
  tags = tags.gsub(/[@?#&]/, '')
  tags.gsub(/[w\/]{2}/, 'with')
end

def clean_episode_number(number)
  number.to_s.tr('#', '')
end

def dasherize(text)
  text.lstrip.rstrip.tr(' ', '-')
end

def extract_data(detail_page)
  interviewee = extract_interviewee(detail_page)
  title = extract_title(detail_page)
  sc_id = extract_soundcloud_id(detail_page)
  text = extract_shownotes_text(detail_page)
  episode_subtitle = extract_subtitle(detail_page)
  episode_number = extract_episode_number(episode_subtitle)
  date = clean_date(episode_subtitle)
  tags = build_tags(title, interviewee)
  options = {
    interviewee: interviewee,
    title: title,
    sc_id: sc_id,
    text: text,
    tags: tags,
    date: date,
    episode_number: episode_number
  }
end

def compose_markdown(options={})
  <<-HEREDOC
---
title: #{options[:interviewee]}
interviewee: #{options[:interviewee]}
topic_list: #{options[:title]}
tags: #{options[:tags]}
soundcloud_id: #{options[:sc_id]}
date: #{options[:date]}
episode_number: #{options[:episode_number]}
---
#{options[:text]}
HEREDOC
end

def write_page(link)
  detail_page = link.click
  extracted_data = extract_data(detail_page)
  markdown_text = compose_markdown(extracted_data)
  date = extracted_data[:date]
  interviewee = extracted_data[:interviewee]
  episode_number = extracted_data[:episode_number]
  File.open("#{date}-#{dasherize(interviewee)}-#{episode_number}.html.erb.md", 'w') { |file| file.write(markdown_text) }
end

def scrape
  link_range = 1
  agent ||= Mechanize.new
  until link_range == 21
    page = agent.get("https://between-screens.herokuapp.com/?page=#{link_range}")
    link_range += 1
    page.links[2..8].map do |link|
      write_page(link)
    end
  end
end

scrape
हमने require "Nokogiri" क्यों नहीं किया? Mechanize हमें हमारी सभी स्क्रैपिंग जरूरतें प्रदान करता है। जैसा कि हमने पिछले लेख में चर्चा की थी, Mechanize Nokogiri के शीर्ष पर बनाता है और हमें कंटेंट निकालने की भी अनुमति देता है। हालांकि, पहले लेख में उस जेम को कवर करना महत्वपूर्ण था क्योंकि हमें इसके शीर्ष पर निर्माण करने की आवश्यकता थी।
Pry
पहली चीजें पहले। इससे पहले कि हम यहां अपने कोड में कूदें, मुझे लगा कि आपको यह दिखाना आवश्यक है कि आप कैसे कुशलतापूर्वक जांच सकते हैं कि आपका कोड हर कदम पर अपेक्षा के अनुरूप काम करता है। जैसा कि आपने निश्चित रूप से देखा है, मैंने मिश्रण में एक और टूल जोड़ा है। अन्य चीजों के अलावा, Pry डीबगिंग के लिए वास्तव में आसान है।
यदि आप अपने कोड में कहीं भी Pry.start(binding) रखते हैं, तो आप अपने एप्लिकेशन को ठीक उस बिंदु पर इंस्पेक्ट कर सकते हैं। आप एप्लिकेशन में विशिष्ट बिंदुओं पर ऑब्जेक्ट्स में pry कर सकते हैं। यह वास्तव में आपके एप्लिकेशन को अपने पैरों पर ठोकर खाए बिना चरण दर चरण लेने में मददगार है। उदाहरण के लिए, आइए इसे हमारे write_page फ़ंक्शन के ठीक बाद रखें और जांचें कि link वह है जिसकी हम अपेक्षा करते हैं।
Pry
...
def scrape
  link_range = 1
  agent ||= Mechanize.new
  until link_range == 21
    page = agent.get("https://between-screens.herokuapp.com/?page=#{link_range}")
    link_range += 1
    page.links[2..8].map do |link|
      write_page(link)
      Pry.start(binding)
    end
  end
end
...
यदि आप स्क्रिप्ट चलाते हैं, तो हमें ऐसा कुछ मिलेगा।
आउटपुट
»$ ruby noko_scraper.rb
321: def scrape
322: link_range = 1
323: agent ||= Mechanize.new
324:
326: until link_range == 21
327: page = agent.get("https://between-screens.herokuapp.com/?page=#{link_range}")
328: link_range += 1
329:
330: page.links[2..8].map do |link|
331: write_page(link) =>
332: Pry.start(binding)
333: end
334: end
335: end
[1] pry(main)>
जब हम फिर link ऑब्जेक्ट के लिए पूछते हैं, तो हम जांच सकते हैं कि क्या हम अन्य कार्यान्वयन विवरणों पर जाने से पहले सही ट्रैक पर हैं।
टर्मिनल
[2] pry(main)> link
=> #<Mechanize::Page::Link "Masters @ Work | Subvisual | Deadlines | Design personality | Design problems | Team | Pushing envelopes | Delightful experiences | Perfecting details | Company values" "/episodes/139">
ऐसा लगता है कि हमें जो चाहिए वह है। बढ़िया, हम आगे बढ़ सकते हैं। पूरे एप्लिकेशन के माध्यम से चरण दर चरण ऐसा करना यह सुनिश्चित करने के लिए एक महत्वपूर्ण अभ्यास है कि आप खो न जाएं और वास्तव में समझें कि यह कैसे काम करता है। मैं यहां Pry को अधिक विस्तार से कवर नहीं करूंगा क्योंकि ऐसा करने में मुझे कम से कम एक और पूरा लेख लगेगा। मैं इसे केवल मानक IRB शेल के विकल्प के रूप में उपयोग करने की सिफारिश कर सकता हूं। वापस हमारे मुख्य कार्य पर।
स्क्रैपर
अब जब आपको पहेली के टुकड़ों को जगह में रखने का मौका मिला है, तो मैं सुझाव देता हूं कि हम उन पर एक-एक करके जाएं और यहां और वहां कुछ दिलचस्प बिंदुओं को स्पष्ट करें। आइए केंद्रीय टुकड़ों से शुरू करें।
podcast_scraper.rb
...
def write_page(link)
  detail_page = link.click
  extracted_data = extract_data(detail_page)
  markdown_text = compose_markdown(extracted_data)
  date = extracted_data[:date]
  interviewee = extracted_data[:interviewee]
  episode_number = extracted_data[:episode_number]
  file_name = "#{date}-#{dasherize(interviewee)}-#{episode_number}.html.erb.md"
  File.open(file_name, 'w') { |file| file.write(markdown_text) }
end

def scrape
  link_range = 1
  agent ||= Mechanize.new
  until link_range == 21
    page = agent.get("https://between-screens.herokuapp.com/?page=#{link_range}")
    link_range += 1
    page.links[2..8].map do |link|
      write_page(link)
    end
  end
end
...
scrape विधि में क्या होता है? सबसे पहले, मैं पुराने पॉडकास्ट में हर इंडेक्स पेज पर लूप करता हूं। मैं हेरोकू ऐप से पुराने URL का उपयोग कर रहा हूं क्योंकि नई साइट पहले से ही betweenscreens.fm पर ऑनलाइन है। मेरे पास स्क्रैप करने के लिए एपिसोड के 20 पेज थे।
मैंने link_range वेरिएबल के माध्यम से लूप को सीमित किया, जिसे मैंने प्रत्येक लूप के साथ अपडेट किया। पेजिनेशन के माध्यम से जाना इस वेरिएबल को प्रत्येक पेज के URL में उपयोग करने जितना सरल था। सरल और प्रभावी।
def scrape
page = agent.get("https://between-screens.herokuapp.com/?page=#{link_range}")
फिर, जब भी मुझे स्क्रैप करने के लिए एक और आठ एपिसोड के साथ एक नया पेज मिला, मैं उन लिंक की पहचान करने के लिए page.links का उपयोग करता हूं जिन्हें हम क्लिक करना चाहते हैं और प्रत्येक एपिसोड के लिए डिटेल पेज पर फॉलो करना चाहते हैं। मैंने लिंक की एक रेंज (links[2..8]) के साथ जाने का फैसला किया क्योंकि यह हर पेज पर सुसंगत था। यह प्रत्येक इंडेक्स पेज से मुझे जिन लिंक की आवश्यकता थी उन्हें टार्गेट करने का सबसे आसान तरीका भी था। यहां CSS सेलेक्टर्स के साथ इधर-उधर घूमने की कोई जरूरत नहीं।
हम फिर उस डिटेल पेज के लिए लिंक को write_page विधि में फीड करते हैं। यहीं पर अधिकांश काम किया जाता है। हम उस लिंक को लेते हैं, उसे क्लिक करते हैं, और डिटेल पेज पर फॉलो करते हैं जहां हम उसका डेटा निकालना शुरू कर सकते हैं। उस पेज पर हमें वह सभी जानकारी मिलती है जो मुझे नई साइट के लिए अपने नए मार्कडाउन एपिसोड लिखने के लिए चाहिए।
def write_page
extracted_data = extract_data(detail_page)
def extract_data
def extract_data(detail_page)
  interviewee = extract_interviewee(detail_page)
  title = extract_title(detail_page)
  sc_id = extract_soundcloud_id(detail_page)
  text = extract_shownotes_text(detail_page)
  episode_subtitle = extract_subtitle(detail_page)
  episode_number = extract_episode_number(episode_subtitle)
  date = clean_date(episode_subtitle)
  tags = build_tags(title, interviewee)
  options = {
    interviewee: interviewee,
    title: title,
    sc_id: sc_id,
    text: text,
    tags: tags,
    date: date,
    episode_number: episode_number
  }
end
जैसा कि आप ऊपर देख सकते हैं, हम उस detail_page को लेते हैं और उस पर कई निष्कर्षण विधियां लागू करते हैं। हम interviewee, title, sc_id, text, episode_title, और episode_number निकालते हैं। मैंने इन निष्कर्षण जिम्मेदारियों के प्रभारी केंद्रित हेल्पर विधियों का एक गुच्छा रीफैक्टर किया। आइए उन पर एक त्वरित नज़र डालें:
हेल्पर विधियां
निष्कर्षण विधियां
मैंने इन हेल्पर्स को निकाला क्योंकि इसने मुझे समग्र रूप से छोटी विधियां रखने में सक्षम बनाया। उनके व्यवहार को एनकैप्सुलेट करना भी महत्वपूर्ण था। कोड भी बेहतर पढ़ता है। उनमें से अधिकांश detail_page को एक तर्क के रूप में लेते हैं और हमारे Middleman पोस्ट के लिए आवश्यक कुछ विशिष्ट डेटा निकालते हैं।
def extract_interviewee(detail_page)
  interviewee_selector = '.episode_sub_title span'
  detail_page.search(interviewee_selector).text.strip
end
हम एक विशिष्ट सेलेक्टर के लिए पेज खोजते हैं और अनावश्यक व्हाइट स्पेस के बिना टेक्स्ट प्राप्त करते हैं।
def extract_title(detail_page)
  title_selector = ".episode_title"
  detail_page.search(title_selector).text.gsub(/[?#]/, '')
end
हम शीर्षक लेते हैं और ? और # को हटा देते हैं क्योंकि ये हमारे एपिसोड के पोस्ट में फ्रंट मैटर के साथ अच्छी तरह से नहीं चलते हैं। फ्रंट मैटर के बारे में नीचे और अधिक।
def extract_soundcloud_id(detail_page)
  sc = detail_page.iframes_with(href: /soundcloud.com/).to_s
  sc.scan(/\d{3,}/).first
end
यहां हमें अपने होस्टेड ट्रैक के लिए साउंडक्लाउड आईडी निकालने के लिए थोड़ा कठिन काम करना पड़ा। पहले हमें soundcloud.com के href के साथ मैकेनाइज़ आईफ्रेम की आवश्यकता है और इसे स्कैनिंग के लिए एक स्ट्रिंग बनाएं...
"[#<Mechanize::Page::Frame nil \"https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/221003494&auto_play=false&hide_related=false&show_comments=false&show_user=true&show_reposts=false&visual=true\"> ]"
फिर इसके ट्रैक आईडी के अंकों के लिए एक नियमित अभिव्यक्ति से मिलान करें—हमारा soundcloud_id "221003494"।
def extract_shownotes_text(detail_page)
  shownote_selector = "#shownote_container > p"
  detail_page.search(shownote_selector)
end
शो नोट्स निकालना फिर से काफी सीधा है। हमें केवल डिटेल पेज में शो नोट्स के पैराग्राफ देखने की जरूरत है। यहां कोई आश्चर्य नहीं।
def extract_subtitle(detail_page)
  subheader_selector = ".episode_sub_title"
  detail_page.search(subheader_selector).text
end
सबटाइटल के लिए भी यही बात लागू होती है, सिवाय इसके कि यह इससे एपिसोड नंबर को साफ-सुथरे तरीके से निकालने की तैयारी है।
def extract_episode_number(episode_subtitle)
  number = /[#]\d*/.match(episode_subtitle)
  clean_episode_number(number)
end
यहां हमें नियमित अभिव्यक्ति का एक और दौर चाहिए। आइए देखें कि रेगेक्स लागू करने से पहले और बाद में कैसा दिखता है।
episode_subtitle
" João Ferreira | 12 Minutes | Aug 26, 2015 | Episode #139 "
number
"#139"
एक और कदम जब तक हमारे पास एक साफ नंबर नहीं है।
def clean_episode_number(number)
  number.to_s.tr('#', '')
end
हम हैश # के साथ उस नंबर को लेते हैं और इसे हटा देते हैं। वोइला, हमारा पहला एपिसोड नंबर 139 भी निकाला गया है। मैं सुझाव देता हूं कि हम इसे एक साथ लाने से पहले अन्य यूटिलिटी विधियों को भी देखें।
यूटिलिटी विधियां
उस सभी निष्कर्षण व्यवसाय के बाद, हमारे पास कुछ सफाई करने के लिए है। हम पहले से ही मार्कडाउन लिखने के लिए डेटा तैयार करना शुरू कर सकते हैं। उदाहरण के लिए, मुझे एक साफ तारीख प्राप्त करने के लिए episode_subtitle को थोड़ा और काटना होगा और build_tags विधि के साथ tags बनाना होगा।
def clean_date
def clean_date(episode_subtitle)
  string_date = /[^|]*([,])(.....)/.match(episode_subtitle).to_s
  Date.parse(string_date)
end
हम एक और रेगेक्स चलाते हैं जो इस तरह की तारीखों की तलाश करता है: " Aug 26, 2015"। जैसा कि आप देख सकते हैं, यह अभी बहुत उपयोगी नहीं है। string_date से जो हमें सबटाइटल से मिलता है, हमें एक वास्तविक Date ऑब्जेक्ट बनाने की आवश्यकता है। अन्यथा यह Middleman पोस्ट बनाने के लिए बेकार होगा।
string_date
" Aug 26, 2015"
इसलिए हम उस स्ट्रिंग को लेते हैं और Date.parse करते हैं। परिणाम बहुत अधिक आशाजनक दिखता है।
Date
2015-08-26
def build_tags
def build_tags(title, interviewee)
  extracted_tags = strip_pipes(title)
  "#{interviewee}"+ ", #{extracted_tags}"
end
यह title और interviewee को लेता है जिसे हमने extract_data विधि के अंदर बनाया है और सभी पाइप वर्णों और जंक को हटा देता है। हम पाइप वर्णों को कॉमा से, @, ?, #, और & को खाली स्ट्रिंग से बदलते हैं, और अंत में with के लिए संक्षिप्त रूपों का ख्याल रखते हैं।
def strip_pipes
def strip_pipes(text)
  tags = text.tr('|', ',')
  tags = tags.gsub(/[@?#&]/, '')
  tags.gsub(/[w\/]{2}/, 'with')
end
अंत में हम इंटरव्यूई नाम को टैग सूची में भी शामिल करते हैं, और प्रत्येक टैग को कॉमा से अलग करते हैं।
पहले
"Masters @ Work | Subvisual | Deadlines | Design personality | Design problems | Team | Pushing envelopes | Delightful experiences | Perfecting details | Company values"
बाद में
"João Ferreira, Masters Work , Subvisual , Deadlines , Design personality , Design problems , Team , Pushing envelopes , Delightful experiences , Perfecting details , Company values"
इनमें से प्रत्येक टैग उस विषय के लिए पोस्ट के संग्रह का लिंक बन जाएगा। यह सब extract_data विधि के अंदर हुआ। आइए एक और नज़र डालें कि हम कहां हैं:
def extract_data
def extract_data(detail_page)
  interviewee = extract_interviewee(detail_page)
  title = extract_title(detail_page)
  sc_id = extract_soundcloud_id(detail_page)
  text = extract_shownotes_text(detail_page)
  episode_subtitle = extract_subtitle(detail_page)
  episode_number = extract_episode_number(episode_subtitle)
  date = clean_date(episode_subtitle)
  tags = build_tags(title, interviewee)
  options = {
    interviewee: interviewee,
    title: title,
    sc_id: sc_id,
    text: text,
    tags: tags,
    date: date,
    episode_number: episode_number
  }
end
यहां जो कुछ बचा है वह है निकाले गए डेटा के साथ एक विकल्प हैश वापस करना। हम इस हैश को compose_markdown विधि में फीड कर सकते हैं, जो हमारे डेटा को मेरी नई साइट के लिए आवश्यक फ़ाइल के रूप में लिखे जाने के लिए तैयार करता है।
पोस्ट लिखना
def compose_markdown
def compose_markdown(options={})
  <<-HEREDOC
---
title: #{options[:interviewee]}
interviewee: #{options[:interviewee]}
topic_list: #{options[:title]}
tags: #{options[:tags]}
soundcloud_id: #{options[:sc_id]}
date: #{options[:date]}
episode_number: #{options[:episode_number]}
---
#{options[:text]}
HEREDOC
end
मेरे Middleman साइट पर पॉडकास्ट एपिसोड प्रकाशित करने के लिए, मैंने इसके ब्लॉगिंग सिस्टम को पुनर्निर्मित करने का विकल्प चुना। "शुद्ध" ब्लॉग पोस्ट बनाने के बजाय, मैं अपने एपिसोड के लिए शो नोट्स बनाता हूं जो iframes के माध्यम से साउंडक्लाउड होस्टेड एपिसोड प्रदर्शित करते हैं। इंडेक्स साइटों पर, मैं केवल उस iframe प्लस शीर्षक और सामान प्रदर्शित करता हूं।
इसके काम करने के लिए मुझे जिस प्रारूप की आवश्यकता है वह फ्रंट मैटर नामक किसी चीज़ से बना है। यह मूल रूप से मेरी स्टैटिक साइट्स के लिए एक कुंजी/मान स्टोर है। यह मेरी पुरानी Sinatra साइट से मेरी डेटाबेस आवश्यकताओं को प्रतिस्थापित कर रहा है।
इंटरव्यूई नाम, तारीख, साउंडक्लाउड ट्रैक आईडी, एपिसोड नंबर आदि जैसे डेटा हमारे एपिसोड फ़ाइलों के शीर्ष पर तीन डैश (---) के बीच जाता है। नीचे प्रत्येक एपिसोड के लिए कंटेंट आता है—चीजें जैसे प्रश्न, लिंक, प्रायोजक सामान, आदि।
फ्रंट मैटर
---
key: value
key: value
key: value
key: value
---
Episode content goes here.
compose_markdown विधि में, मैं प्रत्येक एपिसोड के लिए उसके फ्रंट मैटर के साथ उस फ़ाइल को लिखने के लिए एक HEREDOC का उपयोग करता हूं जिसे हम लूप करते हैं। विकल्प हैश से जिसे हम इस विधि को फीड करते हैं, हम वह सभी डेटा निकालते हैं जो हमने extract_data हेल्पर विधि में एकत्र किया था।
def compose_markdown
...
<<-HEREDOC
---
title: #{options[:interviewee]}
interviewee: #{options[:interviewee]}
topic_list: #{options[:title]}
tags: #{options[:tags]}
soundcloud_id: #{options[:sc_id]}
date: #{options[:date]}
episode_number: #{options[:episode_number]}
---
#{options[:text]}
HEREDOC
...
यह वहीं एक नए पॉडकास्ट एपिसोड का ब्लूप्रिंट है। यही वह है जिसके लिए हम आए थे। शायद आप इस विशेष सिंटैक्स के बारे में सोच रहे हैं: #{options[:interviewee]}। मैं हमेशा की तरह स्ट्रिंग्स के साथ इंटरपोलेट करता हूं, लेकिन चूंकि मैं पहले से ही एक <<-HEREDOC के अंदर हूं, मैं डबल कोट्स छोड़ सकता हूं।
खुद को उन्मुख करने के लिए, हम अभी भी लूप में हैं, प्रत्येक क्लिक किए गए लिंक के लिए write_page फ़ंक्शन के अंदर एक डिटेल पेज पर जिसमें एक एकल एपिसोड के शो नोट्स हैं। आगे क्या होता है इस ब्लूप्रिंट को फ़ाइल सिस्टम पर लिखने के लिए तैयार करना है। दूसरे शब्दों में, हम एक फ़ाइल नाम और लिखित markdown_text प्रदान करके वास्तविक एपिसोड बनाते हैं।
उस अंतिम चरण के लिए, हमें बस निम्न सामग्री तैयार करने की आवश्यकता है: तारीख, इंटरव्यूई नाम, और एपिसोड नंबर। साथ ही markdown_text जो हमें अभी compose_markdown से मिला है।
def write_page
...
markdown_text = compose_markdown(extracted_data)
date = extracted_data[:date]
interviewee = extracted_data[:interviewee]
episode_number = extracted_data[:episode_number]
file_name = "#{date}-#{dasherize(interviewee)}-#{episode_number}.html.erb.md"
...
फिर हमें केवल file_name और markdown_text लेने और फ़ाइल लिखने की आवश्यकता है।
def write_page
...
File.open(file_name, 'w') { |file| file.write(markdown_text) }
...
आइए इसे भी तोड़ें। प्रत्येक पोस्ट के लिए, मुझे एक विशिष्ट प्रारूप की आवश्यकता है: 2016-10-25-Avdi-Grimm-120 जैसा कुछ। मैं ऐसी फ़ाइलें लिखना चाहता हूं जो तारीख से शुरू हों और इंटरव्यूई नाम और एपिसोड नंबर शामिल करें।
Middleman द्वारा नए पोस्ट के लिए अपेक्षित प्रारूप से मेल खाने के लिए, मुझे इंटरव्यूई नाम लेने और इसे अपने हेल्पर विधि के माध्यम से dasherize करने की आवश्यकता थी, Avdi Grimm से Avdi-Grimm तक। कुछ भी जादुई नहीं, लेकिन देखने लायक:
def dasherize
def dasherize(text)
  text.lstrip.rstrip.tr(' ', '-')
end
यह हमारे द्वारा इंटरव्यूई नाम के लिए स्क्रैप किए गए टेक्स्ट से व्हाइटस्पेस को हटा देता है और Avdi और Grimm के बीच के व्हाइटस्पेस को डैश से बदल देता है। फ़ाइलनाम का बाकी हिस्सा स्ट्रिंग में ही एक साथ जुड़ा हुआ है: "date-interviewee-name-episodenumber"।
def write_page
...
"#{date}-#{dasherize(interviewee)}-#{episode_number}.html.erb.md"
...
चूंकि निकाला गया कंटेंट सीधे एक HTML साइट से आता है, मैं केवल फ़ाइलनाम एक्सटेंशन के रूप में .md या .markdown का उपयोग नहीं कर सकता। मैंने .html.erb.md के साथ जाने का फैसला किया। भविष्य के एपिसोड के लिए जिन्हें मैं स्क्रैपिंग के बिना लिखता हूं, मैं .html.erb भाग को छोड़ सकता हूं और केवल .md की आवश्यकता होगी।
इस चरण के बाद, scrape फ़ंक्शन में लूप समाप्त होता है, और हमारे पास एक एकल एपिसोड होना चाहिए जो इस तरह दिखता है:
2014-12-01-Avdi-Grimm-1.html.erb.md
---
title: Avdi Grimm
interviewee: Avdi Grimm
topic_list: What is Rake | Origins | Jim Weirich | Common use cases | Advantages of Rake
tags: Avdi Grimm, What is Rake , Origins , Jim Weirich , Common use cases , Advantages of Rake
soundcloud_id: 179619755
date: 2014-12-01
episode_number: 1
---
Questions:
- What is Rake?
- What can you tell us about the origins of Rake?
- What can you tell us about Jim Weihrich?
- What are the most common use cases for Rake?
- What are the most notable advantages of Rake?
Links:
In">https://www.youtube.com/watch?v=2ZHJSrF52bc">In memory of the great Jim Weirich
Rake">https://github.com/jimweirich/rake">Rake on GitHub
Jim">https://github.com/jimweirich">Jim Weirich on GitHub
Basic">https://www.youtube.com/watch?v=AFPWDzHWjEY">Basic Rake talk by Jim Weirich
Power">https://www.youtube.com/watch?v=KaEqZtulOus">Power Rake talk by Jim Weirich
Learn">https://devblog.avdi.org/2014/04/30/learn-advanced-rake-in-7-episodes/">Learn advanced Rake in 7 episodes - from Avdi Grimm ( free )
Avdi">https://about.avdi.org/">Avdi Grimm
Avdi Grimm’s screencasts:
Ruby">https://www.rubytapas.com/">Ruby Tapas
Ruby">https://devchat.tv/ruby-rogues/">Ruby Rogues podcast with Avdi Grimm
Great ebook: Rake">https://www.amazon.com/Rake-Management-Essentials-Andrey-Koleshko/dp/1783280778">Rake Task Management Essentials fromhttps://twitter.com/ka8725"> Andrey Koleshko
यह स्क्रैपर अंतिम एपिसोड से शुरू होगा, निश्चित रूप से, और पहले तक लूप करेगा। प्रदर्शन उद्देश्यों के लिए, एपिसोड 01 किसी भी जितना अच्छा है। आप शीर्ष पर हमारे द्वारा निकाले गए डेटा के साथ फ्रंट मैटर देख सकते हैं।
वह सब पहले मेरे Sinatra ऐप के डेटाबेस में बंद था—एपिसोड नंबर, तारीख, इंटरव्यूई नाम, और इसी तरह। अब हमारे पास यह मेरी नई स्टैटिक Middleman साइट का हिस्सा बनने के लिए तैयार है। दो ट्रिपल डैश (---) के नीचे सब कुछ शो नोट्स से टेक्स्ट है: ज्यादातर प्रश्न और लिंक।
अंतिम विचार
और हम हो गए। मेरा नया पॉडकास्ट पहले से ही चालू है और चल रहा है। मुझे वास्तव में खुशी है कि मैंने चीजों को जमीन से ऊपर तक रीडिज़ाइन करने के लिए समय लिया। नए एपिसोड प्रकाशित करना अब बहुत कूलर है। उपयोगकर्ताओं के लिए नई कंटेंट खोजना भी आसान होना चाहिए।
जैसा कि मैंने पहले उल्लेख किया है, यह वह समय है जब आपको कुछ मज़ा लेने के लिए अपने कोड एडिटर में जाना चाहिए। इस कोड को लें और इसके साथ थोड़ा कुश्ती करें। इसे सरल बनाने के तरीके खोजने की कोशिश करें। कोड को रीफैक्टर करने के कुछ अवसर हैं।
कुल मिलाकर, मुझे आशा है कि इस छोटे उदाहरण ने आपको एक अच्छा विचार दिया कि आप अपने नए वेब स्क्रैपिंग कौशल के साथ क्या कर सकते हैं। बेशक आप बहुत अधिक परिष्कृत चुनौतियों को प्राप्त कर सकते हैं—मुझे यकीन है कि इन कौशलों के साथ बहुत सारे छोटे व्यवसाय के अवसर भी बनाए जा सकते हैं।
लेकिन हमेशा की तरह, एक समय में एक कदम उठाएं, और अगर चीजें तुरंत क्लिक न करें तो बहुत निराश न हों। यह न केवल ज्यादातर लोगों के लिए सामान्य है बल्कि अपेक्षित भी है। यह यात्रा का हिस्सा है। हैप्पी स्क्रैपिंग!