पिछले कुछ वर्षों में रूबी जगत में दो जेम्स (gems) वेब स्क्रैपिंग के लिए सबसे लोकप्रिय रहे हैं: Nokogiri और Mechanize। हम प्रत्येक पर एक लेख समर्पित करेंगे और फिर एक व्यावहारिक उदाहरण के साथ उन्हें क्रियान्वित करेंगे।
विषय सूची
- वेब स्क्रैपिंग क्या है?
- अनुमति
- समस्या
- Nokogiri
- निष्कर्षण (Extraction)?
- पृष्ठ (Pages)
- API
- नोड नेविगेशन
वेब स्क्रैपिंग क्या है?
वेब या स्क्रीन स्क्रैपिंग के अलावा और भी फैंसी शब्द हैं। वेब हार्वेस्टिंग और वेब डेटा एक्सट्रैक्शन नाम से ही स्पष्ट है कि क्या हो रहा है। हम वेब पेजों से डेटा के निष्कर्षण को स्वचालित कर सकते हैं—और यह उतना जटिल भी नहीं है।
एक तरह से, ये उपकरण आपको मानव वेब ब्राउज़िंग की नकल और स्वचालन करने की अनुमति देते हैं। आप एक प्रोग्राम लिखते हैं जो केवल उस प्रकार के डेटा को निकालता है जिसमें आपकी रुचि होती है। विशिष्ट डेटा को लक्षित करना CSS सेलेक्टर्स का उपयोग करने जितना ही आसान है।
कुछ साल पहले मैंने एक ऑनलाइन वीडियो कोर्स सब्सक्राइब किया था जिसमें दस लाख छोटे वीडियो थे लेकिन उन्हें बल्क में डाउनलोड करने का कोई विकल्प नहीं था। मुझे हर लिंक पर मैन्युअली जाना पड़ता था और डरावना 'सेव ऐज़' खुद करना पड़ता था। यह एक तरह की मानवीय वेब स्क्रैपिंग थी—कुछ ऐसा जो हम अक्सर तब करते हैं जब हमें उस तरह के सामान को स्वचालित करने का ज्ञान नहीं होता। कोर्स ठीक था, लेकिन उसके बाद मैंने उनकी सेवाओं का उपयोग नहीं किया। यह बहुत थकाऊ था।
आज, मुझे ऐसे दिमाग पिघला देने वाले UX की ज्यादा परवाह नहीं होगी। एक स्क्रैपर जो मेरे लिए डाउनलोड करेगा, उसे बनाने में मुझे बस कुछ मिनट लगेंगे। कोई बड़ी बात नहीं!
शुरू करने से पहले मैं इसे जल्दी से समझा देता हूँ। पूरी प्रक्रिया को कुछ चरणों में समेटा जा सकता है। पहले हम उस वेब पेज को लाते हैं जिसमें वांछित डेटा होता है। फिर हम उस पेज को खोजते हैं और उस जानकारी की पहचान करते हैं जिसे हम निकालना चाहते हैं।
अंतिम चरण है उन टुकड़ों को लक्षित करना, यदि आवश्यक हो तो उन्हें काटना, और यह तय करना कि आप उन्हें कैसे और कहाँ स्टोर करना चाहते हैं। अच्छी तरह से लिखा गया HTML इस प्रक्रिया को आसान और आनंददायक बनाने की कुंजी है। अधिक जटिल निष्कर्षण के लिए, यदि आपको खराब संरचित मार्कअप से निपटना पड़े तो यह पीड़ादायक हो सकता है।
API का क्या?
बहुत अच्छा सवाल। यदि आपके पास API वाली किसी सेवा तक पहुंच है, तो अक्सर अपना स्क्रैपर लिखने की बहुत कम आवश्यकता होती है। यह दृष्टिकोण ज्यादातर उन वेबसाइटों के लिए है जो वह सुविधा प्रदान नहीं करतीं। API के बिना, वेबसाइटों से सूचना के निष्कर्षण को स्वचालित करने का यह अक्सर एकमात्र तरीका होता है।
आप पूछ सकते हैं, यह स्क्रैपिंग चीज वास्तव में कैसे काम करती है? गहरे अंत में जाए बिना, संक्षिप्त उत्तर है: ट्री डेटा संरचनाओं को पार करके (traversing tree data structures)। Nokogiri आपके द्वारा दिए गए दस्तावेजों से ये डेटा संरचनाएं बनाता है और आपको निष्कर्षण के लिए रुचि के टुकड़ों को लक्षित करने देता है। उदाहरण के लिए, CSS ट्री ट्रैवर्सल के लिए लिखी गई एक भाषा है, ट्री डेटा संरचनाओं को खोजने के लिए, और हम इसका उपयोग डेटा निष्कर्षण के लिए कर सकते हैं।
वहां कई दृष्टिकोण और समाधान हैं जिनसे खेला जा सकता है। रूबीजगत में दो जेम्स वर्षों से सुर्खियों में रहे हैं। कई लोग अभी भी HTML स्क्रैपिंग जरूरतों के लिए Nokogiri और Mechanize पर भरोसा करते हैं। दोनों का परीक्षण किया गया है और उन्होंने खुद को उपयोग में आसान होने के साथ-साथ अत्यधिक सक्षम साबित किया है। हम दोनों को देखेंगे। लेकिन उससे पहले, मैं उस समस्या को संबोधित करने के लिए एक पल लेना चाहूंगा जिसे हम इस लघु परिचयात्मक श्रृंखला के अंत में हल करने जा रहे हैं।
अनुमति
स्क्रैपिंग शुरू करने से पहले, सुनिश्चित करें कि जिन साइटों से आप डेटा निकालने का प्रयास कर रहे हैं, उनकी अनुमति आपके पास है। यदि साइट में API या RSS फीड है, उदाहरण के लिए, यह न केवल वांछित सामग्री प्राप्त करने का आसान तरीका हो सकता है, बल्कि यह पसंद का कानूनी विकल्प भी हो सकता है।
हर कोई इसकी सराहना नहीं करेगा यदि आप उनकी साइटों पर बड़े पैमाने पर स्क्रैपिंग करते हैं—समझदारी से। उस विशेष साइट के बारे में खुद को शिक्षित करें जिसमें आप रुचि रखते हैं, और अनजाने में मुसीबत में न पड़ें। संभावना कम है कि आप गंभीर नुकसान पहुंचाएंगे, लेकिन अनजाने में जोखिम उठाना सही रास्ता नहीं है।
समस्या
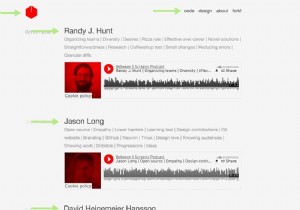
मुझे एक नया पॉडकास्ट बनाने की आवश्यकता थी। डिज़ाइन वैसा नहीं था जैसा मैं चाहता था, और मुझे नई पोस्ट प्रकाशित करने का तरीका पसंद नहीं था। लानत है WYSIWYGs! थोड़ा संदर्भ। लगभग दो साल पहले, मैंने अपने पॉडकास्ट का पहला संस्करण बनाया था। विचार था Sinatra के साथ खेलना और कुछ सुपर लाइटवेट बनाना। मैं कुछ अप्रत्याशित मुद्दों में भाग गया क्योंकि मैंने बहुत कुछ दर्जी बनाया था।
Rails से आते हुए, यह निश्चित रूप से एक शैक्षिक यात्रा थी जिसकी मैं सराहना करता हूँ, लेकिन मैंने जल्दी ही पछताया कि मैंने एक स्टैटिक साइट का उपयोग नहीं किया जिसे मैं GitHub के माध्यम से GitHub पेजों के जरिए डिप्लॉय कर सकता था। नए एपिसोड को डिप्लॉय करना और उन्हें बनाए रखना उस सरलता की कमी थी जिसकी मुझे तलाश थी। थोड़ी देर के लिए, मैंने तय किया कि मेरे पास तलने के लिए बड़ी मछलियाँ थीं और नई पॉडकास्ट सामग्री बनाने पर ध्यान केंद्रित किया।
इस गर्मी में मैं गंभीर हुआ और GitHub पेजों के माध्यम से होस्ट की गई एक Middleman साइट पर काम करना शुरू किया। शो के दूसरे सीज़न के लिए, मैं कुछ नया चाहता था। एक नया, सरल डिज़ाइन, नए एपिसोड प्रकाशित करने के लिए मार्कडाउन, और Heroku के साथ कोई मुक्केबाज़ी नहीं—स्वर्ग! बात यह थी कि मेरे पास 139 एपिसोड पड़े थे जिन्हें Middleman के साथ काम करने के लिए पहले आयात और परिवर्तित करने की आवश्यकता थी।
पोस्ट के लिए, Middleman .markdown फाइलों का उपयोग करता है जिनमें तथाकथित फ्रंटमैटर होता है डेटा के लिए—जो मूल रूप से मेरे डेटाबेस को बदल देता है। 139 एपिसोड के लिए इस ट्रांसफर को हाथ से करना कोई विकल्प नहीं है। यही वह जगह है जहां गणना काम आती है। मुझे अपने पुराने वेबसाइट के HTML को पार्स करने, प्रासंगिक सामग्री को स्क्रैप करने, और उसे ब्लॉग पोस्ट में स्थानांतरित करने का एक तरीका निकालने की आवश्यकता थी जिनका उपयोग मैं Middleman पर नए पॉडकास्ट एपिसोड प्रकाशित करने के लिए करता हूँ।
इसलिए, अगले तीन लेखों में, मैं आपको उन उपकरणों से परिचित कराऊंगा जिनका उपयोग रूबीजगत में ऐसे कार्यों के लिए आमतौर पर किया जाता है। अंत में, हम अपने समाधान पर जाएंगे ताकि आपको कुछ व्यावहारिक भी दिखा सकें।
Nokogiri
भले ही आप Ruby/Rails में पूरी तरह से नए हों, संभावना बहुत अच्छी है कि आपने पहले से ही इस छोटे जेम के बारे में सुना हो। नाम अक्सर गिराया जाता है और आसानी से याद रहता है। मुझे यकीन नहीं है कि कितने लोग जानते हैं कि nokogiri जापानी में "आरा" (saw) के लिए है।
यह एक उपयुक्त नाम है एक बार जब आप समझ जाते हैं कि उपकरण क्या करता है। इस जेम के निर्माता प्यारे टेंडरलव, आरोन पैटरसन हैं। Nokogiri XML और HTML दस्तावेजों को एक डेटा संरचना में परिवर्तित करता है—सटीक होने के लिए एक ट्री डेटा संरचना। उपकरण तेज़ है और एक अच्छा इंटरफेस भी प्रदान करता है। कुल मिलाकर, यह एक बहुत शक्तिशाली लाइब्रेरी है जो आपकी कई HTML स्क्रैपिंग जरूरतों का ख्याल रखती है।
आप Nokogiri का उपयोग न केवल HTML पार्स करने के लिए कर सकते हैं; XML भी उचित खेल है। यह आपको आपके द्वारा लोड किए गए दस्तावेजों को पार करने के लिए XML पथ भाषा और CSS दोनों इंटरफेस के विकल्प देता है। XML पथ भाषा, या संक्षेप में XPath, एक क्वेरी भाषा है।
यह हमें XML दस्तावेजों से नोड्स का चयन करने की अनुमति देता है। CSS सेलेक्टर्स शुरुआती लोगों के लिए अधिक परिचित होने की संभावना है। जैसे आप स्टाइल लिखते हैं, CSS सेलेक्टर्स पेज के उन विशिष्ट वर्गों को लक्षित करना शानदार रूप से आसान बनाते हैं जो निष्कर्षण के लिए रुचि के हैं। आपको बस Nokogiri को यह बताने की आवश्यकता है कि जब आप किसी विशेष गंतव्य को लक्षित करते हैं तो आप क्या चाहते हैं।
पृष्ठ (Pages)
हमें हमेशा उस वास्तविक पेज को लाने के साथ शुरू करने की आवश्यकता होती है जिसमें हम रुचि रखते हैं। हम निर्दिष्ट करते हैं कि हम किस प्रकार का Nokogiri दस्तावेज़ पार्स करना चाहते हैं—उदाहरण के लिए XML या HTML:
Nokogiri::XML Nokogiri::HTML
some_scraper.rb
require "nokogiri"
require "open-uri"
page = Nokogiri::XML(File.open("some.xml"))
page = Nokogiri::HTML(File.open("some.html"))
Nokogiri::XML और Nokogiri::HTML IO ऑब्जेक्ट्स या स्ट्रिंग ऑब्जेक्ट्स ले सकते हैं। ऊपर जो होता है वह सीधा है। यह open-uri का उपयोग करके निर्दिष्ट पेज को खोलता और लाता है और फिर इसकी संरचना, इसके XML या HTML को एक नए Nokogiri दस्तावेज़ में लोड करता है। XML कुछ ऐसा नहीं है जिसे शुरुआती लोगों को अक्सर निपटना पड़ता है।
इसलिए, मैं सुझाव दूंगा कि हम अभी HTML पार्सिंग पर ध्यान केंद्रित करें। open-uri क्यों? रूबी स्टैंडर्ड लाइब्रेरी का यह मॉड्यूल हमें बिना किसी झंझट के साइट को हथियाने देता है। क्योंकि IO ऑब्जेक्ट्स उचित खेल हैं, हम open-uri का आसानी से उपयोग कर सकते हैं।
API
आइए इसे एक मिनी उदाहरण के साथ अभ्यास में लाते हैं:
at_css
some_podcast_scraper.rb
require 'nokogiri'
require "open-uri"
url = 'https://betweenscreens.fm/'
page = Nokogiri::HTML(open(url))
header = page.at_css("h2.post-title")
title = header.text
puts "This is the raw header of the latest episode: #{header}"
puts "This is the title of the latest episode: #{title}"
यहां हमने वे सभी चरण किए हैं जो आमतौर पर वेब स्क्रैपिंग में शामिल होते हैं—बस सूक्ष्म स्तर पर। हम तय करते हैं कि हमें किस URL की आवश्यकता है और किस साइट को लाने की आवश्यकता है, और हम उन्हें एक नए Nokogiri दस्तावेज़ में लोड करते हैं। फिर हम उस पेज को खोलते हैं और एक विशिष्ट खंड को लक्षित करते हैं।
यहां मैं केवल नवीनतम एपिसोड का शीर्षक जानना चाहता था। at_css मेथड और h2.post-title के लिए एक CSS सेलेक्टर का उपयोग करना निष्कर्षण बिंदु को लक्षित करने के लिए मुझे आवश्यक था। इस मेथड के साथ हम केवल उस एकल तत्व को स्क्रैप करेंगे, हालांकि। यह हमें पूरा सेलेक्टर देता है—जो ज्यादातर समय ठीक वही नहीं है जो हमें चाहिए। इसलिए हम text मेथड के माध्यम से इस नोड के केवल आंतरिक टेक्स्ट भाग को निकालते हैं। तुलना के लिए, आप नीचे हेडर और टेक्स्ट दोनों के आउटपुट की जांच कर सकते हैं।
आउटपुट
This is the raw title of the latest episode: <h2 class="post-title"><a href="episodes/142/">David Heinemeier Hansson</a></h2>
This is the title of the latest episode: David Heinemeier Hansson
हालांकि इस उदाहरण के बहुत सीमित अनुप्रयोग हैं, इसमें वे सभी सामग्रियां, वे सभी चरण हैं जिन्हें आपको समझने की आवश्यकता है। मुझे लगता है कि यह कितना सरल है, यह अच्छा है। क्योंकि यह इस उदाहरण से स्पष्ट नहीं हो सकता है, मैं यह इंगित करना चाहूंगा कि यह उपकरण कितना शक्तिशाली हो सकता है। आइए देखें कि हम Nokogiri स्क्रिप्ट के साथ और क्या कर सकते हैं।
ध्यान दें!
यदि आप एक शुरुआती हैं और निश्चित नहीं हैं कि इसके लिए आवश्यक HTML को कैसे लक्षित किया जाए, तो मैं अनुशंसा करता हूं कि आप ऑनलाइन खोजें कि अपने ब्राउज़र में वेबसाइटों की सामग्री का निरीक्षण कैसे करें। मूल रूप से, सभी प्रमुख ब्राउज़र इन दिनों इस प्रक्रिया को वास्तव में आसान बनाते हैं।
Chrome पर आपको बस वेबसाइट पर एक तत्व पर राइट-क्लिक करना होगा और इंस्पेक्ट विकल्प चुनना होगा। यह आपके ब्राउज़र के नीचे एक छोटी विंडो खोलेगा जो आपको साइट के DOM का एक्स-रे जैसा कुछ दिखाता है। इसके कई और विकल्प हैं, और मैं Google पर कुछ समय बिताकर खुद को शिक्षित करने की सलाह दूंगा। यह समय बुद्धिमानी से व्यतीत होगा!
css
css मेथड हमें न केवल पसंद का एकल तत्व देगा बल्कि पेज पर कोई भी तत्व जो खोज मानदंड से मेल खाता है। बहुत साफ और सीधा!
some_scraper.rb
require 'nokogiri'
require "open-uri"
url = 'https://betweenscreens.fm/'
page = Nokogiri::HTML(open(url))
headers = page.css("h2.post-title")
headers.each do |header|
  puts "This is the raw title of the latest episode: #{header}"
end
headers.each do |header|
  puts "This is the title of the latest episode: #{header.text}"
end
आउटपुट
This is the raw title of the latest episode: <h2 class="post-title"><a href="episodes/142/">David Heinemeier Hansson</a></h2>
This is the raw title of the latest episode: <h2 class="post-title"><a href="episodes/141/">Zach Holman</a></h2>
This is the raw title of the latest episode: <h2 class="post-title"><a href="episodes/140/">Joel Glovier</a></h2>
This is the raw title of the latest episode: <h2 class="post-title"><a href="episodes/139/">João Ferreira</a></h2>
This is the raw title of the latest episode: <h2 class="post-title"><a href="episodes/138/">Corwin Harrell</a></h2>
This is the raw title of the latest episode: <h2 class="post-title"><a href="episodes/137/">Roberto Machado</a></h2>
This is the raw title of the latest episode: <h2 class="post-title"><a href="episodes/136/">James Edward Gray II</a></h2>
This is the title of the latest episode: David Heinemeier Hansson
This is the title of the latest episode: Zach Holman
This is the title of the latest episode: Joel Glovier
This is the title of the latest episode: João Ferreira
This is the title of the latest episode: Corwin Harrell
This is the title of the latest episode: Roberto Machado
This is the title of the latest episode: James Edward Gray II
इस उदाहरण में एकमात्र छोटा अंतर यह है कि मैं पहले कच्चे हेडर्स पर पुनरावृति करता हूँ। मैंने text मेथड के साथ इसका आंतरिक टेक्स्ट भी निकाला। Nokogiri स्वचालित रूप से पेज के अंत में रुक जाता है और स्वचालित रूप से कहीं भी पेजिनेशन का पालन करने का प्रयास नहीं करता।
मान लीजिए हम थोड़ी और जानकारी चाहते हैं, जैसे प्रत्येक एपिसोड के लिए तारीख और उपशीर्षक। हम बस ऊपर दिए गए उदाहरण पर विस्तार कर सकते हैं। वैसे भी इस कदम को चरण दर च उठाना एक अच्छा विचार है। एक छोटा सा टुकड़ा काम करवाएं और रास्ते में अधिक जटिलता जोड़ें।
some_scraper.rb
require 'nokogiri'
require "open-uri"
url = 'https://betweenscreens.fm/'
page = Nokogiri::HTML(open(url))
articles = page.css("article.index-article")
articles.each do |article|
  header = article.at_css("h2.post-title")
  date = article.at_css(".post-date")
  subtitle = article.at_css(".topic-list")
  puts "This is the raw header: #{header}"
  puts "This is the raw date: #{date}"
  puts "This is the raw subtitle: #{subtitle}\n\n"
  puts "This is the text header: #{header.text}"
  puts "This is the text date: #{date.text}"
  puts "This is the text subtitle: #{subtitle.text}\n\n"
end
आउटपुट
This is the raw header: <h2 class="post-title"><a href="episodes/142/">David Heinemeier Hansson</a></h2>
This is the raw date: <span class="post-date">Oct 18 | 2016</span>
This is the raw subtitle: <h3 class="topic-list">Rails community | Tone | Technical disagreements | Community policing | Ungratefulness | No assholes allowed | Basecamp | Open source persona | Aspirations | Guarding motivations | Dealing with audiences | Pressure | Honesty | Diverse opinions | Small talk</h3>
This is the text header: David Heinemeier Hansson
This is the text date: Oct 18 | 2016
This is the text subtitle: Rails community | Tone | Technical disagreements | Community policing | Ungratefulness | No assholes allowed | Basecamp | Open source persona | Aspirations | Guarding motivations | Dealing with audiences | Pressure | Honesty | Diverse opinions | Small talk
This is the raw header: <h2 class="post-title"><a href="episodes/141/">Zach Holman</a></h2>
This is the raw date: <span class="post-date">Oct 12 | 2016</span>
This is the raw subtitle: <h3 class="topic-list">Getting Fired | Taboo | Transparency | Different Perspectives | Timing | Growth Stages | Employment & Dating | Managers | At-will Employment | Tech Industry | Europe | Low hanging Fruits | Performance Improvement Plans | Meeting Goals | Surprise Firings | Firing Fast | Mistakes | Company Culture | Communication</h3>
This is the text header: Zach Holman
This is the text date: Oct 12 | 2016
This is the text subtitle: Getting Fired | Taboo | Transparency | Different Perspectives | Timing | Growth Stages | Employment & Dating | Managers | At-will Employment | Tech Industry | Europe | Low hanging Fruits | Performance Improvement Plans | Meeting Goals | Surprise Firings | Firing Fast | Mistakes | Company Culture | Communication
This is the raw header: <h2 class="post-title"><a href="episodes/140/">Joel Glovier</a></h2>
This is the raw date: <span class="post-date">Oct 10 | 2016</span>
This is the raw subtitle: <h3 class="topic-list">Digital Product Design | Product Design @ GitHub | Loving Design | Order & Chaos | Drawing | Web Design | HospitalRun | Diversity | Startup Culture | Improving Lives | CURE International | Ember | Offline First | Hospital Information System | Designers & Open Source</h3>
This is the text header: Joel Glovier
This is the text date: Oct 10 | 2016
This is the text subtitle: Digital Product Design | Product Design @ GitHub | Loving Design | Order & Chaos | Drawing | Web Design | HospitalRun | Diversity | Startup Culture | Improving Lives | CURE International | Ember | Offline First | Hospital Information System | Designers & Open Source
This is the raw header: <h2 class="post-title"><a href="episodes/139/">João Ferreira</a></h2>
This is the raw date: <span class="post-date">Aug 26 | 2015</span>
This is the raw subtitle: <h3 class="topic-list">Masters @ Work | Subvisual | Deadlines | Design personality | Design problems | Team | Pushing envelopes | Delightful experiences | Perfecting details | Company values</h3>
This is the text header: João Ferreira
This is the text date: Aug 26 | 2015
This is the text subtitle: Masters @ Work | Subvisual | Deadlines | Design personality | Design problems | Team | Pushing envelopes | Delightful experiences | Perfecting details | Company values
This is the raw header: <h2 class="post-title"><a href="episodes/138/">Corwin Harrell</a></h2>
This is the raw date: <span class="post-date">Aug 06 | 2015</span>
This is the raw subtitle: <h3 class="topic-list">Q&A | 01 | University | Graphic design | Design setup | Sublime | Atom | thoughtbot | Working location | Collaboration & pairing | Vim advocates | Daily routine | Standups | Clients | Coffee walks | Investment Fridays |</h3>
This is the text header: Corwin Harrell
This is the text date: Aug 06 | 2015
This is the text subtitle: Q&A | 01 | University | Graphic design | Design setup | Sublime | Atom | thoughtbot | Working location | Collaboration & pairing | Vim advocates | Daily routine | Standups | Clients | Coffee walks | Investment Fridays |
This is the raw header: <h2 class="post-title"><a href="episodes/137/">Roberto Machado</a></h2>
This is the raw date: <span class="post-date">Aug 03 | 2015</span>
This is the raw subtitle: <h3 class="topic-list">CEO @ Subvisual | RubyConf Portugal | Creators School | Consultancy | Company role models | Group Buddies | Portuguese startup | Rebranding | Technologies used | JS frameworks | TDD & BDD | Startup mistakes | Culture of learning | Young entrepreneurs</h3>
This is the text header: Roberto Machado
This is the text date: Aug 03 | 2015
This is the text subtitle: CEO @ Subvisual | RubyConf Portugal | Creators School | Consultancy | Company role models | Group Buddies | Portuguese startup | Rebranding | Technologies used | JS frameworks | TDD & BDD | Startup mistakes | Culture of learning | Young entrepreneurs
This is the raw header: <h2 class="post-title"><a href="episodes/136/">James Edward Gray II</a></h2>
This is the raw date: <span class="post-date">Jul 30 | 2015</span>
This is the raw subtitle: <h3 class="topic-list">Screencasting | Less Code | Reading code | Getting unstuck | Rails’s codebase | CodeNewbie | Small examples | Future plans | PeepCode | Frequency & pricing</h3>
This is the text header: James Edward Gray II
This is the text date: Jul 30 | 2015
This is the text subtitle: Screencasting | Less Code | Reading code | Getting unstuck | Rails’s codebase | CodeNewbie | Small examples | Future plans | PeepCode | Frequency & pricing
इस बिंदु पर, हमारे पास पहले से ही खेलने के लिए कुछ डेटा है। हम इसे किसी भी तरह से संरचित या काट-छाँट सकते हैं। उपरोक्त केवल यह दिखाना चाहिए कि हमारे पास पठनीय तरीके से क्या है। बेशक हम text मेथड के साथ नियमित अभिव्यक्तियों का उपयोग करके इनमें से प्रत्येक में गहराई से जा सकते हैं।
हम वास्तविक पॉडकास्ट समस्या को हल करने के लिए जब पहुंचेंगे तो इसे बहुत अधिक विस्तार से देखेंगे। यह regexp पर एक क्लास नहीं होगी, लेकिन आप इसे और अधिक क्रिया में देखेंगे—लेकिन चिंता न करें, इतना नहीं कि आपका दिमाग खून बहाने लगे।
एट्रिब्यूट्स (Attributes)
इस स्तर पर जो काम आ सकता है वह है व्यक्तिगत एपिसोड के लिए href निकालना। यह इससे सरल नहीं हो सकता।
some_scraper.rb
require 'nokogiri'
require "open-uri"
url = 'https://betweenscreens.fm/'
page = Nokogiri::HTML(open(url))
articles = page.css("article.index-article")
articles.each do |article|
  header = article.at_css("h2.post-title")
  date = article.at_css(".post-date")
  subtitle = article.at_css(".topic-list")
  link = article.at_css("h2.post-title a")
  podcast_url = "https://betweenscreens.fm/"
  puts "This is the raw header: #{header}"
  puts "This is the raw date: #{date}"
  puts "This is the raw subtitle: #{subtitle}"
  puts "This is the raw link: #{link}\n\n"
  puts "This is the text header: #{header.text}"
  puts "This is the text date: #{date.text}"
  puts "This is the text subtitle: #{subtitle.text}"
  puts "This is the raw link: #{podcast_url}#{link[:href]}\n\n"
end
यहां ध्यान देने योग्य सबसे महत्वपूर्ण बिट्स हैं [:href] और podcast_url। यदि आप [:] टैग करते हैं तो आप केवल लक्षित सेलेक्टर से एक एट्रिब्यूट निकाल सकते हैं। मैंने थोड़ा और अमूर्त किया, लेकिन आप नीचे अधिक स्पष्ट रूप से देख सकते हैं कि यह कैसे काम करता है।
...
href = article.at_css("h2.post-title a")[:href]
...
एक पूर्ण और उपयोगी URL प्राप्त करने के लिए, मैंने रूट डोमेन को एक वेरिएबल में सहेजा और प्रत्येक एपिसोड के लिए पूर्ण URL का निर्माण किया।
...
podcast_url = "https://betweenscreens.fm/"
puts "This is the raw link: #{podcast_url}#{link[:href]}\n\n"
...
आइए आउटपुट पर एक त्वरित नज़र डालते हैं:
आउटपुट
This is the raw header: <h2 class="post-title"><a href="episodes/143/">Jason Long</a></h2>
This is the raw date: <span class="post-date">Oct 25 | 2016</span>
This is the raw subtitle: <h3 class="topic-list">Open source | Empathy | Lower barriers | Learning tool | Design contributions | Git website | Branding | GitHub | Neovim | Tmux | Design love | Knowing audiences | Showing work | Dribbble | Progressions | Ideas</h3>
This is the raw link: <a href="episodes/143/">Jason Long</a>
This is the text header: Jason Long
This is the text date: Oct 25 | 2016
This is the text subtitle: Open source | Empathy | Lower barriers | Learning tool | Design contributions | Git website | Branding | GitHub | Neovim | Tmux | Design love | Knowing audiences | Showing work | Dribbble | Progressions | Ideas
This is the href: https://betweenscreens.fm/episodes/143/
This is the raw header: <h2 class="post-title"><a href="episodes/142/">David Heinemeier Hansson</a></h2>
This is the raw date: <span class="post-date">Oct 18 | 2016</span>
This is the raw subtitle: <h3 class="topic-list">Rails community | Tone | Technical disagreements | Community policing | Ungratefulness | No assholes allowed | Basecamp | Open source persona | Aspirations | Guarding motivations | Dealing with audiences | Pressure | Honesty | Diverse opinions | Small talk</h3>
This is the raw link: <a href="episodes/142/">David Heinemeier Hansson</a>
This is the text header: David Heinemeier Hansson
This is the text date: Oct 18 | 2016
This is the text subtitle: Rails community | Tone | Technical disagreements | Community policing | Ungratefulness | No assholes allowed | Basecamp | Open source persona | Aspirations | Guarding motivations | Dealing with audiences | Pressure | Honesty | Diverse opinions | Small talk
This is the href: https://betweenscreens.fm/episodes/142/
This is the raw header: <h2 class="post-title"><a href="episodes/141/">Zach Holman</a></h2>
This is the raw date: <span class="post-date">Oct 12 | 2016</span>
This is the raw subtitle: <h3 class="topic-list">Getting Fired | Taboo | Transparency | Different Perspectives | Timing | Growth Stages | Employment & Dating | Managers | At-will Employment | Tech Industry | Europe | Low hanging Fruits | Performance Improvement Plans | Meeting Goals | Surprise Firings | Firing Fast | Mistakes | Company Culture | Communication</h3>
This is the raw link: <a href="episodes/141/">Zach Holman</a>
This is the text header: Zach Holman
This is the text date: Oct 12 | 2016
This is the text subtitle: Getting Fired | Taboo | Transparency | Different Perspectives | Timing | Growth Stages | Employment & Dating | Managers | At-will Employment | Tech Industry | Europe | Low hanging Fruits | Performance Improvement Plans | Meeting Goals | Surprise Firings | Firing Fast | Mistakes | Company Culture | Communication
This is the href: https://betweenscreens.fm/episodes/141/
This is the raw header: <h2 class="post-title"><a href="episodes/140/">Joel Glovier</a></h2>
This is the raw date: <span class="post-date">Oct 10 | 2016</span>
This is the raw subtitle: <h3 class="topic-list">Digital Product Design | Product Design @ GitHub | Loving Design | Order & Chaos | Drawing | Web Design | HospitalRun | Diversity | Startup Culture | Improving Lives | CURE International | Ember | Offline First | Hospital Information System | Designers & Open Source</h3>
This is the raw link: <a href="episodes/140/">Joel Glovier</a>
This is the text header: Joel Glovier
This is the text date: Oct 10 | 2016
This is the text subtitle: Digital Product Design | Product Design @ GitHub | Loving Design | Order & Chaos | Drawing | Web Design | HospitalRun | Diversity | Startup Culture | Improving Lives | CURE International | Ember | Offline First | Hospital Information System | Designers & Open Source
This is the href: https://betweenscreens.fm/episodes/140/
This is the raw header: <h2 class="post-title"><a href="episodes/139/">João Ferreira</a></h2>
This is the raw date: <span class="post-date">Aug 26 | 2015</span>
This is the raw subtitle: <h3 class="topic-list">Masters @ Work | Subvisual | Deadlines | Design personality | Design problems | Team | Pushing envelopes | Delightful experiences | Perfecting details | Company values</h3>
This is the raw link: <a href="episodes/139/">João Ferreira</a>
This is the text header: João Ferreira
This is the text date: Aug 26 | 2015
This is the text subtitle: Masters @ Work | Subvisual | Deadlines | Design personality | Design problems | Team | Pushing envelopes | Delightful experiences | Perfecting details | Company values
This is the href: https://betweenscreens.fm/episodes/139/
This is the raw header: <h2 class="post-title"><a href="episodes/138/">Corwin Harrell</a></h2>
This is the raw date: <span class="post-date">Aug 06 | 2015</span>
This is the raw subtitle: <h3 class="topic-list">Q&A | 01 | University | Graphic design | Design setup | Sublime | Atom | thoughtbot | Working location | Collaboration & pairing | Vim advocates | Daily routine | Standups | Clients | Coffee walks | Investment Fridays |</h3>
This is the raw link: <a href="episodes/138/">Corwin Harrell</a>
This is the text header: Corwin Harrell
This is the text date: Aug 06 | 2015
This is the text subtitle: Q&A | 01 | University | Graphic design | Design setup | Sublime | Atom | thoughtbot | Working location | Collaboration & pairing | Vim advocates | Daily routine | Standups | Clients | Coffee walks | Investment Fridays |
This is the href: https://betweenscreens.fm/episodes/138/
This is the raw header: <h2 class="post-title"><a href="episodes/137/">Roberto Machado</a></h2>
This is the raw date: <span class="post-date">Aug 03 | 2015</span>
This is the raw subtitle: <h3 class="topic-list">CEO @ Subvisual | RubyConf Portugal | Creators School | Consultancy | Company role models | Group Buddies | Portuguese startup | Rebranding | Technologies used | JS frameworks | TDD & BDD | Startup mistakes | Culture of learning | Young entrepreneurs</h3>
This is the raw link: <a href="episodes/137/">Roberto Machado</a>
This is the text header: Roberto Machado
This is the text date: Aug 03 | 2015
This is the text subtitle: CEO @ Subvisual | RubyConf Portugal | Creators School | Consultancy | Company role models | Group Buddies | Portuguese startup | Rebranding | Technologies used | JS frameworks | TDD & BDD | Startup mistakes | Culture of learning | Young entrepreneurs
This is the href: https://betweenscreens.fm/episodes/137/
साफ है, है ना? आप सेलेक्टर के [:class] को निकालने के लिए भी ऐसा ही कर सकते हैं।
require 'nokogiri'
require "open-uri"
url = 'https://betweenscreens.fm/'
page = Nokogiri::HTML(open(url))
body_classes = page.at_css("body")[:class]
यदि उस नोड में एक से अधिक क्लास हैं, तो आपको उन सभी की सूची मिल जाएगी।
नोड नेविगेशन (Node Navigation)
- parent
- children
- previous_sibling
- next_sibling
हम CSS या यहां तक कि jQuery में ट्री संरचनाओं से निपटने के आदी हैं। अगर Nokogiri ऐसे ट्री में घूमने के लिए एक आसान API प्रदान नहीं करता तो यह दर्दनाक होता।
some_scraper.rb
require 'nokogiri'
require "open-uri"
url = 'https://betweenscreens.fm/'
page = Nokogiri::HTML(open(url))
header = page.at_css("h2.post-title")
header_children = page.at_css("h2.post-title").children
header_parent = page.at_css("h2.post-title").parent
header_prev_sibling = page.at_css("h2.post-title").previous_sibling
puts "#{header}\n\n"
puts "#{header_children}\n\n"
puts "#{header_parent}\n\n"
puts "#{header_prev_sibling}\n\n"
आउटपुट
#header <h2 class="post-title"><a href="episodes/143/">Jason Long</a></h2>
#header_children <a href="episodes/143/">Jason Long</a>
#header_parent <article class="index-article">
  <span class="post-date">Oct 25 | 2016</span><h2 class="post-title"><a href="episodes/143/">Jason Long</a></h2>
  <h3 class="topic-list">Open source | Empathy | Lower barriers | Learning tool | Design contributions | Git website | Branding | GitHub | Neovim | Tmux | Design love | Knowing audiences | Showing work | Dribbble | Progressions | Ideas</h3>
  <div class="soundcloud-player-small">
  </div>
</article>
#header_previous_sibling <span class="post-date">Oct 25 | 2016</span>
जैसा कि आप स्वयं देख सकते हैं, यह कुछ बहुत शक्तिशाली सामान है—खासकर जब आप देखते हैं कि .parent एक ही बार में क्या इकट्ठा करने में सक्षम था। हाथ से कई नोड्स को परिभाषित करने के बजाय, आप उन्हें थोक में एकत्र कर सकते हैं।
आप अधिक जटिल ट्रैवर्सल के लिए उन्हें चेन भी कर सकते हैं। आप इसे जितना चाहें उतना जटिल ले सकते हैं, लेकिन मैं आपको चीजों को सरल रखने की चेतावनी दूंगा। यह जल्दी से थोड़ा अनाड़ी और समझने में कठिन हो सकता है। याद रखें, "Keep it simple, stupid!"
...
header_parent_parent = page.at_css("h2.post-title").parent.parent
header_prev_sibling_parent_children = page.at_css("h2.post-title").previous_sibling.parent.children
...
some_scraper.rb
require 'nokogiri'
require "open-uri"
url = 'https://betweenscreens.fm/'
page = Nokogiri::HTML(open(url))
header = page.at_css("h2.post-title")
header_prev_sibling_children = page.at_css("h2.post-title").previous_sibling.children
header_parent_parent = page.at_css("h2.post-title").parent.parent
header_prev_sibling_parent = page.at_css("h2.post-title").previous_sibling.parent
header_prev_sibling_parent_children = page.at_css("h2.post-title").previous_sibling.parent.children
puts "#{header}\n\n"
puts "#{header_prev_sibling_children}\n\n"
puts "#{header_parent_parent}\n\n"
puts "#{header_prev_sibling_parent}\n\n"
puts "#{header_prev_sibling_parent_children}\n\n"
आउटपुट
#header <h2 class="post-title"><a href="episodes/143/">Jason Long</a></h2>
#header_previous_sibling_children Oct 25 | 2016
#header_parent_parent <li>
  <article class="index-article">
  <span class="post-date">Oct 25 | 2016</span><h2 class="post-title"><a href="episodes/143/">Jason Long</a></h2>
  <h3 class="topic-list">Open source | Empathy | Lower barriers | Learning tool | Design contributions | Git website | Branding | GitHub | Neovim | Tmux | Design love | Knowing audiences | Showing work | Dribbble | Progressions | Ideas</h3>
  <div class="soundcloud-player-small">
  </div>
  </article>
</li>
#header_previous_sibling_parent <article class="index-article">
  <span class="post-date">Oct 25 | 2016</span><h2 class="post-title"><a href="episodes/143/">Jason Long</a></h2>
  <h3 class="topic-list">Open source | Empathy | Lower barriers | Learning tool | Design contributions | Git website | Branding | GitHub | Neovim | Tmux | Design love | Knowing audiences | Showing work | Dribbble | Progressions | Ideas</h3>
  <div class="soundcloud-player-small">
  </div>
</article>
#header_previous_sibling_parent_children <span class="post-date">Oct 25 | 2016</span><h2 class="post-title"><a href="episodes/143/">Jason Long</a></h2>
<h3 class="topic-list">Open source | Empathy | Lower barriers | Learning tool | Design contributions | Git website | Branding | GitHub | Neovim | Tmux | Design love | Knowing audiences | Showing work | Dribbble | Progressions | Ideas</h3>
<div class="soundcloud-player-small">
</div>
अंतिम विचार
Nokogiri एक विशाल लाइब्रेरी नहीं है, लेकिन इसमें देने के लिए बहुत कुछ है। मैं अनुशंसा करता हूं कि आप अब तक जो सीखा है उससे खेलें और जब आप दीवार से टकराएं तो इसके दस्तावेज़ीकरण के माध्यम से अपने ज्ञान का विस्तार करें। लेकिन खुद को मुसीबत में न डालें!
यह छोटा परिचय आपको यह समझने की राह पर अच्छी तरह से ले जाना चाहिए कि आप क्या कर सकते हैं और यह कैसे काम करता है। मुझे आशा है कि आप इसे थोड़ा और अपने दम पर एक्सप्लोर करेंगे और इसके साथ कुछ मज़ा करेंगे। जैसा कि आप अपने दम पर पता लगाएंगे, यह एक समृद्ध उपकरण है जो देता रहता है।