इस ट्यूटोरियल में, आप सीखेंगे कि मैकेनाइज का उपयोग करके लिंक्स पर क्लिक कैसे करें, फॉर्म्स भरें, और फाइल्स अपलोड करें। आप यह भी सीखेंगे कि मैकेनाइज पेज ऑब्जेक्ट्स को कैसे स्लाइस करें और गूगल खोज को स्वचालित करके इसके परिणामों को कैसे सहेजें।
विषय
- सिंगल पेज बनाम पेजिनेशन
- मैकेनाइज
- एजेंट
- पेज
- नोकोगिरी मेथड्स
- लिंक्स
- क्लिक
- फॉर्म्स
सिंगल पेज बनाम पेजिनेशन
अब तक हमने नोकोगिरी का उपयोग करके एक सिंगल पेज की स्क्रीन को स्क्रैप करने का तरीका जानने में कुछ समय बिताया है। ये कई पेजों से कंटेंट निकालने के लिए एक कदम आगे बढ़ने का एक अच्छा आधार था।
आखिरकार, हम जिस समस्या को हल करने की कोशिश कर रहे हैं उसमें 140 से अधिक एपिसोड्स से कंटेंट प्राप्त करना शामिल है - जो एक सिंगल वेब पेज में उचित रूप से फिट होने वाले कंटेंट से अधिक है। हमें पेजिनेशन के साथ काम करना होगा और रैबिट होल के नीचे कंटेंट का पालन करना सीखना होगा।
यहीं नोकोगिरी रुक जाती है और एक और उपयोगी जेम जिसे मैकेनाइज कहा जाता है, खेल में आता है।
मैकेनाइज
मैकेनाइज एक और शक्तिशाली टूल है जिसमें देने के लिए बहुत सारी अच्छी चीजें हैं। ये अनिवार्य रूप से आपको उन वेबसाइटों के साथ इंटरैक्शन को स्वचालित करने में सक्षम बनाता है जिनसे आपको कंटेंट निकालने की आवश्यकता है। उस अर्थ में ये मुझे कैपिबारा के साथ टेस्टिंग से कुछ कार्यक्षमता की याद दिलाता है।
मुझे गलत न समझें, नोकोगिरी के साथ एक सिंगल पेज पर खेलना अपने आप में बहुत बढ़िया है, लेकिन अधिक मसालेदार डेटा निष्कर्षण कार्यों के लिए, हमें थोड़ी अधिक हॉर्सपावर की आवश्यकता है। हम अनिवार्य रूप से उतने पेजों के माध्यम से क्रॉल कर सकते हैं जितने हमें चाहिए और उनके एलिमेंट्स के साथ इंटरैक्ट कर सकते हैं - मानव व्यवहार की नकल और स्वचालन। बहुत शक्तिशाली सामान!
यह जेम आपको लिंक्स का पालन करने, फॉर्म फील्ड्स भरने, और उस डेटा को सबमिट करने में सक्षम बनाता है - यहां तक कि कुकीज़ के साथ काम करना भी मेज पर है। इसका मतलब है कि आप यूजर्स के निजी सत्रों में लॉगिन की नकल भी कर सकते हैं और उस साइट से कंटेंट प्राप्त कर सकते हैं जिस तक केवल आपकी पहुंच है।
आप अपने क्रेडेंशियल्स के साथ लॉगिन भरते हैं और मैकेनाइज को बताते हैं कि कैसे साथ चलना है। चूंकि आप लिंक्स पर क्लिक कर सकते हैं और फॉर्म्स सबमिट कर सकते हैं, इसलिए इस टूल के साथ आप बहुत कम चीजें नहीं कर सकते। इसका नोकोगिरी के साथ घनिष्ठ संबंध है और ये इस पर निर्भर भी करता है। आरोन पैटरसन फिर से इस प्यारे जेम के लेखकों में से एक हैं।
मैकेनाइज एजेंट को इंस्टेंटिएट करना
इससे पहले कि हम चीजों को मैकेनाइज करना शुरू कर सकें, हमें एक मैकेनाइज एजेंट को इंस्टेंटिएट करने की आवश्यकता है।
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
ये एजेंट एक पेज लाने के लिए उपयोग किया जाएगा, जैसा हमने नोकोगिरी के साथ किया था।
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
podcast_url = "https://betweenscreens.fm/"
page = agent.get(podcast_url)
यहां जो होता है वह यह है कि मैकेनाइज एजेंट को पॉडकास्ट पेज और इसकी कुकीज़ मिल गईं।
पेज कंटेंट निकालना
अब हमारे पास एक पेज है जो निष्कर्षण के लिए तैयार है। इससे पहले कि हम ऐसा करें, मैं सलाह देता हूं कि हम inspect मेथड का उपयोग करके हुड के नीचे एक नज़र डालें।
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
podcast_url = "https://betweenscreens.fm/"
page = agent.get(podcast_url)
puts page.inspect
आउटपुट काफी ठोस है। एक नज़र डालें और खुद देखें कि Mechanize::Page ऑब्जेक्ट में क्या होता है। यहां आप उस पेज के सभी एट्रिब्यूट्स देख सकते हैं।
मेरे लिए, ये आपके द्वारा निकाले जाने वाले डेटा को स्लाइस करने के लिए एक वास्तव में आसान ऑब्जेक्ट है।
आउटपुट
#<Mechanize::Page {url #https://betweenscreens.fm/>} {meta_refresh} {title "Between | Screens "} {iframes #<Mechanize::Page::Frame nil "https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/290328784&color=ff0000&auto...> #<Mechanize::Page::Frame nil "https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/290126141&color=ff0000&auto...> #<Mechanize::Page::Frame nil "https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/289018386&color=ff0000&auto...> #<Mechanize::Page::Frame nil "https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/287425105&color=ff0000&auto...> #<Mechanize::Page::Frame nil "https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/287105342&color=ff0000&auto...> #<Mechanize::Page::Frame nil "https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/221003494&color=ff0000&auto...> #<Mechanize::Page::Frame nil "">https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/218101809&color=ff0000&auto...} {frames} {links #<Mechanize::Page::Link "Logo cube" "/"> #https://github.com/vis-kid/betweenscreens"> #<Mechanize::Page::Link "about" "pages/about/"> #<Mechanize::Page::Link "design" "design/"> #<Mechanize::Page::Link "code" "code/"> #<Mechanize::Page::Link "Randy J. Hunt" "episodes/144/"> #<Mechanize::Page::Link "Jason Long" "episodes/143/"> #<Mechanize::Page::Link "David Heinemeier Hansson" "episodes/142/"> #<Mechanize::Page::Link "Zach Holman" "episodes/141/"> #<Mechanize::Page::Link "Joel Glovier" "episodes/140/"> #<Mechanize::Page::Link "João Ferreira" "episodes/139/"> #<Mechanize::Page::Link "Corwin Harrell" "episodes/138/"> #<Mechanize::Page::Link "Older Stuff »" "page/2/"> #<Mechanize::Page::Link "Exercise" "/tags/exercise/"> #<Mechanize::Page::Link "Company benefits" "/tags/company-benefits/"> #<Mechanize::Page::Link "Tmux" "/tags/tmux/"> #<Mechanize::Page::Link "FileTask" "/tags/filetask/"> #<Mechanize::Page::Link "Decision making" "/tags/decision-making/"> #<Mechanize::Page::Link "Favorite feature" "/tags/favorite-feature/"> #<Mechanize::Page::Link "Working out" "/tags/working-out/"> #<Mechanize::Page::Link "Scott Savarie" "/tags/scott-savarie/"> #<Mechanize::Page::Link "Titles" "/tags/titles/"> #<Mechanize::Page::Link "Erik Spiekermann" "/tags/erik-spiekermann/"> #<Mechanize::Page::Link "Newbie mistakes" "/tags/newbie-mistakes/"> #<Mechanize::Page::Link "Playbook" "/tags/playbook/"> #<Mechanize::Page::Link "Delegation" "/tags/delegation/"> #<Mechanize::Page::Link "Heat maps" "/tags/heat-maps/"> #<Mechanize::Page::Link "Europe" "/tags/europe/"> #<Mechanize::Page::Link "Sizing type" "/tags/sizing-type/"> #<Mechanize::Page::Link "Focus" "/tags/focus/"> #<Mechanize::Page::Link "Virtual assistants" "/tags/virtual-assistants/"> #<Mechanize::Page::Link "Writing" "/tags/writing/"> #<Mechanize::Page::Link "Hacking" "/tags/hacking/"> #<Mechanize::Page::Link "Joel Glovier" "/tags/joel-glovier/"> #<Mechanize::Page::Link "Corwin Harrell" "/tags/corwin-harrell/"> #<Mechanize::Page::Link "Mario C. Delgado" "/tags/mario-c-delgado/"> #<Mechanize::Page::Link "Tom Dale" "/tags/tom-dale/"> #<Mechanize::Page::Link "Obie Fernandez" "/tags/obie-fernandez/"> #<Mechanize::Page::Link "Chad Pytel" "/tags/chad-pytel/"> #<Mechanize::Page::Link "Zach Holman" "/tags/zach-holman/"> #<Mechanize::Page::Link "Max Luster" "/tags/max-luster/"> #<Mechanize::Page::Link "Kyle Fiedler" "/tags/kyle-fiedler/"> #<Mechanize::Page::Link "Roberto Machado" "/tags/roberto-machado/">} {forms}>
अगर आप HTML पेज को स्वयं देखना चाहते हैं, तो आप body या content मेथड्स को टैग कर सकते हैं।
some_scraper.rb
... print page.body ...
आउटपुट
<!doctype html>
<html>
<head>
<meta charset="utf-8" />
<meta http-equiv='X-UA-Compatible' content='IE=edge;chrome=1' />
<meta content="IE=edge,chrome=1" http-equiv="X-UA-Compatible">
<meta name="viewport" content="initial-scale=1">
<title>Between | Screens </title>
<link rel="alternate" type="application/atom+xml" title="Atom Feed" href="/feed.xml" />
<link href="stylesheets/all-11b45acc.css" rel="stylesheet" />
<script src="javascripts/all-4c20da82.js"></script>
</head>
<body>
<header>
<div id="logo">
<a href="/"><img src="images/Between_Screens_Logo_Cube_Up-539d6997.svg" alt="Logo cube" /></a>
</div>
<nav class="navigation">
<ul class="nav-list">
fork">https://github.com/vis-kid/betweenscreens">fork!
<li><a href="pages/about/">about</a></li>
<li><a href="design/">design</a></li>
<li><a href="code/">code</a></li>
</ul>
</nav>
</header>
<div id="main" role="main">
<div class='posts'>
<ul>
<li>
<article class="index-article">
<span class='post-date'>Oct 27 | 2016</span><h2 class='post-title'><a href="episodes/144/">Randy J. Hunt</a></h2>
<h3 class='topic-list'>Organizing teams | Diversity | Desires | Pizza rule | Effective over clever | Novel solutions | Straightforwardness | Research | Coffeeshop test | Small changes | Reducing errors | Granular diffs</h3>
<div class='soundcloud-player-small'>
<iframe width="100%" height="166" scrolling="no" frameborder="no" src="https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/290328784&color=ff0000&...>
</div>
</article>
</li>
<li>
<article class="index-article">
<span class='post-date'>Oct 25 | 2016</span><h2 class='post-title'><a href="episodes/143/">Jason Long</a></h2>
<h3 class='topic-list'>Open source | Empathy | Lower barriers | Learning tool | Design contributions | Git website | Branding | GitHub | Neovim | Tmux | Design love | Knowing audiences | Showing work | Dribbble | Progressions | Ideas</h3>
<div class='soundcloud-player-small'>
<iframe width="100%" height="166" scrolling="no" frameborder="no" src="https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/290126141&color=ff0000&...>
</div>
</article>
</li>
<li>
<article class="index-article">
<span class='post-date'>Oct 18 | 2016</span><h2 class='post-title'><a href="episodes/142/">David Heinemeier Hansson</a></h2>
<h3 class='topic-list'>Rails community | Tone | Technical disagreements | Community policing | Ungratefulness | No assholes allowed | Basecamp | Open source persona | Aspirations | Guarding motivations | Dealing with audiences | Pressure | Honesty | Diverse opinions | Small talk</h3>
<div class='soundcloud-player-small'>
<iframe width="100%" height="166" scrolling="no" frameborder="no" src="https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/289018386&color=ff0000&...>
</div>
</article>
</li>
<li>
<article class="index-article">
<span class='post-date'>Oct 12 | 2016</span><h2 class='post-title'><a href="episodes/141/">Zach Holman</a></h2>
<h3 class='topic-list'>Getting Fired | Taboo | Transparency | Different Perspectives | Timing | Growth Stages | Employment & Dating | Managers | At-will Employment | Tech Industry | Europe | Low hanging Fruits | Performance Improvement Plans | Meeting Goals | Surprise Firings | Firing Fast | Mistakes | Company Culture | Communication</h3>
<div class='soundcloud-player-small'>
<iframe width="100%" height="166" scrolling="no" frameborder="no" src="https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/287425105&color=ff0000&...>
</div>
</article>
</li>
<li>
<article class="index-article">
<span class='post-date'>Oct 10 | 2016</span><h2 class='post-title'><a href="episodes/140/">Joel Glovier</a></h2>
<h3 class='topic-list'>Digital Product Design | Product Design @ GitHub | Loving Design | Order & Chaos | Drawing | Web Design | HospitalRun | Diversity | Startup Culture | Improving Lives | CURE International | Ember | Offline First | Hospital Information System | Designers & Open Source</h3>
<div class='soundcloud-player-small'>
<iframe width="100%" height="166" scrolling="no" frameborder="no" src="https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/287105342&color=ff0000&...>
</div>
</article>
</li>
<li>
<article class="index-article">
<span class='post-date'>Aug 26 | 2015</span><h2 class='post-title'><a href="episodes/139/">João Ferreira</a></h2>
<h3 class='topic-list'>Masters @ Work | Subvisual | Deadlines | Design personality | Design problems | Team | Pushing envelopes | Delightful experiences | Perfecting details | Company values</h3>
<div class='soundcloud-player-small'>
<iframe width="100%" height="166" scrolling="no" frameborder="no" src="https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/221003494&color=ff0000&...>
</div>
</article>
</li>
<li>
<article class="index-article">
<span class='post-date'>Aug 06 | 2015</span><h2 class='post-title'><a href="episodes/138/">Corwin Harrell</a></h2>
<h3 class='topic-list'>Q&A | 01 | University | Graphic design | Design setup | Sublime | Atom | thoughtbot | Working location | Collaboration & pairing | Vim advocates | Daily routine | Standups | Clients | Coffee walks | Investment Fridays |</h3>
<div class='soundcloud-player-small'>
<iframe width="100%" height="166" scrolling="no" frameborder="no" src="https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/218101809&color=ff0000&...>
</div>
</article>
</li>
</ul>
</div>
<section>
<div class='pagination-link'><a href="page/2/">Older Stuff »</a></div>
</section>
</div>
<footer>
<div class='footer-tags'>
<h3>Random Tags</h3>
<ul class='random-tag-list'>
<li><a href="/tags/exercise/">Exercise</a></li>
<li><a href="/tags/company-benefits/">Company benefits</a></li>
<li><a href="/tags/tmux/">Tmux</a></li>
<li><a href="/tags/filetask/">FileTask</a></li>
<li><a href="/tags/decision-making/">Decision making</a></li>
<li><a href="/tags/favorite-feature/">Favorite feature</a></li>
<li><a href="/tags/working-out/">Working out</a></li>
<li><a href="/tags/scott-savarie/">Scott Savarie</a></li>
<li><a href="/tags/titles/">Titles</a></li>
<li><a href="/tags/erik-spiekermann/">Erik Spiekermann</a></li>
<li><a href="/tags/newbie-mistakes/">Newbie mistakes</a></li>
<li><a href="/tags/playbook/">Playbook</a></li>
<li><a href="/tags/delegation/">Delegation</a></li>
<li><a href="/tags/heat-maps/">Heat maps</a></li>
<li><a href="/tags/europe/">Europe</a></li>
<li><a href="/tags/sizing-type/">Sizing type</a></li>
<li><a href="/tags/focus/">Focus</a></li>
<li><a href="/tags/virtual-assistants/">Virtual assistants</a></li>
<li><a href="/tags/writing/">Writing</a></li>
<li><a href="/tags/hacking/">Hacking</a></li>
</ul>
</div>
<div class='recent-posts'>
<h3>Random Interviewees</h3>
<ul>
<li><a href="/tags/joel-glovier/">Joel Glovier</a></li>
<li><a href="/tags/corwin-harrell/">Corwin Harrell</a></li>
<li><a href="/tags/mario-c-delgado/">Mario C. Delgado</a></li>
<li><a href="/tags/tom-dale/">Tom Dale</a></li>
<li><a href="/tags/obie-fernandez/">Obie Fernandez</a></li>
<li><a href="/tags/chad-pytel/">Chad Pytel</a></li>
<li><a href="/tags/zach-holman/">Zach Holman</a></li>
<li><a href="/tags/max-luster/">Max Luster</a></li>
<li><a href="/tags/kyle-fiedler/">Kyle Fiedler</a></li>
<li><a href="/tags/roberto-machado/">Roberto Machado</a></li>
</ul>
</div>
</footer>
</body>
</html>
चूंकि इस पॉडकास्ट में पेज पर केवल कुछ अलग एलिमेंट्स हैं, यहां github.com से लौटाया गया Mechanize::Page है। इसमें देखने के लिए कंटेंट की एक बड़ी विविधता है। मुझे लगता है कि इसके लिए एक फील पाने के लिए ये महत्वपूर्ण है।
आउटपुट github.com
#<Mechanize::Page {url #https://github.com/>} {meta_refresh} {title "How people build software · GitHub"} {iframes} {frames} {links #<Mechanize::Page::Link "Skip to content" "#start-of-content"> #https://github.com/"> #<Mechanize::Page::Link "\n Personal\n" "/personal"> #<Mechanize::Page::Link "\n Open source\n" "/open-source"> #<Mechanize::Page::Link "\n Business\n" "/business"> #<Mechanize::Page::Link "\n Explore\n" "/explore"> #<Mechanize::Page::Link "Sign up" "/join?source=header-home"> #<Mechanize::Page::Link "Sign in" "/login"> #<Mechanize::Page::Link "Pricing" "/pricing"> #<Mechanize::Page::Link "Blog" "/blog"> #https://help.github.com"> #https://github.com/search"> #https://help.github.com/terms"> #https://help.github.com/privacy"> #<Mechanize::Page::Link "Sign up for GitHub" "/join?source=button-home"> #<Mechanize::Page::Link "\n \n \n \n \n A whole new Universe\n \n Learn about the exciting features and announcements revealed at this year's GitHub Universe conference.\n \n \n " "/universe-2016"> #<Mechanize::Page::Link "Individuals " "/personal"> #<Mechanize::Page::Link "Communities " "/open-source"> #<Mechanize::Page::Link "Businesses " "/business"> #<Mechanize::Page::Link "NASA" "//github.com/nasa"> #<Mechanize::Page::Link "Sign up for GitHub" "/join?source=button-home"> #https://github.com/contact"> #https://developer.github.com"> #https://training.github.com"> #https://shop.github.com"> #https://github.com/blog"> #https://github.com/about"> #https://github.com"> #https://github.com/site/terms"> #https://github.com/site/privacy"> #https://github.com/security"> #https://status.github.com/"> #https://help.github.com"> #<Mechanize::Page::Link "Reload" ""> #<Mechanize::Page::Link "Reload" "">} {forms #<Mechanize::Form {name nil} {method "GET"} {action "/search"} {fields [hidden:0x3feb90f8297c type: hidden name: utf8 value: ✓] [hidden:0x3feb90f827d8 type: hidden name: hl value: es] [hidden:0x3feb90f825f4 type: hidden name: source value: hp] [hidden:0x3feb90f82428 type: hidden name: biw value: ] [hidden:0x3feb90f82248 type: hidden name: bih value: ] # Attention!! [text:0x3feb90f820f4 type: name: q value: ] # Attention!! [hidden:0x3feb90f81bcb4 type: hidden name: gbv value: 1]} {radiobuttons} {checkboxes} {file_uploads} {buttons [button:0x3feb90f81a038 type: submit name: value: ]}> #<Mechanize::Form {name nil} {method "POST"} {action "/join"} {fields [hidden:0x3feb90f7be38 type: hidden name: utf8 value: ✓] [hidden:0x3feb90f7bbb8 type: hidden name: authenticity_token value: vjRATKj7smXreq6Lt02r+MzW+ewWoi+fRzQXPedFAlOZgwzxQ0dZnChirhDfd7vyWZZZBO+ZFydLNedjIEDsrQ==] [text:0x3feb90f7b9d8 type: text name: user[login] value: ] [text:0x3feb90f7b7f8 type: text name: user[email] value: ] [field:0x3feb90f7b654 type: password name: user[password] value: ] [hidden:0x3feb90f7b474 type: hidden name: source value: form-home]} {radiobuttons} {checkboxes} {file_uploads} {buttons [button:0x3feb90f7a038 type: submit name: value: ]}>}>
पॉडकास्ट पर वापस, आप एन्कोडिंग्स, HTTP प्रतिक्रिया कोड, URI, या प्रतिक्रिया हेडर्स जैसी चीजों को भी देख सकते हैं।
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
podcast_url = "https://betweenscreens.fm/"
page = agent.get(podcast_url)
puts 'Encodings'
puts page.encodings
puts 'Repsonse Headers'
puts page.response
puts 'HTTP response code'
puts page.code
puts 'URI'
puts page.uri
आउटपुट
Encodings
EUC-JP
utf-8
utf-8
Repsonse Headers
{"server"=>"GitHub.com", "date"=>"Sat, 29 Oct 2016 17:56:00 GMT", "content-type"=>"text/html; charset=utf-8", "transfer-encoding"=>"chunked", "last-modified"=>"Fri, 28 Oct 2016 01:48:56 GMT", "access-control-allow-origin"=>"*", "expires"=>"Sat, 29 Oct 2016 18:06:00 GMT", "cache-control"=>"max-age=600", "content-encoding"=>"gzip", "x-github-request-id"=>"501C936D:C723:1631523C:5814E2B0"}
HTTP response code
200
URI
https://betweenscreens.fm/
अगर आप गहराई से जाना चाहते हैं तो और भी बहुत कुछ है। मैं इसे यहीं छोड़ दूंगा।
नोकोगिरी मेथड्स
atsearch
मैकेनाइज पेजेज से डेटा स्क्रैप करने के लिए नोकोगिरी का उपयोग करता है। आप पहले लेख में नोकोगिरी के बारे में जो सीखा उसे लागू कर सकते हैं और इसे मैकेनाइज पेजेज पर भी उपयोग कर सकते हैं। इसका मतलब है कि आप आमतौर पर पेजेज को नेविगेट करने के लिए मैकेनाइज का उपयोग करते हैं और अपनी स्क्रैपिंग जरूरतों के लिए नोकोगिरी मेथड्स का उपयोग करते हैं।
उदाहरण के लिए, यदि आप एक सिंगल ऑब्जेक्ट खोजना चाहते हैं, तो आप at का उपयोग कर सकते हैं, जबकि search एक विशेष पेज पर एक सेलेक्टर से मेल खाने वाले सभी ऑब्जेक्ट्स को लौटाता है। इसे दोबारा कहें, तो ये मेथड्स नोकोगिरी डॉक्यूमेंट ऑब्जेक्ट्स और मैकेनाइज पेज ऑब्जेक्ट्स दोनों पर काम करेंगे।
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
podcast_url = "https://betweenscreens.fm/"
page = agent.get(podcast_url)
first_title = page.at('h2.post-title')
all_titles = page.search('h2.post-title')
all_titles.each do |title|
  puts title
end
puts " * "*33
puts first_title
आउटपुट
<h2 class="post-title"><a href="episodes/144/">Randy J. Hunt</a></h2>
<h2 class="post-title"><a href="episodes/143/">Jason Long</a></h2>
<h2 class="post-title"><a href="episodes/142/">David Heinemeier Hansson</a></h2>
<h2 class="post-title"><a href="episodes/141/">Zach Holman</a></h2>
<h2 class="post-title"><a href="episodes/140/">Joel Glovier</a></h2>
<h2 class="post-title"><a href="episodes/139/">João Ferreira</a></h2>
<h2 class="post-title"><a href="episodes/138/">Corwin Harrell</a></h2>
* * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * *
<h2 class="post-title"><a href="episodes/144/">Randy J. Hunt</a></h2>
लिंक्स
linkslink_withlinks_with
हम अपनी पसंद के अनुसार पूरी साइट को नेविगेट भी कर सकते हैं। शायद मैकेनाइज का सबसे महत्वपूर्ण हिस्सा इसकी क्षमता है जो आपको लिंक्स के साथ खेलने देती है। अन्यथा आप बहुत ज्यादा नोकोगिरी पर अपने दम पर टिके रह सकते थे। आइए देखें कि अगर हम किसी पेज से उसके लिंक्स मांगते हैं तो हमें क्या मिलता है।
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
podcast_url = "https://betweenscreens.fm/"
page = agent.get(podcast_url)
puts "#{page.links}"
आउटपुट
[#<Mechanize::Page::Link "Logo cube" "/"> , #https://github.com/vis-kid/betweenscreens"> , #<Mechanize::Page::Link "about" "pages/about/"> , #<Mechanize::Page::Link "design" "design/"> , #<Mechanize::Page::Link "code" "code/"> , #<Mechanize::Page::Link "Randy J. Hunt" "episodes/144/"> , #<Mechanize::Page::Link "Jason Long" "episodes/143/"> , #<Mechanize::Page::Link "David Heinemeier Hansson" "episodes/142/"> , #<Mechanize::Page::Link "Zach Holman" "episodes/141/"> , #<Mechanize::Page::Link "Joel Glovier" "episodes/140/"> , #<Mechanize::Page::Link "João Ferreira" "episodes/139/"> , #<Mechanize::Page::Link "Corwin Harrell" "episodes/138/"> , #<Mechanize::Page::Link "Older Stuff »" "page/2/"> , #<Mechanize::Page::Link "Exercise" "/tags/exercise/"> , #<Mechanize::Page::Link "Company benefits" "/tags/company-benefits/"> , #<Mechanize::Page::Link "Tmux" "/tags/tmux/"> , #<Mechanize::Page::Link "FileTask" "/tags/filetask/"> , #<Mechanize::Page::Link "Decision making" "/tags/decision-making/"> , #<Mechanize::Page::Link "Favorite feature" "/tags/favorite-feature/"> , #<Mechanize::Page::Link "Working out" "/tags/working-out/"> , #<Mechanize::Page::Link "Scott Savarie" "/tags/scott-savarie/"> , #<Mechanize::Page::Link "Titles" "/tags/titles/"> #<Mechanize::Page::Link "Erik Spiekermann" "/tags/erik-spiekermann/"> #<Mechanize::Page::Link "Newbie mistakes" "/tags/newbie-mistakes/"> #<Mechanize::Page::Link "Playbook" "/tags/playbook/"> #<Mechanize::Page::Link "Delegation" "/tags/delegation/"> #<Mechanize::Page::Link "Heat maps" "/tags/heat-maps/"> #<Mechanize::Page::Link "Europe" "/tags/europe/"> #<Mechanize::Page::Link "Sizing type" "/tags/sizing-type/"> #<Mechanize::Page::Link "Focus" "/tags/focus/"> #<Mechanize::Page::Link "Virtual assistants" "/tags/virtual-assistants/"> #<Mechanize::Page::Link "Writing" "/tags/writing/"> #<Mechanize::Page::Link "Hacking" "/tags/hacking/"> #<Mechanize::Page::Link "Joel Glovier" "/tags/joel-glovier/"> #<Mechanize::Page::Link "Corwin Harrell" "/tags/corwin-harrell/"> #<Mechanize::Page::Link "Mario C. Delgado" "/tags/mario-c-delgado/"> #<Mechanize::Page::Link "Tom Dale" "/tags/tom-dale/"> #<Mechanize::Page::Link "Obie Fernandez" "/tags/obie-fernandez/"> #<Mechanize::Page::Link "Chad Pytel" "/tags/chad-pytel/"> #<Mechanize::Page::Link "Zach Holman" "/tags/zach-holman/"> #<Mechanize::Page::Link "Max Luster" "/tags/max-luster/"> #<Mechanize::Page::Link "Kyle Fiedler" "/tags/kyle-fiedler/"> #<Mechanize::Page::Link "Roberto Machado" "/tags/roberto-machado/"> ]
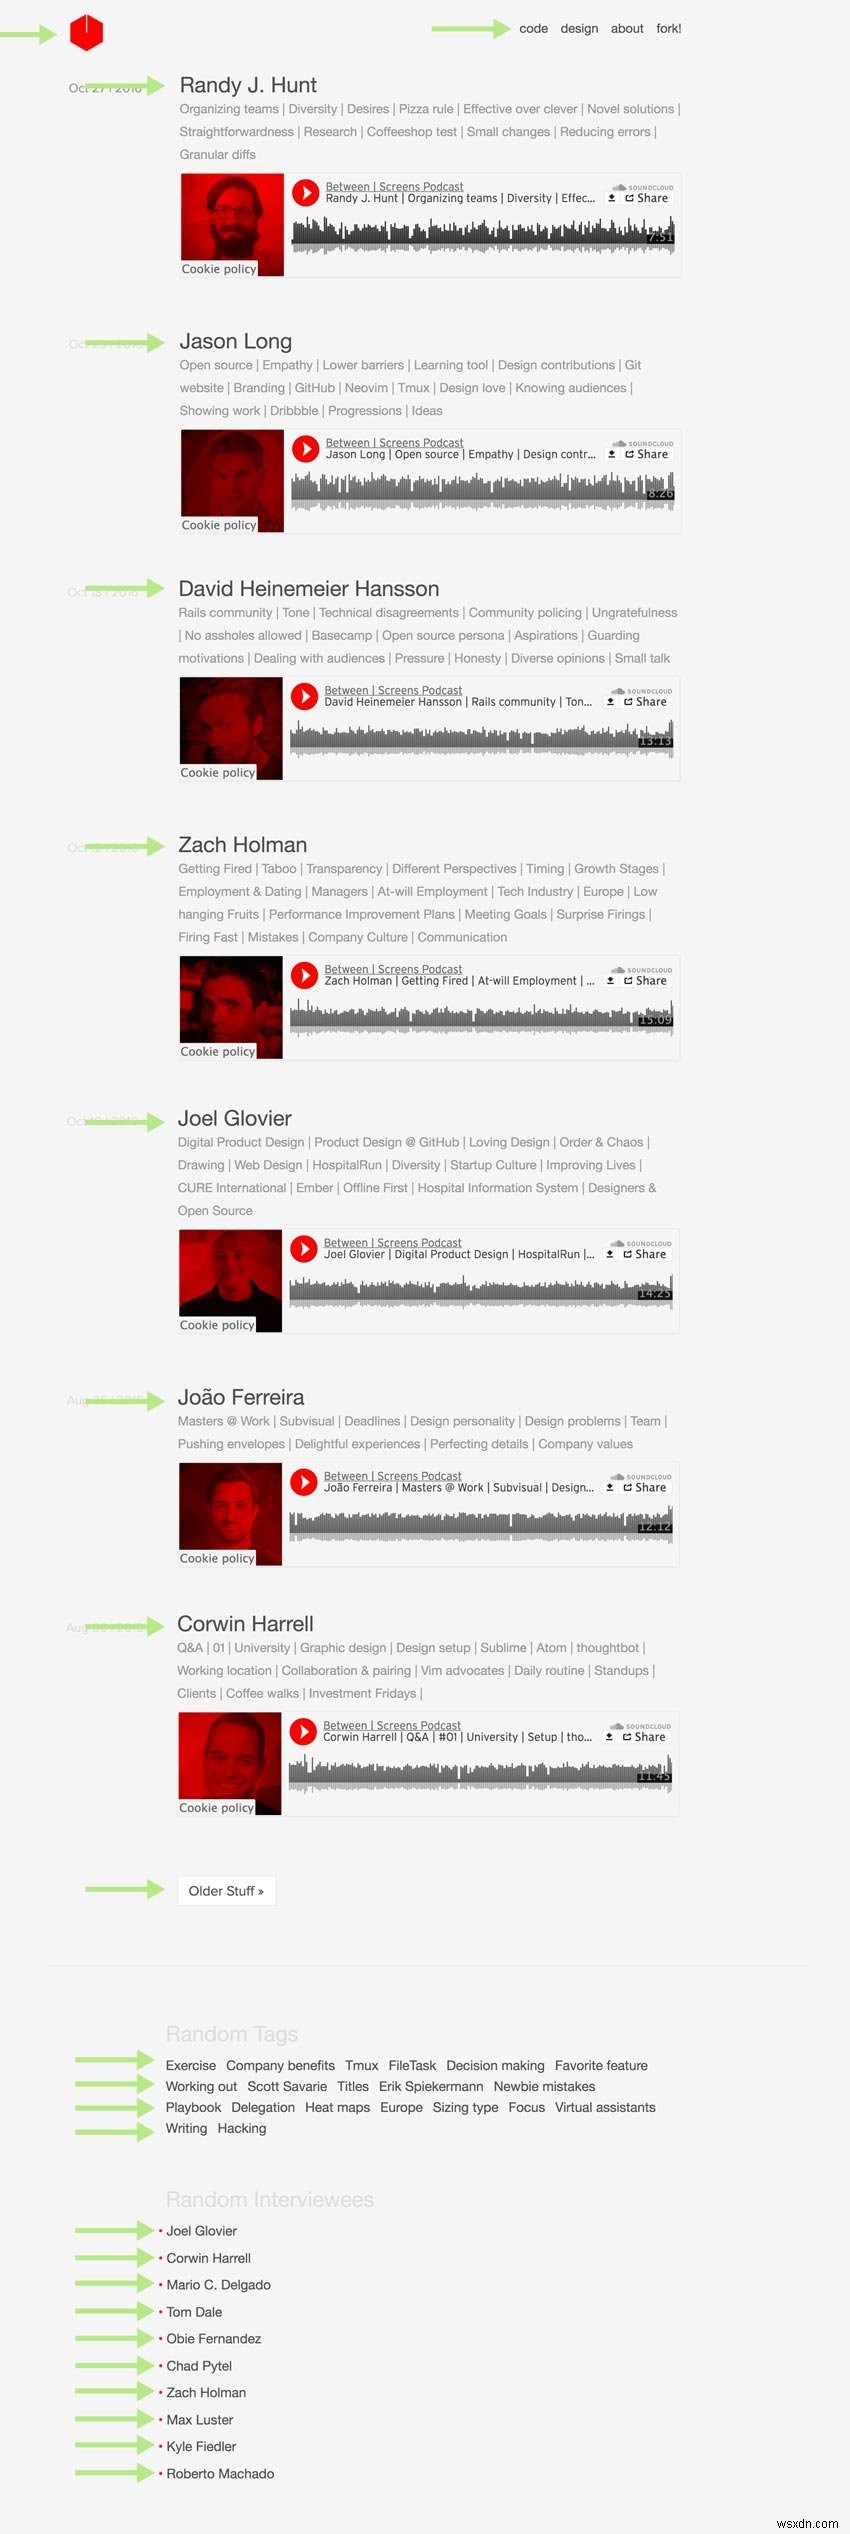
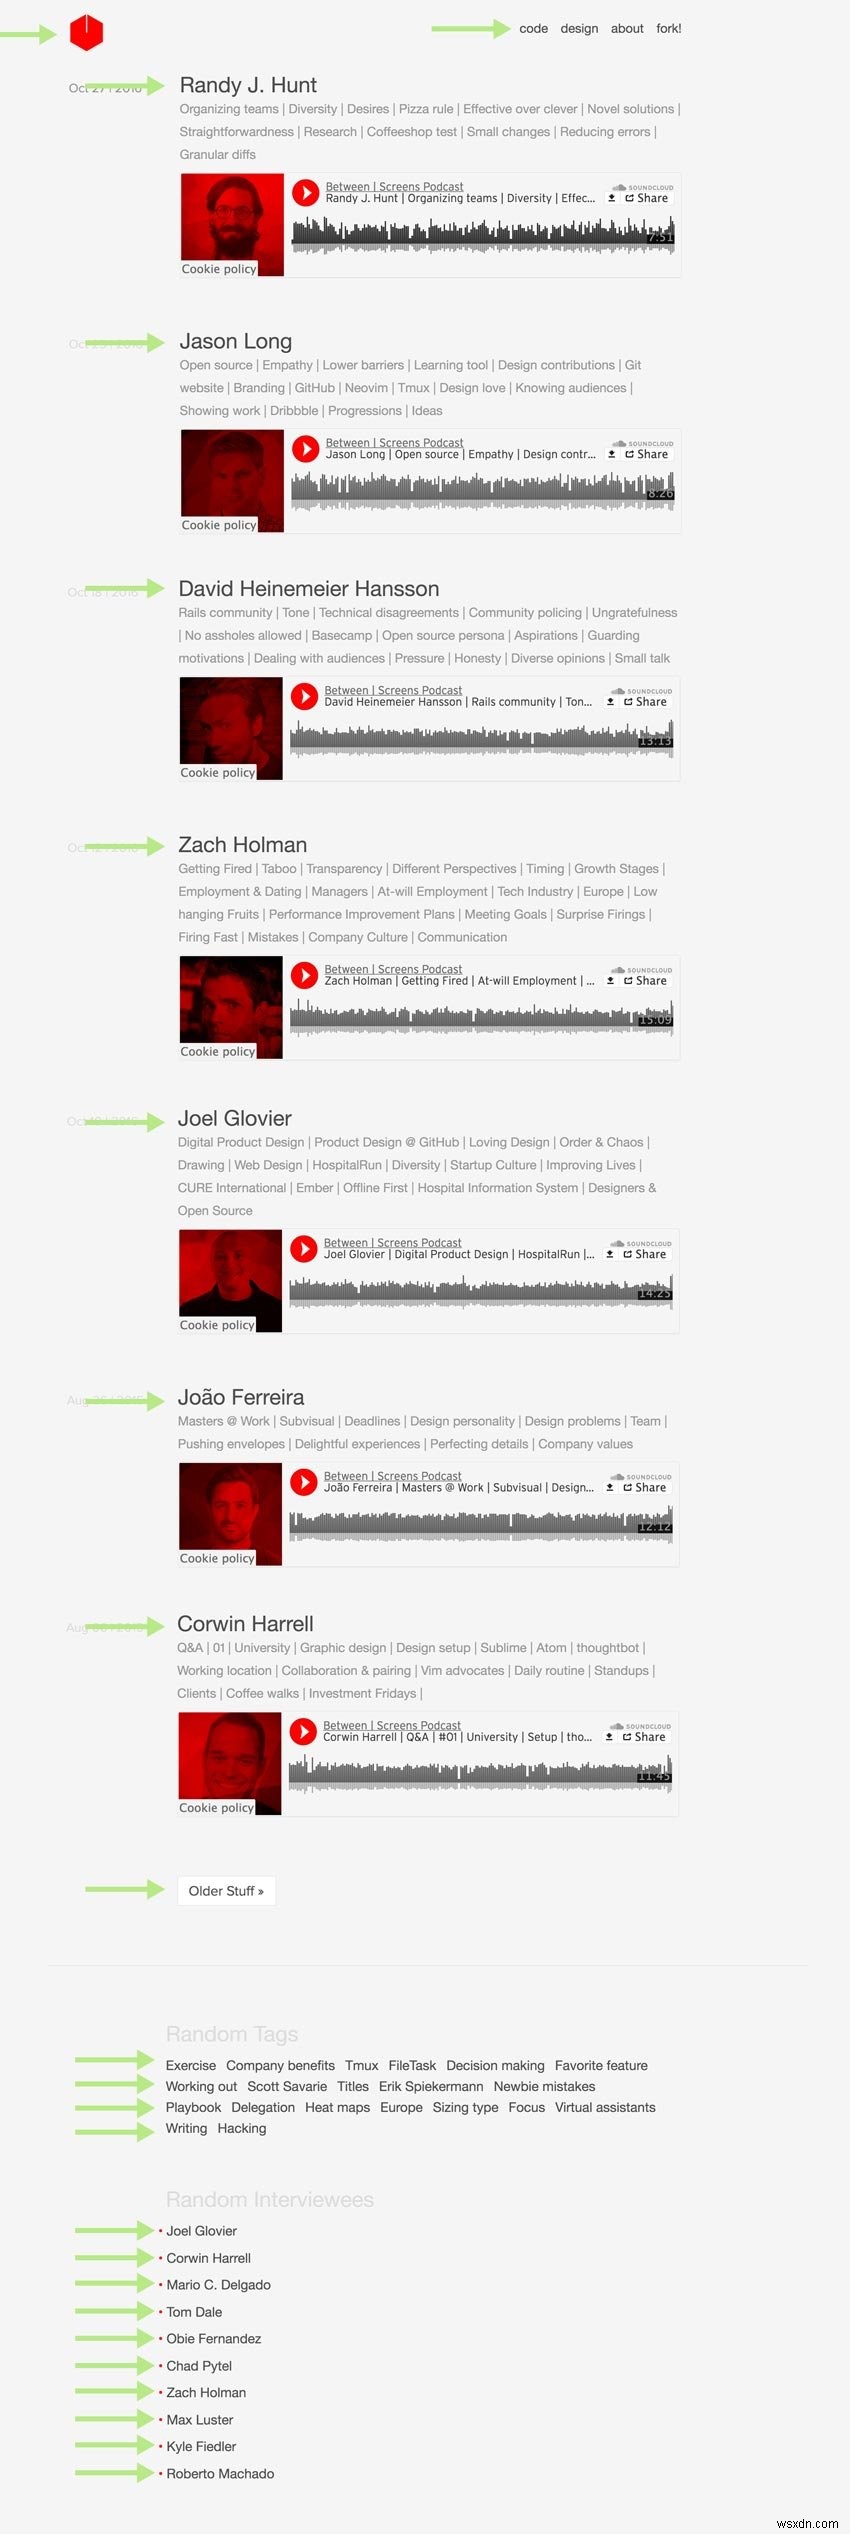
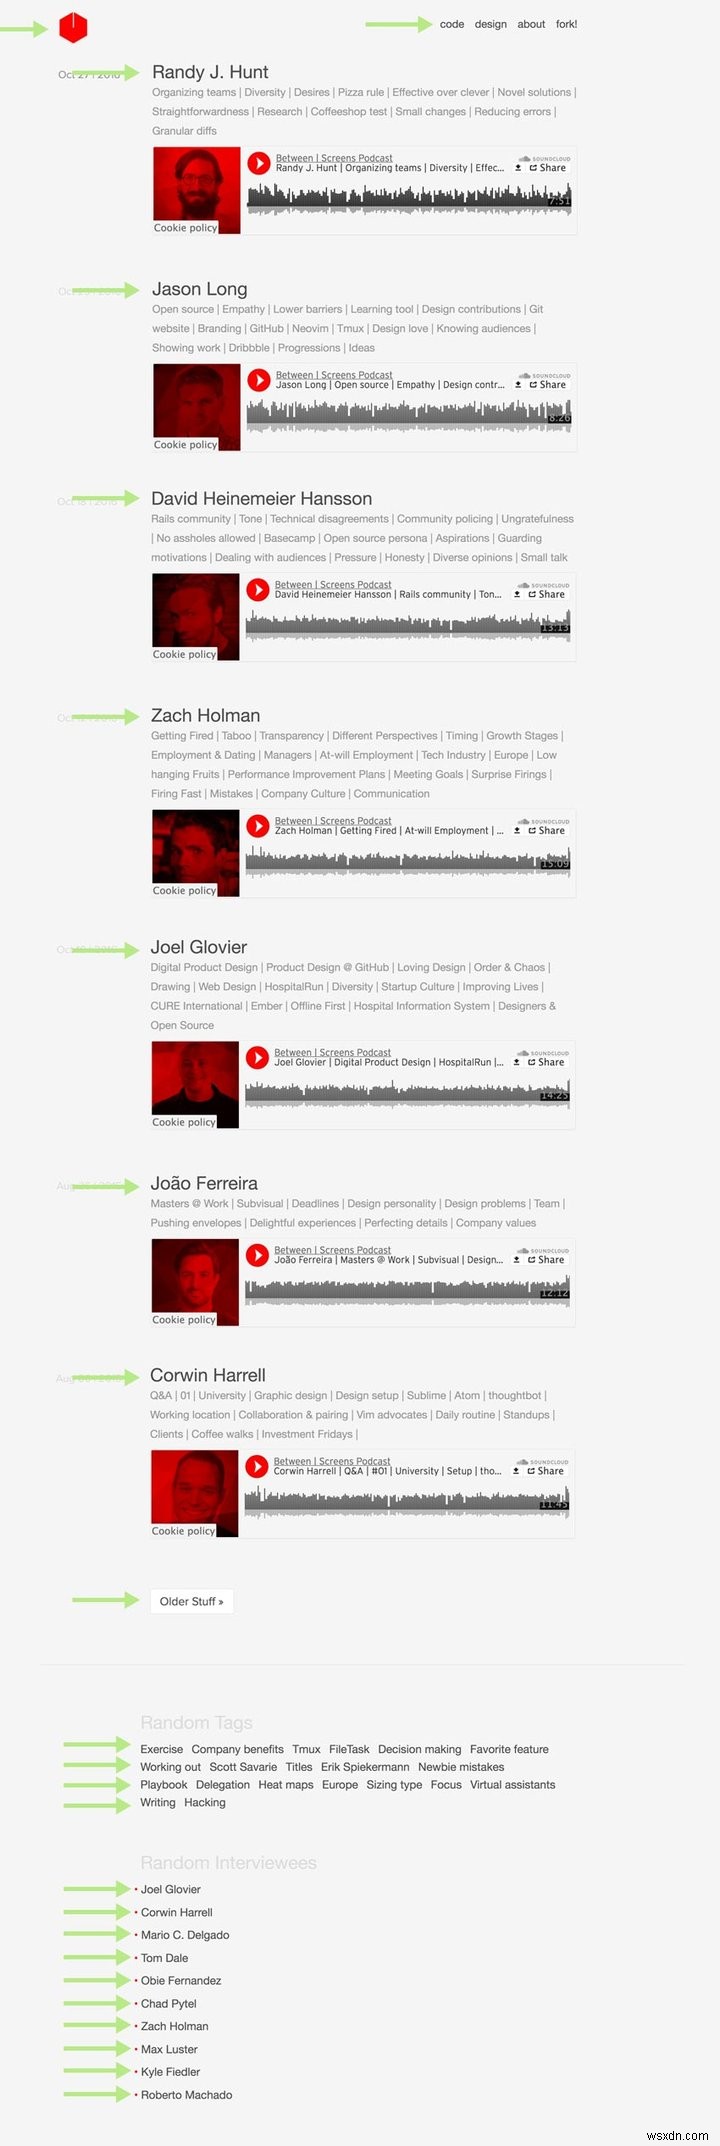
होली मॉली, आइए इसे तोड़ते हैं। चूंकि हमने मैकेनाइज को कहीं और देखने के लिए नहीं कहा है, हमें केवल उस पहले पेज से लिंक्स की एक सरणी मिली। मैकेनाइज उस पेज को अवरोही क्रम में जाता है और आपको ऊपर से नीचे तक लिंक्स की यह सूची देता है। मैंने विभिन्न लिंक्स के लिए हरे पॉइंटर्स के साथ एक छोटी सी छवि बनाई है जिन्हें आप आउटपुट में देख सकते हैं।
वैसे, ये पहले से ही मेरे पॉडकास्ट के रीडिजाइन का अंतिम परिणाम दिखा रहा है। मुझे लगता है कि प्रदर्शन उद्देश्यों के लिए ये संस्करण थोड़ा बेहतर है। आपको यह भी झलक मिलती है कि अंतिम परिणाम कैसा दिखता है और मुझे अपने पुराने सिनात्रा साइट को स्क्रैप करने की आवश्यकता क्यों पड़ी।
स्क्रीनशॉट
हमेशा की तरह, हम उससे सिर्फ टेक्स्ट भी निकाल सकते हैं।
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
podcast_url = "https://betweenscreens.fm/"
page = agent.get(podcast_url)
page.links.each do |link|
  puts link.text
end
आउटपुट
Logo cube
fork!
about
design
code
Randy J. Hunt
Jason Long
David Heinemeier Hansson
Zach Holman
Joel Glovier
João Ferreira
Corwin Harrell
Older Stuff »
Exercise
Company benefits
Tmux
FileTask
Decision making
Favorite feature
Working out
Scott Savarie
Titles
Erik Spiekermann
Newbie mistakes
Playbook
Delegation
Heat maps
Europe
Sizing type
Focus
Virtual assistants
Writing
Hacking
Joel Glovier
Corwin Harrell
Mario C. Delgado
Tom Dale
Obie Fernandez
Chad Pytel
Zach Holman
Max Luster
Kyle Fiedler
Roberto Machado
इन सभी लिंक्स को बल्क में प्राप्त करना बहुत उपयोगी या बस थकाऊ हो सकता है। सौभाग्य से हमारे लिए, हमारे पास जो चाहिए उसे ठीक करने के लिए कुछ टूल्स मौजूद हैं।
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
podcast_url = "https://betweenscreens.fm/"
page = agent.get(podcast_url)
focus_link = agent.page.links.find { |link| link.text == 'Focus' }
puts focus_link
आउटपुट
Focus
बूम! अब हम कहीं पहुंच रहे हैं! हम इस तरह विशिष्ट लिंक्स पर ज़ूम इन कर सकते हैं। हम एक अच्छे API जैसे links_with या link_with के साथ एक निश्चित मानदंड से मेल खाने वाले लिंक्स को लक्षित कर सकते हैं - जैसे इसका टेक्स्ट, उदाहरण के लिए। साथ ही, अगर हमारे पास कई Focus लिंक्स हैं, तो हम ब्रैकेट्स [] का उपयोग करके पेज पर एक विशेष नंबर पर ज़ूम इन कर सकते हैं।
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
podcast_url = "https://betweenscreens.fm/"
page = agent.get(podcast_url)
focus_link = agent.page.links_with(:text => 'Focus')[2]
puts focus_link
अगर आप लिंक टेक्स्ट के बाद नहीं बल्कि लिंक के बाद हैं, तो आपको केवल उस विशेष href को निर्दिष्ट करने की आवश्यकता है जिसे आप ढूंढना चाहते हैं। मैकेनाइज आपके रास्ते में खड़ा नहीं होगा। text के बजाय, आप मेथड्स को href के साथ फीड करते हैं।
some_scraper.rb
page = agent.page.link_with(href: '/episodes/95/')
page = agent.page.links_with(href: '/episodes/95/')
अगर आप केवल वांछित टेक्स्ट वाले पहले लिंक को ढूंढना चाहते हैं, तो आप इस सिंटैक्स का भी उपयोग कर सकते हैं। बहुत सुविधाजनक और थोड़ा अधिक पठनीय।
some_scraper.rb
focus_links = agent.page.link_with(:text => 'Focus')
उस साथी का पीछा करने और यह देखने के बारे में क्या कि इस Focus लिंक के पीछे क्या छिपा है? आइए इसे क्लिक करें!
क्लिक
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
podcast_url = "https://betweenscreens.fm/"
page = agent.get(podcast_url)
focus_links = agent.page.links.find { |link| link.text == 'Focus' }.click.links
puts focus_links
यह हमें पहले की तरह लिंक्स की एक और लंबी सूची देगा। देखें कि .click.links को संयोजित करना कितना आसान था। मैकेनाइज आपके लिए लिंक पर क्लिक करता है और नए गंतव्य पर पेज का पालन करता है। चूंकि हमने लिंक्स की एक सूची का भी अनुरोध किया था, हमें उस नए पेज पर मैकेनाइज को मिलने वाले सभी लिंक्स मिलेंगे।
मान लीजिए मेरे पास एक ही इंटरव्यूई के दो टेक्स्ट लिंक्स हैं - एक जो टैग्स से लिंक करता है और एक हाल के एपिसोड से - और मैं इनमें से प्रत्येक पेज से लिंक्स प्राप्त करना चाहता हूं।
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
podcast_url = "https://betweenscreens.fm/"
page = agent.get(podcast_url)
links = agent.page.links_with(text: "Some interviewee")
links.each do |link|
  puts link.click.links
end
यह आपको दोनों पेजेज के लिए लिंक्स की एक सूची देगा। आप इंटरव्यूई के लिए प्रत्येक लिंक पर पुनरावृति करते हैं, और मैकेनाइज क्लिक किए गए लिंक का पालन करता है और आपके लिए नए पेज पर मिलने वाले लिंक्स को एकत्र करता है। नीचे आपको कुछ उदाहरण मिल सकते हैं जहां आप शुरू करने के लिए संयोजनों की तुलना कर सकते हैं।
some_scraper.rb
agent.page.links.find { |l| l.text == 'Focus' }
agent.page.links.find { |l| l.text == 'Focus' }.click
agent.page.link_with(text: 'Focus')
agent.page.links_with(text: 'Focus')[0]
agent.page.links_with(text: 'Focus')[1].click
agent.page.links_with(text: 'Focus')[2].click.links
agent.page.link_with(href: '/some-href')
agent.page.link_with(href: '/some-href').click
agent.page.links_with(href: '/some-href')
agent.page.links_with(href: '/some-href').click
फॉर्म्स
submitfield_withcheckbox_withradiobuttons_withfile_uploads
आइए फॉर्म्स पर एक नज़र डालते हैं!
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
google_url = "https://google.com/"
page = agent.get(google_url)
forms = page.forms
puts forms.inspect
आउटपुट
[#<Mechanize::Form # Attention!! {name "f"} # Attention!! {method "GET"} {action "/search"} {fields [hidden:0x3fea91d2eb08 type: hidden name: ie value: ISO-8859-1] [hidden:0x3fea91d2e964 type: hidden name: hl value: es] [hidden:0x3fea91d2e7e8 type: hidden name: source value: hp] [hidden:0x3fea91d2e5f4 type: hidden name: biw value: ] [hidden:0x3fea91d2e428 type: hidden name: bih value: ] # Attention!! [text:0x3fea91d2e248 type: name: q value: ] # Attention!! [hidden:0x3fea91d2bcb4 type: hidden name: gbv value: 1]} {radiobuttons} {checkboxes} {file_uploads} {buttons [submit:0x3fea91d2e0f4 type: submit name: btnG value: Buscar con Google] [submit:0x3fea91d2be80 type: submit name: btnI value: Voy a tener suerte]}> ]
क्योंकि हम forms मेथड का उपयोग करते हैं, हमें एक सरणी वापस मिलती है - भले ही हमारे पास केवल एक फॉर्म वापस आया हो। अब जब हम जानते हैं कि फॉर्म का नाम "f" है, तो हम उस पर ध्यान केंद्रित करने के लिए एकवचन संस्करण form का उपयोग कर सकते हैं।
... {name "f"} ...
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
google_url = "https://google.com/"
page = agent.get(google_url)
search_form = page.form('f')
puts search_form.inspect
form('f') का उपयोग करके, हम उस विशेष फॉर्म को चुनते हैं जिसके साथ हम काम करना चाहते हैं। परिणामस्वरूप, हमें एक सरणी वापस नहीं मिलेगी।
आउटपुट
#<Mechanize::Form # Attention!! {name "f"} # Attention!! {method "GET"} {action "/search"} {fields [hidden:0x3ffe9ce85ba4 type: hidden name: ie value: ISO-8859-1] [hidden:0x3ffe9ce859d8 type: hidden name: hl value: es] [hidden:0x3ffe9ce857bc type: hidden name: source value: hp] [hidden:0x3ffe9ce85618 type: hidden name: biw value: ] [hidden:0x3ffe9ce853e8 type: hidden name: bih value: ] # Attention!! [text:0x3ffe9ce851cc type: name: q value: ] # Attention!! [hidden:0x3ffe9ce84bdc type: hidden name: gbv value: 1]} {radiobuttons} {checkboxes} {file_uploads} {buttons [submit:0x3ffe9ce85078 type: submit name: btnG value: Buscar con Google] [submit:0x3ffe9ce84e48 type: submit name: btnI value: Voy a tener suerte]}>
हम टेक्स्ट इनपुट फील्ड के नाम (q) की पहचान भी कर सकते हैं।
... [text:0x3ffe9ce851cc type: name: q value: ] ...
हम इसे उस नाम से लक्षित कर सकते हैं और इसके मान को रूबी एट्रिब्यूट्स की तरह सेट कर सकते हैं। हमें बस इसे एक नया मान प्रदान करने की आवश्यकता है। आप ऊपर के आउटपुट उदाहरण से देख सकते हैं कि यह डिफ़ॉल्ट रूप से खाली है।
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
google_url = "https://google.com/"
page = agent.get(google_url)
search_form = page.form('f')
search_form.q = 'New Google Search'
puts search_form.inspect
आउटपुट
#<Mechanize::Form {name "f"} {method "GET"} {action "/search"} {fields [hidden:0x3fcb85b6a784 type: hidden name: ie value: ISO-8859-1] [hidden:0x3fcb85b6a57c type: hidden name: hl value: es] [hidden:0x3fcb85b6a3b0 type: hidden name: source value: hp] [hidden:0x3fcb85b6a16c type: hidden name: biw value: ] [hidden:0x3fcb85b67f20 type: hidden name: bih value: ] # Attention!! [text:0x3fcb85b67d18 type: name: q value: New Google Search] # Attention!! [hidden:0x3fcb85b67728 type: hidden name: gbv value: 1]} {radiobuttons} {checkboxes} {file_uploads} {buttons [submit:0x3fcb85b67b9c type: submit name: btnG value: Buscar con Google] [submit:0x3fcb85b67994 type: submit name: btnI value: Voy a tener suerte]}>
जैसा कि आप ऊपर देख सकते हैं, टेक्स्ट फील्ड का मान New Google Search में बदल गया है। अब हमें केवल फॉर्म को सबमिट करने और उस पेज से परिणाम एकत्र करने की आवश्यकता है जो गूगल लौटाता है। ये इससे आसान नहीं हो सकता। आइए इस बार कुछ और खोजते हैं!
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
google_url = "https://google.com/"
page = agent.get(google_url)
search_form = page.form('f')
search_form.q = 'GitHub TouchFart'
page = agent.submit(search_form)
pp page.search('h3.r').map(&:text)
यहां मैंने CSS सेलेक्टर h3.r का उपयोग करके खोज परिणाम हेडर की पहचान की, इसके text को मैप किया, और परिणामों को प्रिटी प्रिंट किया। ये इतना कठिन नहीं था, है ना? ये एक आसान उदाहरण है, निश्चित रूप से, लेकिन उन अंतहीन संभावनाओं के बारे में सोचें जो आपके पास इस टूल के साथ हैं!
आउटपुट
["GitHub - hungtruong/TouchFart: A fart app for the new Macbook ...", "TouchFart/TouchFart at master · hungtruong/TouchFart · GitHub", "Commits · hungtruong/TouchFart · GitHub", "Projects · hungtruong/TouchFart · GitHub", "Pull Requests · hungtruong/TouchFart · GitHub", "Issues · hungtruong/TouchFart · GitHub", "TouchFart/license.txt at master · hungtruong/TouchFart · GitHub", "Add autoplay attribute to <audio> tag and touchfart (er ... - GitHub", "Find file - File Finder · GitHub", "Fart app for the new Macbook Pro's Touch... #3860 on topic touchfart ..."]
मैकेनाइज में आपके लिए खेलने के लिए विभिन्न इनपुट फील्ड्स उपलब्ध हैं। आप फाइल्स भी अपलोड कर सकते हैं!
field_withcheckbox_withradiobuttons_withfile_uploads
आप उनके नाम से रेडियो बटन्स और चेकबॉक्स की पहचान भी कर सकते हैं और उन्हें - आपने अनुमान लगाया - चेक के साथ चेक कर सकते हैं।
some_scraper.rb
form.radiobuttons_with(:name => 'gender')[3].check
form.checkbox_with(:name => 'coder').check
ऑप्शन टैग्स यूजर्स को ड्रॉप-डाउन सूची से एक आइटम चुनने की पेशकश करते हैं। फिर से, हम उन्हें नाम से लक्षित करते हैं और हमारे द्वारा चाहने वाले विकल्प संख्या का चयन करते हैं।
some_scraper.rb
form.field_with(:name => 'countries').options[22].select
फाइल अपलोड्स फॉर्म में टेक्स्ट इनपुट करने के समान काम करते हैं इसे रूबी एट्रिब्यूट्स की तरह सेट करके। आप अपलोड फील्ड की पहचान करते हैं और फिर उस फाइल पथ (फाइल नाम) को निर्दिष्ट करते हैं जिसे आप स्थानांतरित करना चाहते हैं। ये जितना लगता है उससे कहीं अधिक जटिल लगता है। आइए एक नज़र डालते हैं!
some_scraper.rb
form.file_uploads.first.file_name = "some-path/some-image.jpg"
अंतिम विचार
देखें, कोई जादू नहीं! अब आप अपने दम पर कुछ मजा करने के लिए अच्छी तरह से सुसज्जित हैं। नोकोगिरी और मैकेनाइज के बारे में सीखने के लिए निश्चित रूप से थोड़ा अधिक है, लेकिन एक शुरुआती लेख के दायरे से परे समस्याओं में चलने पर अनावश्यक पहलुओं पर बहुत अधिक समय बिताने के बजाय, इसके साथ खेलें और कुछ और डॉक्यूमेंटेशन देखें।
मुझे आशा है कि आप देख सकते हैं कि ये जेम कितना खूबसूरती से सरल है और कितनी शक्ति प्रदान करता है। जैसा कि हम अब लोकप्रिय संस्कृति से जानते हैं, ये जिम्मेदारियां भी वहन करता है। इसका उपयोग कानूनी ढांचे के भीतर करें और जब आपके पास API तक पहुंच न हो। आपको शायद इन टूल्स का बार-बार उपयोग न हो, लेकिन जब आपके आगे कुछ वास्तविक स्क्रैपिंग आवश्यकताएं हों तो ये बहुत काम आते हैं।
जैसा कि वादा किया गया था, अगले लेख में हम एक वास्तविक-विश्व उदाहरण को कवर करेंगे जहां मैं अपनी पॉडकास्ट साइट से डेटा स्क्रैप करूंगा। मैं इसे एक पुराने सिनात्रा साइट से निकालूंगा और इसे अपने नए मिडलमैन साइट पर ट्रांसफर करूंगा जो प्रत्येक एपिसोड के लिए .markdown फाइल्स का उपयोग करता है। हम तारीखें, एपिसोड नंबर, इंटरव्यूई नाम, हेडर्स, सबहेडर्स, और इसी तरह निकालेंगे। वहां मिलते हैं!