यदि आपको टेक्स्ट का एक बड़ा संग्रह दिया जाए और आप उससे कुछ अर्थ निकालना चाहें तो आप क्या करेंगे?
एक अच्छी शुरुआत है अपने टेक्स्ट को n-grams में तोड़ना।
यहां एक विवरण है:
कम्प्यूटेशनल लिंग्विस्टिक्स और संभावना के क्षेत्रों में, एक n-gram टेक्स्ट के दिए गए अनुक्रम से n आइटम्स का एक सन्निकट अनुक्रम है। – विकिपीडिया
उदाहरण के लिए:
यदि हम वाक्यांश "Hello there, how are you?" लेते हैं तो यूनिग्राम (एक एलिमेंट के ngrams) होंगे: "Hello", "there", "how", "are", "you", और बाइग्राम (दो एलिमेंट्स के ngrams): ["Hello", "there"], ["there", "how"], ["how", "are"], ["are", "you"]।
यदि आप छवियों के साथ बेहतर सीखते हैं तो यहां उसका एक चित्र है:
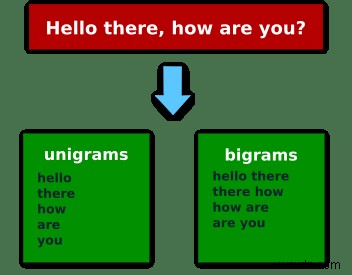
अब आइए देखते हैं कि आप इसे रूबी में कैसे लागू कर सकते हैं!
नमूना डेटा डाउनलोड करना
इससे पहले कि हम अपने हाथ गंदे कर सकें हमें कुछ नमूना डेटा चाहिए।
यदि आपके पास काम करने के लिए कोई नहीं है तो आप कुछ विकिपीडिया या ब्लॉग लेख डाउनलोड कर सकते हैं। इस विशेष मामले में, मैंने #ruby फ्रीनोड के चैनल से कुछ IRC लॉग डाउनलोड करने का फैसला किया।
लॉग यहां पाए जा सकते हैं:
irclog.whitequark.org/ruby
डेटा फॉर्मेट्स पर एक नोट:
यदि आप जिस संसाधन का विश्लेषण करना चाहते हैं उसका सादा टेक्स्ट संस्करण उपलब्ध नहीं है, तो आप पेज को पार्स करने और डेटा निकालने के लिए Nokogiri का उपयोग कर सकते हैं।
IRC लॉग URL के अंत में .txt जोड़कर सादे टेक्स्ट में उपलब्ध हैं इसलिए हम इसका लाभ उठाएंगे।
यह क्लास हमारे लिए डेटा डाउनलोड और सहेजेगी:
 require 'restclient'
class LogParser
  LOG_DIR = 'irc_logs'
  def initialize(date)
    @date = date
    @log_name = "#{LOG_DIR}/irc-log-#{@date}.txt"
  end
  def download_page(url)
    return log_contents if File.exist? @log_name
    RestClient.get(url).body
  end
  def save_page(page)
    File.open(@log_name, "w+") { |f| f.puts page }
  end
  def log_contents
    File.readlines(@log_name).join
  end
  def get_messages
    page = download_page("https://irclog.whitequark.org/ruby/#{@date}.txt")
    save_page(page)
    page
  end
end
log = LogParser.new("2015-04-15")
msg = log.get_messages
यह एक बहुत सीधी क्लास है।
हम RestClient को अपने HTTP क्लाइंट के रूप में उपयोग करते हैं और फिर परिणामों को एक फ़ाइल में सहेजते हैं ताकि हमें अपने प्रोग्राम में संशोधन करते समय उन्हें कई बार अनुरोध न करना पड़े।
डेटा का विश्लेषण
अब जब हमारे पास डेटा है तो हम इसका विश्लेषण कर सकते हैं।
यहां एक साधारण Ngram क्लास है।
इस क्लास में हम Array#each_cons मेथड का उपयोग करते हैं जो ngrams उत्पन्न करता है।
क्योंकि यह मेथड एक Enumerator लौटाता है हमें इस पर to_a कॉल करना होगा ताकि एक Array प्राप्त हो सके।
 class Ngram
  def initialize(input)
    @input = input
  end
  def ngrams(n)
    @input.split.each_cons(n).to_a
  end
end
फिर हम एक लूप, Hash#merge! और Enumerable#sort_by का उपयोग करके सब कुछ एक साथ रखते हैं।
इस तरह:
 # उन शब्दों को फ़िल्टर करें जो इससे कम बार दिखाई देते हैं
MIN_REPETITIONS = 20
total = {}
# महीने के पहले 15 दिनों के लॉग प्राप्त करें और ट्राइग्राम्स लौटाएं
(1..15).each do |n|
  day = '%02d' % [n]
  total.merge!(get_trigrams_for_date "2015-04-#{day}") { |k, old, new| old + new }
end
# अवरोही क्रम में सॉर्ट करें
total = total.sort_by { |k, v| -v }.reject { |k, v| v < MIN_REPETITIONS }
total.each { |k, v| puts "#{v} => #{k}" }
नोट: संक्षिप्तता के लिए
get_trigrams_for_dateमेथड यहां नहीं है, लेकिन आप इसे गिटहब पर पा सकते हैं।
आउटपुट ऐसा दिखता है:
 112 => i want to
83 => link for more
82 => is there a
71 => you want to
66 => i don't know
66 => i have a
65 => i need to
जैसा कि आप देख सकते हैं #ruby में चीजें करना बहुत लोकप्रिय है 🙂
निष्कर्ष
अब आपकी बारी है!
अपना एडिटर खोलें और कुछ n-gram विश्लेषण के साथ खेलना शुरू करें। n-grams को क्रिया में देखने का एक और तरीका Google Ngram Viewer है।
नेचुरल लैंग्वेज प्रोसेसिंग (NLP) एक आकर्षक विषय हो सकता है, विकिपीडिया में विषय का एक अच्छा अवलोकन है।
आप इस पोस्ट के लिए पूरा कोड यहां पा सकते हैं: https://github.com/matugm/ngram-analysis/blob/master/irc_histogram.rb