
मैंने हाल ही में एक लेख प्रकाशित किया जिसमें मैंने Ruby के अधिकांश स्ट्रिंग मेथड्स को कुछ यूनिकोड वर्णों के साथ टेस्ट किया ताकि यह देखा जा सके कि क्या वे अप्रत्याशित रूप से व्यवहार करेंगे। उनमें से कई ने किया।
एक आलोचना जो कुछ लोगों ने लेख की की थी, वह यह थी कि मैं टेस्टिंग के लिए अनॉर्मलाइज़्ड स्ट्रिंग्स का उपयोग कर रहा था। स्पष्ट रूप से, मैं यूनिकोड नॉर्मलाइज़ेशन पर थोड़ा अस्पष्ट था। मुझे संदेह है कि कई Rubyists हैं।
नॉर्मलाइज़ेशन का उपयोग करके, आप उन कई यूनिकोड स्ट्रिंग्स को ले सकते हैं जो मेरे टेस्ट्स में अप्रत्याशित रूप से व्यवहार करती थीं और उन्हें उन स्ट्रिंग्स में परिवर्तित कर सकते हैं जो Ruby के स्ट्रिंग मेथड्स के साथ अच्छा खेलते हैं। हालांकि:
- रूपांतरण हमेशा सही नहीं होता। कुछ यूनिकोड अनुक्रम हमेशा Ruby के स्ट्रिंग मेथड्स को गलत व्यवहार करने का कारण बनेंगे।
- यह कुछ ऐसा है जिसे आपको मैन्युअल रूप से करना होगा। न तो Ruby, न Rails और न ही DB डिफ़ॉल्ट रूप से स्वचालित रूप से नॉर्मलाइज़ करता है।
यह लेख Ruby में यूनिकोड नॉर्मलाइज़ेशन का एक संक्षिप्त परिचय होगा। उम्मीद है कि यह आपको अपनी खोज के लिए एक प्रारंभिक बिंदु देगा।
चलिए एक स्ट्रिंग को नॉर्मलाइज़ करते हैं
String#unicode_normalizeमेथड Ruby 2.2 में पेश किया गया था। Ruby में लिखे होने के कारण, यह utf8_proc और unicode जेम्स जैसे C का लाभ उठाने वाले नॉर्मलाइज़ेशन लाइब्रेरीज़ जितना तेज़ नहीं है।
हमें नॉर्मलाइज़ेशन की आवश्यकता इसलिए है क्योंकि यूनिकोड में एक वर्ण को लिखने के एक से अधिक तरीके हैं। अक्षर "Å" को कोड पॉइंट "\u00c5" के रूप में दर्शाया जा सकता है या अक्षर "A" और एक एक्सेंट की संरचना के रूप में: "A\u030A"।
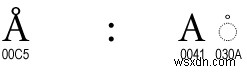
नॉर्मलाइज़ेशन एक रूप को दूसरे में परिवर्तित करता है:
"A\u030A".unicode_normalize #=> 'Å' (समान "\u00C5")
बेशक, यूनिकोड को नॉर्मलाइज़ करने का केवल एक तरीका नहीं है। यह बहुत सरल होता! यूनिकोड को नॉर्मलाइज़ करने के चार तरीके हैं, जिन्हें "नॉर्मलाइज़ेशन फॉर्म्स" कहा जाता है। उन्हें क्रिप्टिक एक्रोनिम्स का उपयोग करके नामित किया गया है: NFD, NFC, NFKD और NFKC।
String#unicode_normalize डिफ़ॉल्ट रूप से NFC का उपयोग करता है, लेकिन हम इसे दूसरे फॉर्म का उपयोग करने के लिए बता सकते हैं:
"a\u0300".unicode_normalize(:nfkc) #=> 'à' (समान "\u00E0")
लेकिन इसका वास्तव में क्या अर्थ है? चार नॉर्मलाइज़ेशन फॉर्म वास्तव में क्या करते हैं? आइए देखते हैं।
नॉर्मलाइज़ेशन फॉर्म्स
दो प्रकार के नॉर्मलाइज़ेशन ऑपरेशन हैं:
- कंपोजिशन: मल्टी-कोड-पॉइंट वर्णों को सिंगल कोड पॉइंट्स में परिवर्तित करता है। उदाहरण के लिए:
"a\u0300"बन जाता है"\u00E0", जो दोनों वर्णàको एन्कोड करने के तरीके हैं। - डीकंपोजिशन: कंपोजिशन के विपरीत। सिंगल-कोड-पॉइंट वर्णों को मल्टीपल कोड पॉइंट्स में परिवर्तित करता है। उदाहरण के लिए:
"\u00E0"बन जाता है"a\u0300"।
कंपोजिशन और डीकंपोजिशन प्रत्येक को दो तरीकों से किया जा सकता है:
- कैनोनिकल: ग्लिफ्स को संरक्षित करता है। उदाहरण के लिए:
"2⁵""2⁵"ही रहता है भले ही कुछ सिस्टम सुपरस्क्रिप्ट-फाइव वर्ण का समर्थन न करें। - कम्पैटिबिलिटी: ग्लिफ्स को उनके कम्पैटिबिलिटी वर्णों से बदल सकता है। उदाहरण के लिए:
"2⁵"को"2 5"में परिवर्तित किया जाएगा।
दो ऑपरेशन्स और दो विकल्पों को विभिन्न तरीकों से संयोजित करके चार "नॉर्मलाइज़ेशन फॉर्म्स" बनाए जाते हैं। मैंने उन सभी को नीचे दी गई तालिका में विवरण और इनपुट/आउटपुट के उदाहरणों के साथ सूचीबद्ध किया है:
| नाम | विवरण | इनपुट | आउटपुट |
|---|---|---|---|
| NFD | कैनोनिकल डीकंपोजिशन | Å "\u00c5" |
Å "A\u030A" |
| NFC | कैनोनिकल डीकंपोजिशन फॉलोड बाय कैनोनिकल कंपोजिशन | Å "A\u030A" |
Å "\u00c5" |
| NFKD | कम्पैटिबिलिटी डीकंपोजिशन | ẛ̣ "\u1e9b\u0323" |
ṩ "\u0073\u0323\u0307" |
| NFKC | कम्पैटिबिलिटी डीकंपोजिशन फॉलोड बाय कैनोनिकल कंपोजिशन | ẛ̣ "\u1e9b\u0323" |
ṩ "\u1e69" |
यदि आप इस तालिका को कुछ मिनटों के लिए देखते हैं तो आप ध्यान देना शुरू कर सकते हैं कि एक्रोनिम्स कुछ हद तक समझ में आते हैं:
- "NF" का अर्थ "नॉर्मलाइज़ेशन फॉर्म" है।
- "D" का अर्थ "डीकंपोजिशन" है
- "C" का अर्थ "कंपोजिशन" है
- "K" का अर्थ "कम्पैटिबिलिटी" है :)
अधिक उदाहरणों और अधिक गहन तकनीकी व्याख्या के लिए, Unicode Standard Annex #15 देखें।
नॉर्मलाइज़ेशन फॉर्म चुनना
आपको जिस नॉर्मलाइज़ेशन फॉर्म का उपयोग करना चाहिए वह हाथ में कार्य पर निर्भर करता है। नीचे दी गई मेरी सिफारिशें यूनिकोड नॉर्मलाइज़ेशन FAQ पर आधारित हैं।
स्ट्रिंग कम्पैटिबिलिटी के लिए NFC का उपयोग करें
यदि आपका लक्ष्य Ruby के स्ट्रिंग मेथड्स को अधिकांश यूनिकोड के साथ अच्छा खेलना है, तो आप सबसे अधिक संभावना NFC का उपयोग करना चाहेंगे। यही कारण है कि यह String#unicode_normalize के लिए डिफ़ॉल्ट है।
- यह मल्टी-कोड-पॉइंट वर्णों को जहां संभव हो सिंगल कोड पॉइंट्स में कंपोज करता है। मल्टी-कोड-पॉइंट वर्ण स्ट्रिंग मेथड्स के साथ अधिकांश समस्याओं का स्रोत हैं।
- यह ग्लिफ्स को नहीं बदलता, इसलिए आपके एंड-यूजर्स उनके द्वारा इनपुट किए गए टेक्स्ट में कोई बदलाव नहीं देखेंगे।
कहा जा रहा है, सभी मल्टी-कोड-पॉइंट वर्णों को सिंगल कोड पॉइंट में कंपोज नहीं किया जा सकता। उन मामलों में Ruby के String मेथड्स खराब व्यवहार करेंगे:
s = "\u01B5\u0327\u0308" # => "Ƶ̧̈", एक अन-कंपोजेबल वर्ण
s.unicode_normalize(:nfc).size # => 3, भले ही केवल एक वर्ण हो
सुरक्षा और DB कम्पैटिबिलिटी के लिए NFKC का उपयोग करें
यदि आप सुरक्षा-संबंधी टेक्स्ट जैसे यूज़रनेम के साथ काम कर रहे हैं, या मुख्य रूप से टेक्स्ट को अपने डेटाबेस के साथ अच्छा खेलने में रुचि रखते हैं, तो NFKC शायद एक अच्छा विकल्प है।
- यह संभावित समस्याग्रस्त वर्णों को उनके कम्पैटिबिलिटी वर्णों में परिवर्तित करता है।
- फिर यह सभी वर्णों को सिंगल कोड पॉइंट्स में कंपोज करता है।
यह देखने के लिए कि यह सुरक्षा के लिए क्यों उपयोगी है, कल्पना करें कि आपके पास "HenryIV" यूज़रनेम वाला एक यूज़र है। एक दुर्भावनापूर्ण एक्टर एक नया यूज़रनेम रजिस्टर करके इस यूज़र का प्रतिरूपण करने का प्रयास कर सकता है: "HenryⅣ"।
मुझे पता है, वे समान दिखते हैं। यही बात है। लेकिन वे वास्तव में दो अलग-अलग स्ट्रिंग्स हैं। पहला ASCII वर्णों "IV" का उपयोग करता है जबकि दूसरा रोमन अंक 4 के लिए यूनिकोड वर्ण का उपयोग करता है: "Ⅳ"।
आप स्ट्रिंग्स को यूनिकनेस मान्य करने से पहले NFKC का उपयोग करके नॉर्मलाइज़ करके इस तरह की चीज़ को रोक सकते हैं। इस मामले में, NFKC यूनिकोड "\u2163" को ASCII अक्षरों "IV" में परिवर्तित करता है।
a = "Henry\u2163"
b = "HenryIV"
a.unicode_normalize(:nfc) == b.unicode_normalize(:nfc) # => false, क्योंकि NFC ग्लिफ्स को संरक्षित करता है
a.unicode_normalize(:nfkc) == b.unicode_normalize(:nfkc) # => true, क्योंकि NFKC दोनों को ASCII "IV" में मूल्यांकन करता है
अंतिम शब्द
अब जब मैंने इसमें अधिक गहराई से देखा है, तो मुझे थोड़ा आश्चर्य होता है कि यूनिकोड नॉर्मलाइज़ेशन Ruby और Rails समुदायों में एक बड़ा विषय नहीं है। आप उम्मीद कर सकते हैं कि यह आपके लिए Rails द्वारा किया जाएगा, लेकिन जहां तक मैं बता सकता हूँ, ऐसा नहीं है। और अपने यूजर्स द्वारा दिए गए डेटा को नॉर्मलाइज़ न करने का मतलब है कि Ruby के कई स्ट्रिंग मेथड्स विश्वसनीय नहीं हैं।
यदि आप प्रिय पाठकों में से कोई कुछ जानता है जो मुझे नहीं पता, तो कृपया ट्विटर @StarrHorne या ईमेल starr@honeybadger.io के माध्यम से संपर्क करें। यूनिकोड एक बड़ा विषय है और मैंने पहले ही साबित कर दिया है कि मैं इसके बारे में सब कुछ नहीं जानता। :)


