GitHub पर पूर्ण स्रोत
Stoffle प्रोग्रामिंग भाषा का एक पूर्ण कार्यान्वयन GitHub पर उपलब्ध है। इस रेफरेंस कार्यान्वयन में कोड पढ़ने को आसान बनाने के लिए बहुत सारे कमेंट्स हैं। यदि आपको बग मिलते हैं या आपके कोई प्रश्न हैं तो बेझिझक एक इश्यू खोलें।
इस ब्लॉग पोस्ट में, हम Stoffle के लिए पार्सर को लागू करने जा रहे हैं, एक खिलौना प्रोग्रामिंग भाषा जिसे पूरी तरह से Ruby में बनाया गया है। आप इस प्रोजेक्ट के बारे में इस श्रृंखला के पहले भाग में अधिक पढ़ सकते हैं।
स्क्रैच से एक पार्सर बनाने से मुझे कुछ अप्रत्याशित अंतर्दृष्टि और ज्ञान मिला। मुझे लगता है कि यह अनुभव व्यक्ति से व्यक्ति में भिन्न हो सकता है, लेकिन मुझे लगता है कि यह मान लेना सुरक्षित है कि इस लेख के बाद, आपने निम्नलिखित में से कम से कम एक का ज्ञान अर्जित या गहरा किया होगा:
- आप स्रोत कोड को अलग तरह से देखना शुरू कर देंगे और इसकी निर्विवाद ट्री-जैसी संरचना को बहुत आसानी से नोटिस करेंगे;
- आपको सिंटैक्टिक शुगर की गहरी समझ होगी और आप इसे हर जगह देखना शुरू कर देंगे, चाहे वह Stoffle, Ruby, या अन्य प्रोग्रामिंग भाषाओं में हो।
मुझे लगता है कि एक पार्सर पेरेटो सिद्धांत का एक आदर्श उदाहरण है। कुछ अतिरिक्त-अच्छी सुविधाओं को बनाने के लिए आवश्यक कार्य की मात्रा, जैसे शानदार त्रुटि संदेश, स्पष्ट रूप से बुनियादी चीजों को चालू करने के लिए आवश्यक प्रयास से अधिक और असमानुपाती है। हम आवश्यक चीजों पर ध्यान केंद्रित करेंगे और सुधारों को एक चुनौती के रूप में छोड़ देंगे, मेरे प्रिय पाठक। हम इस श्रृंखला के बाद के लेख में कुछ अधिक दिलचस्प एक्स्ट्रा को संभाल सकते हैं या नहीं।
सिंटैक्टिक शुगर
सिंटैक्टिक शुगर उन कंस्ट्रक्ट्स को दर्शाने के लिए इस्तेमाल किया जाने वाला एक अभिव्यक्ति है जो एक भाषा को उपयोग में आसान बनाते हैं, लेकिन जिनके हटाने से प्रोग्रामिंग भाषा को कार्यक्षमता नहीं खोनी पड़ेगी। एक अच्छा उदाहरण Ruby का
elsifकंस्ट्रक्ट है। Stoffle में, हमारे पास ऐसी संरचना नहीं है, इसलिए उसी को व्यक्त करने के लिए हमें अधिक वर्बोज होने के लिए मजबूर किया जाता है:if some_condition # ... else # oops, no elsif available if another_condition # ... end end
पार्सर क्या है?
हम स्रोत कोड के साथ शुरू करते हैं, वर्णों का एक कच्चा अनुक्रम। फिर, जैसा कि इस श्रृंखला के पिछले लेख में दिखाया गया है, लेक्सर इन वर्णों को टोकन्स नामक समझदार डेटा स्ट्रक्चर्स में समूहित करता है। हालांकि, हम अभी भी ऐसे डेटा के साथ रह गए हैं जो पूरी तरह से फ्लैट हैं, कुछ ऐसा जो अभी भी स्रोत कोड की नेस्टेड प्रकृति को उचित रूप से प्रतिबिंबित नहीं करता है। इस प्रकार, पार्सर का काम इस वर्ण अनुक्रम से एक ट्री बनाना है। जब यह अपना कार्य पूरा कर लेता है, तो हम डेटा के साथ समाप्त होंगे जो अंततः यह व्यक्त करने में सक्षम हैं कि हमारे प्रोग्राम का प्रत्येक भाग एक-दूसरे से कैसे नेस्ट और संबंधित है।
पार्सर द्वारा बनाया गया ट्री, आमतौर पर, एक एब्सट्रैक्ट सिंटैक्स ट्री (AST) कहलाता है। जैसा कि नाम से पता चलता है, हम एक ट्री डेटा स्ट्रक्चर के साथ काम कर रहे हैं, जिसकी जड़ प्रोग्राम को स्वयं दर्शाती है और इस प्रोग्राम नोड के बच्चे वे कई एक्सप्रेशन्स हैं जो हमारे प्रोग्राम को बनाते हैं। AST में एब्सट्रैक्ट शब्द हमारी पिछले चरणों में स्पष्ट रूप से मौजूद भागों को एब्स्ट्रैक्ट अवे करने की क्षमता को संदर्भित करता है। एक अच्छा उदाहरण एक्सप्रेशन टर्मिनेटर्स (Stoffle के मामले में नई लाइनें) हैं; वे AST बनाते समय माने जाते हैं, लेकिन हमें टर्मिनेटर को दर्शाने के लिए एक विशिष्ट नोड प्रकार की आवश्यकता नहीं है। हालांकि, याद रखें, हमारे पास एक टर्मिनेटर को दर्शाने के लिए एक स्पष्ट टोकन था।
क्या एक उदाहरण AST का विज़ुअलाइज़ेशन उपयोगी नहीं होगा? आपकी इच्छा एक आदेश है! नीचे एक साधारण Stoffle प्रोग्राम है, जिसे हम इस पोस्ट में बाद में चरण-दर-चरण पार्स करेंगे, और इसका संबंधित एब्सट्रैक्ट सिंटैक्स ट्री:
fn double: num
  num * 2
end 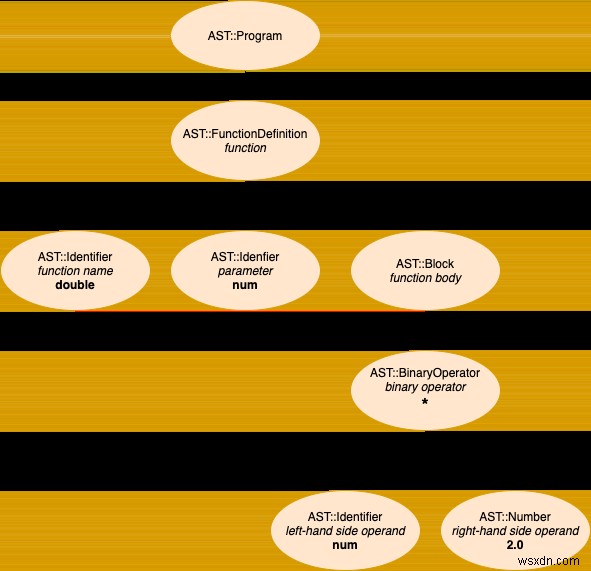
स्रोत से AST, एक पहला उदाहरण
इस पोस्ट के इस खंड में, हम चरण-दर-चरण पता लगाने जा रहे हैं कि हमारा पार्सर Stoffle के एक बहुत सरल प्रोग्राम को कैसे संभालता है, जो एक सिंगल लाइन से बना है जिसमें एक वेरिएबल बाइंडिंग व्यक्त की गई है (यानी, हम एक वेरिएबल को एक मान निर्दिष्ट करते हैं)। यहां स्रोत है, लेक्सर द्वारा उत्पादित टोकन्स का एक सरलीकृत प्रतिनिधित्व (ये टोकन्स हमारे पार्सर को फीड किए गए इनपुट हैं) और, अंत में, उस AST का एक विज़ुअल प्रतिनिधित्व जिसे हम प्रोग्राम को दर्शाने के लिए बनाने जा रहे हैं:
स्रोत
my_var = 1 टोकन्स (लेक्सर का आउटपुट, पार्सर के लिए इनपुट)
[:identifier, :'=', :number] पार्सर के आउटपुट का विज़ुअल प्रतिनिधित्व (एक एब्सट्रैक्ट सिंटैक्स ट्री)
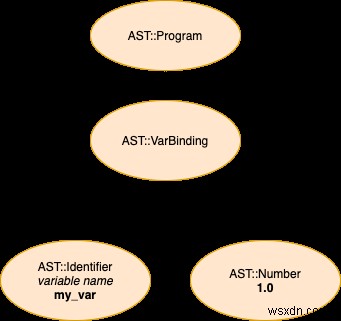
जैसा कि आप कल्पना कर सकते हैं, हमारे पार्सर का कोर हमारे लेक्सर के कोर के बहुत समान है। लेक्सर के मामले में, हमारे पास प्रोसेस करने के लिए वर्णों का एक समूह था। अब, हमें अभी भी एक संग्रह पर पुनरावृति करनी है, लेकिन पार्सर के मामले में, हम अपने लेक्सर मित्र द्वारा उत्पादित टोकन्स की सूची पर जाएंगे। हमारे पास संग्रह में हमारी स्थिति को ट्रैक करने के लिए एक सिंगल पॉइंटर (@next_p) है। यह पॉइंटर प्रोसेस किए जाने वाले अगले टोकन को चिह्नित करता है। यद्यपि हमारे पास केवल यह सिंगल पॉइंटर है, हमारे पास कई अन्य "वर्चुअल" पॉइंटर्स हैं जिनका हम आवश्यकतानुसार उपयोग कर सकते हैं; वे हमारे कार्यान्वयन के साथ आगे बढ़ने पर दिखाई देंगे। ऐसा ही एक "वर्चुअल" पॉइंटर current है (मूल रूप से, @next_p - 1 पर टोकन)।
#parse वह मेथड है जिसे टोकन्स को AST में बदलने के लिए कॉल किया जाता है, जो @ast इंस्टेंस वेरिएबल पर उपलब्ध होगा। #parse का कार्यान्वयन सीधा है। हम #consume को कॉल करके और @next_p को मूव करके संग्रह के माध्यम से आगे बढ़ते रहते हैं जब तक कि प्रोसेस करने के लिए कोई और टोकन्स नहीं हैं (यानी, जबकि next_p < tokens.length)। #parse_expr_recursively एक AST नोड या कुछ भी नहीं लौटा सकता है; याद रखें, हमें टर्मिनेटर्स को AST में प्रतिबिंबित करने की आवश्यकता नहीं है, उदाहरण के लिए। यदि वर्तमान लूप के पुनरावृति में एक नोड बनाया गया था, तो हम जारी रखने से पहले इसे @ast में जोड़ते हैं। यह ध्यान रखना महत्वपूर्ण है कि #parse_expr_recursively भी @next_p को मूव कर रहा है क्योंकि, जब हमें एक टोकन मिलता है जो एक विशिष्ट कंस्ट्रक्ट की शुरुआत को चिह्नित करता है, तो हमें कई बार आगे बढ़ना होगा जब तक कि हम अंततः एक नोड का निर्माण नहीं कर लेते जो वर्तमान में हम जो पार्स कर रहे हैं उसे पूरी तरह से दर्शाता है। कल्पना करें कि एक if को दर्शाने वाले नोड को बनाने के लिए हमें कितने टोकन्स का उपभोग करना होगा।
module Stoffle
  class Parser
    attr_accessor :tokens, :ast, :errors
    # ...
    def initialize(tokens)
      @tokens = tokens
      @ast = AST::Program.new
      @next_p = 0
      @errors = []
    end

    def parse
      while pending_tokens?
        consume
        node = parse_expr_recursively
        ast << node if node != nil
      end
    end
    # ...
  end
end
ऊपर दिए गए स्निपेट में, पहली बार, हमें हमारे पार्सर कार्यान्वयन का हिस्सा होने वाले कई AST नोड प्रकारों में से एक के साथ प्रस्तुत किया गया था। नीचे, हमारे पास AST::Program नोड प्रकार के लिए पूर्ण स्रोत कोड है। जैसा कि आप अनुमान लगा रहे होंगे, यह हमारे ट्री की जड़ है, जो पूरे प्रोग्राम को दर्शाता है। आइए इसके सबसे दिलचस्प बिट्स पर करीब से नज़र डालें:
- एक Stoffle प्रोग्राम
@expressionsसे बना है; येAST::Programनोड के#childrenहैं; - जैसा कि आप फिर से देखेंगे, हर नोड प्रकार
#==मेथड को लागू करता है। परिणामस्वरूप, दो सरल नोड्स की तुलना करना, साथ ही पूरे प्रोग्राम को पूरी तरह से तुलना करना आसान है! दो प्रोग्राम्स (या दो जटिल नोड्स) की तुलना करते समय, उनकी समानता हर बच्चे की समानता, हर बच्चे के हर बच्चे की समानता, और इसी तरह से निर्धारित होगी।#==द्वारा उपयोग की जाने वाली यह सरल लेकिन शक्तिशाली रणनीति हमारे कार्यान्वयन के टेस्टिंग के लिए बेहद उपयोगी है।
class Stoffle::AST::Program
  attr_accessor :expressions
  def initialize
    @expressions = []
  end
  def <<(expr)
    expressions << expr
  end
  def ==(other)
    expressions == other&.expressions
  end
  def children
    expressions
  end
end
एक्सप्रेशन्स बनाम स्टेटमेंट्स
कुछ भाषाओं में, कई कंस्ट्रक्ट्स कोई मान उत्पन्न नहीं करते; एक कंडीशनल एक क्लासिक उदाहरण है। इन्हें स्टेटमेंट्स कहा जाता है। अन्य कंस्ट्रक्ट्स, हालांकि, एक मान का मूल्यांकन करते हैं (उदाहरण के लिए, एक फंक्शन कॉल)। इन्हें एक्सप्रेशन्स कहा जाता है। अन्य भाषाओं में, हालांकि, सब कुछ एक एक्सप्रेशन है और एक मान उत्पन्न करता है। Ruby इसका एक उदाहरण है। उदाहरण के लिए, IRB में निम्न स्निपेट टाइप करके यह पता लगाने का प्रयास करें कि एक मेथड परिभाषा किस मूल्य का मूल्यांकन करती है:
irb(main):001:0> def two; 2; endयदि आप IRB चालू करने का मन नहीं कर रहे हैं, तो मुझे आपको खबर बताने दें; Ruby में, एक मेथड परिभाषा एक्सप्रेशन एक सिम्बल (मेथड नाम) का मूल्यांकन करती है। जैसा कि आप जानते हैं, Stoffle Ruby से बहुत प्रेरित है, इसलिए हमारी छोटी खिलौना भाषा में, सब कुछ एक एक्सप्रेशन भी है।
ध्यान रखें कि ये परिभाषाएं व्यावहारिक उद्देश्यों के लिए पर्याप्त हैं, लेकिन वास्तव में कोई आम सहमति नहीं है, और आप स्टेटमेंट और एक्सप्रेशन शब्दों को अन्यत्र अलग तरह से परिभाषित देख सकते हैं।
गहराई में जाना: #parse_expr_recursively का कार्यान्वयन शुरू करना
जैसा कि हमने ऊपर दिए गए स्निपेट में देखा, #parse_expr_recursively वह मेथड है जिसे संभावित रूप से एक नया AST नोड बनाने के लिए कॉल किया जाता है। #parse_expr_recursively पार्सिंग प्रक्रिया में कई अन्य छोटे मेथड्स का उपयोग करता है, लेकिन हम शांति से कह सकते हैं कि यह हमारे पार्सर का असली इंजन है। यद्यपि यह बहुत लंबा नहीं है, यह मेथड पचाने में अधिक कठिन है। इसलिए, हम इसे दो भागों में काटने जा रहे हैं। इस पोस्ट के इस खंड में, आइए इसके प्रारंभिक खंड से शुरू करें, जो पहले से ही Stoffle प्रोग्रामिंग भाषा के कुछ सरल भागों को पार्स करने के लिए पर्याप्त शक्तिशाली है। एक रिफ्रेशर के रूप में, याद रखें कि हम एक साधारण प्रोग्राम को पार्स करने के लिए आवश्यक चरणों से गुजर रहे हैं जिसमें एक सिंगल वेरिएबल बाइंडिंग एक्सप्रेशन होता है:
स्रोत
my_var = 1 टोकन्स (लेक्सर का आउटपुट, पार्सर के लिए इनपुट)
[:identifier, :'=', :number] उन टोकन्स को देखकर जिन्हें हमें संभालना है और अन्य, समान सरल एक्सप्रेशन्स के लिए लेक्सर आउटपुट की कल्पना करके, टोकन प्रकारों को विशिष्ट पार्सिंग मेथड्स के साथ जोड़ने का प्रयास करना एक अच्छा विचार लगता है:
def parse_expr_recursively
  parsing_function = determine_parsing_function
  if parsing_function.nil?
    unrecognized_token_error
    return
  end
  send(parsing_function)
end
#parse_expr_recursively के इस प्रारंभिक कार्यान्वयन में, हम वास्तव में यही करते हैं। चूंकि काफी सारे अलग-अलग टोकन प्रकार होंगे जिन्हें हमें संभालना होगा, इसलिए इस निर्णय लेने की प्रक्रिया को एक अलग मेथड - #determine_parsing_function में निकालना बेहतर है, जिसे हम एक पल में देखेंगे।
जब हम समाप्त कर लेंगे, तो ऐसा कोई टोकन नहीं होना चाहिए जिसे हम पहचान न सकें, लेकिन सुरक्षा के रूप में, हम जांचेंगे कि क्या वर्तमान टोकन के साथ एक पार्सिंग फंक्शन जुड़ा हुआ है। यदि नहीं, तो हम अपने इंस्टेंस वेरिएबल @errors में एक त्रुटि जोड़ देंगे, जिसमें पार्सिंग के दौरान हुई सभी समस्याएं होती हैं। हम यहां इसका विस्तार से कवर नहीं करेंगे, लेकिन यदि आप उत्सुक हैं तो आप GitHub पर पार्सर का पूर्ण कार्यान्वयन देख सकते हैं।
#determine_parsing_function कॉल किए जाने वाले पार्सिंग मेथड के नाम को दर्शाने वाला एक सिम्बल लौटाता है। हम उपयुक्त मेथड को ऑन-द-फ्लाई कॉल करने के लिए Ruby के send का उपयोग करेंगे।
पार्सिंग मेथड निर्धारित करना और वेरिएबल बाइंडिंग पार्स करना
आइए #determine_parsing_function पर एक नज़र डालें ताकि हम Stoffle के विभिन्न कंस्ट्रक्ट्स को पार्स करने के लिए विशिष्ट मेथड्स को कॉल करने के लिए इस प्रारंभिक तंत्र को समझ सकें। #determine_parsing_function हर चीज के लिए उपयोग किया जाएगा (उदाहरण के लिए, कीवर्ड्स और यूनरी ऑपरेटर्स) बाइनरी ऑपरेटर्स को छोड़कर। हम बाद में बाइनरी ऑपरेटर्स के मामले में उपयोग की जाने वाली तकनीक का पता लगाएंगे। अभी के लिए, आइए #determine_parsing_function देखें:
def determine_parsing_function
  if [:return, :identifier, :number, :string, :true, :false, :nil, :fn, :if, :while].include?(current.type)
    "parse_#{current.type}".to_sym
  elsif current.type == :'('
    :parse_grouped_expr
  elsif [:"\n", :eof].include?(current.type)
    :parse_terminator
  elsif UNARY_OPERATORS.include?(current.type)
    :parse_unary_operator
  end
end
जैसा कि पहले बताया गया है, #current वर्तमान में प्रोसेस किए जा रहे टोकन का एक वर्चुअल पॉइंटर है। #determine_parsing_function का कार्यान्वयन बहुत सीधा है; हम वर्तमान टोकन (विशेष रूप से, इसके प्रकार) को देखते हैं और कॉल किए जाने वाले उपयुक्त मेथड को दर्शाने वाला एक सिम्बल लौटाते हैं।
याद रखें कि हम एक वेरिएबल बाइंडिंग (my_var = 1) को पार्स करने के लिए आवश्यक चरणों से गुजर रहे हैं, इसलिए हम जिन टोकन प्रकारों को संभाल रहे हैं वे [:identifier, :'=', :number] हैं। वर्तमान टोकन प्रकार :identifier है, इसलिए #determine_parsing_function :parse_identifier लौटाएगा, जैसा कि आप अनुमान लगा रहे होंगे। आइए हमारे अगले चरण, #parse_identifier मेथड पर एक नज़र डालें:
def parse_identifier
  lookahead.type == :'=' ? parse_var_binding : AST::Identifier.new(current.lexeme)
end
यहां, हमारे पास मूल रूप से वही है जो अन्य सभी पार्स मेथड्स करते हैं, उसकी एक बहुत सरल अभिव्यक्ति है। #parse_identifier में - और अन्य पार्स मेथड्स में - हम टोकन्स की जांच करते हैं ताकि यह निर्धारित किया जा सके कि हम जिस संरचना की अपेक्षा कर रहे हैं वह वास्तव में मौजूद है। हम जानते हैं कि हमारे पास एक आइडेंटिफायर है, लेकिन हमें यह निर्धारित करने के लिए अगले टोकन को देखना होगा कि क्या हम एक वेरिएबल बाइंडिंग के साथ काम कर रहे हैं, जो अगले टोकन प्रकार :'=' होने पर होगा, या यदि हमारे पास सिर्फ एक आइडेंटिफायर है या अधिक जटिल एक्सप्रेशन में भाग ले रहा है। उदाहरण के लिए, एक अंकगणितीय एक्सप्रेशन कल्पना करें जिसमें हम वेरिएबल्स में संग्रहीत मानों को मैनिपुलेट कर रहे हैं।
चूंकि हमारे पास अगला :'=' है, #parse_var_binding को कॉल किया जाएगा:
def parse_var_binding
  identifier = AST::Identifier.new(current.lexeme)
  consume(2)
  AST::VarBinding.new(identifier, parse_expr_recursively)
end
यहां, हम वर्तमान में प्रोसेस किए जा रहे आइडेंटिफायर को दर्शाने के लिए एक नया AST नोड बनाकर शुरू करते हैं। AST::Identifier के लिए कंस्ट्रक्टर आइडेंटिफायर टोकन के लेक्सेम (यानी वर्णों का अनुक्रम, स्ट्रिंग "my_var" हमारे मामले में) की अपेक्षा करता है, इसलिए हम इसे आपूर्ति करते हैं। फिर हम प्रोसेस किए जा रहे टोकन्स की स्ट्रीम में दो स्पॉट आगे बढ़ते हैं, जिससे :number प्रकार का टोकन विश्लेषण किया जाने वाला अगला टोकन बन जाता है। याद रखें कि हम [:identifier, :'=', :number] के साथ काम कर रहे हैं।
अंत में, हम वेरिएबल बाइंडिंग को दर्शाने वाला एक AST नोड बनाते हैं और लौटाते हैं। AST::VarBinding के लिए कंस्ट्रक्टर दो पैरामीटर्स की अपेक्षा करता है: एक आइडेंटिफायर AST नोड (बाइंडिंग एक्सप्रेशन का बायां पक्ष) और कोई भी वैध एक्सप्रेशन (दायां पक्ष)। यहां एक महत्वपूर्ण बात ध्यान देने योग्य है; वेरिएबल बाइंडिंग एक्सप्रेशन के दाहिने पक्ष को उत्पन्न करने के लिए, हम #parse_expr_recursively को फिर से कॉल करते हैं। यह पहली बार में थोड़ा अजीब लग सकता है, लेकिन ध्यान रखें कि एक वेरिएबल को केवल एक साधारण नंबर ही नहीं, बल्कि बहुत जटिल एक्सप्रेशन से बांधा जा सकता है, जैसा कि हमारे उदाहरण में है। यदि हम अपनी पार्सिंग रणनीति को एक शब्द में परिभाषित करें, तो यह रीकर्सिव होगी। अब, मुझे लगता है कि आप समझने लगे हैं कि #parse_expr_recursively का नाम ऐसा क्यों है।
इस खंड को समाप्त करने से पहले, हमें AST::Identifier और AST::VarBinding दोनों को जल्दी से एक्सप्लोर करना चाहिए। पहले, AST::Identifier:
class Stoffle::AST::Identifier < Stoffle::AST::Expression
  attr_accessor :name
  def initialize(name)
    @name = name
  end
  def ==(other)
    name == other&.name
  end
  def children
    []
  end
end
यहां कुछ फैंसी नहीं है। यह उल्लेखनीय है कि नोड वेरिएबल का नाम संग्रहीत करता है और इसके बच्चे नहीं हैं।
अब, AST::VarBinding:
class Stoffle::AST::VarBinding < Stoffle::AST::Expression
  attr_accessor :left, :right
  def initialize(left, right)
    @left = left
    @right = right
  end
  def ==(other)
    children == other&.children
  end
  def children
    [left, right]
  end
end
बायां पक्ष एक AST::Identifier नोड है। दायां पक्ष लगभग हर संभव प्रकार का नोड है - हमारे उदाहरण में एक साधारण नंबर से लेकर कुछ अधिक जटिल तक - उस एक्सप्रेशन को दर्शाता है जिससे आइडेंटिफायर बंधा हुआ है। एक वेरिएबल बाइंडिंग के #children वे AST नोड्स हैं जो यह @left और @right में रखता है।
स्रोत से AST, एक दूसरा उदाहरण
#parse_expr_recursively का वर्तमान अवतार पहले से ही कुछ सरल एक्सप्रेशन्स को पार्स करने में सक्षम है, जैसा कि हमने पिछले खंड में देखा। इस खंड में, हम इसके कार्यान्वयन को पूरा करेंगे ताकि यह बाइनरी और लॉजिकल ऑपरेटर्स जैसे अधिक जटिल एंटिटीज को भी पार्स कर सके। यहां, हम चरण-दर-चरण पता लगाएंगे कि हमारा पार्सर एक फंक्शन को परिभाषित करने वाले प्रोग्राम को कैसे संभालता है। यहां स्रोत है, लेक्सर द्वारा उत्पादित टोकन्स का एक सरलीकृत प्रतिनिधित्व और, जैसा कि हमने पहले खंड में किया था, उस AST का एक विज़ुअल प्रतिनिधित्व जिसे हम प्रोग्राम को दर्शाने के लिए बनाएंगे:
स्रोत
fn double: num
  num * 2
end
टोकन्स (लेक्सर का आउटपुट, पार्सर के लिए इनपुट)
[:fn, :identifier, :":", :identifier, :"\n", :identifier, :*, :number, :"\n", :end, :"\n", :eof] पार्सर आउटपुट का विज़ुअल प्रतिनिधित्व (एक एब्सट्रैक्ट सिंटैक्स ट्री)
आगे बढ़ने से पहले, आइए एक कदम पीछे हटें और ऑपरेटर प्रीसिडेंस नियमों के बारे में बात करें। ये गणितीय कन्वेंशन्स पर आधारित हैं; गणित में, वे सिर्फ कन्वेंशन्स हैं, और वास्तव में, ऐसा कुछ भी मौलिक नहीं है जो उस ऑपरेटर प्रीसिडेंस का परिणाम देता है जिसका हम उपयोग करते हैं। ये नियम हमें एक एक्सप्रेशन के मूल्यांकन के लिए सही क्रम निर्धारित करने की अनुमति देते हैं और, हमारे मामले में, इसे पहले पार्स करने के लिए। प्रत्येक ऑपरेटर की प्रीसिडेंस को परिभाषित करने के लिए, हमारे पास बस टोकन प्रकारों और इंटीजर्स का एक मैप (यानी, एक Hash) है। उच्च संख्याओं का मतलब है कि एक ऑपरेटर को पहले संभाला जाना चाहिए:
# हम Stoffle::Parser के शीर्ष पर इन प्रीसिडेंस नियमों को परिभाषित करते हैं।
module Stoffle
  class Parser
    # ...
    UNARY_OPERATORS = [:'!', :'-'].freeze
    BINARY_OPERATORS = [:'+', :'-', :'*', :'/', :'==', :'!=', :'>', :'<', :'>=', :'<='].freeze
    LOGICAL_OPERATORS = [:or, :and].freeze
    LOWEST_PRECEDENCE = 0
    PREFIX_PRECEDENCE = 7
    OPERATOR_PRECEDENCE = {
      or: 1,
      and: 2,
      '==': 3,
      '!=': 3,
      '>': 4,
      '<': 4,
      '>=': 4,
      '<=': 4,
      '+': 5,
      '-': 5,
      '*': 6,
      '/': 6,
      '(': 8
    }.freeze
    # ...
  end
end
#parse_expr_recursively में उपयोग की जाने वाली तकनीक कंप्यूटर साइंटिस्ट वॉन प्रैट द्वारा अपने 1973 के पेपर, "टॉप डाउन ऑपरेटर प्रीसिडेंस" में प्रस्तुत प्रसिद्ध पार्सर एल्गोरिदम पर आधारित है। जैसा कि आप देखेंगे, एल्गोरिदम बहुत सरल है, लेकिन पूरी तरह से समझना थोड़ा मुश्किल है। कोई कह सकता है कि यह थोड़ा जादुई लगता है। इस तकनीक की कार्यप्रणाली की सहज समझ हासिल करने की कोशिश करने के लिए हम इस पोस्ट में क्या करेंगे, वह है ऊपर उल्लिखित Stoffle स्निपेट को पार्स करते समय क्या होता है, चरण-दर-चरण जाना। तो, बिना किसी देरी के, यहां #parse_expr_recursively का पूरा संस्करण है:
def parse_expr_recursively(precedence = LOWEST_PRECEDENCE)
  parsing_function = determine_parsing_function
  if parsing_function.nil?
    unrecognized_token_error
    return
  end
  expr = send(parsing_function)
  return if expr.nil?
  # जब expr nil होता है, तो इसका मतलब है कि हम \n या eof पर पहुंच गए हैं।
  # ध्यान दें कि, यहां, हम अगले टोकन की जांच कर रहे हैं।
  while nxt_not_terminator? && precedence < nxt_precedence
    infix_parsing_function = determine_infix_function(nxt)
    return expr if infix_parsing_function.nil?
    consume
    expr = send(infix_parsing_function, expr)
  end
  expr
end
#parse_expr_recursively अब एक पैरामीटर, precedence स्वीकार करता है। यह एक दिए गए मेथड कॉल में माने जाने वाले प्रीसिडेंस "लेवल" को दर्शाता है। साथ ही, मेथड का पहला भाग बहुत हद तक समान है। फिर - अगर हम इस पहले भाग में एक एक्सप्रेशन बनाने में सक्षम थे - मेथड का उपन्यास भाग आता है। जबकि अगला टोकन टर्मिनेटर नहीं है (यानी, एक लाइन ब्रेक या फाइल का अंत) और प्रीसिडेंस (precedence पैरामीटर) अगले टोकन की प्रीसिडेंस से कम है, हम संभावित रूप से टोकन स्ट्रीम का उपभोग करना जारी रखते हैं।
while के अंदर देखने से पहले, आइए इसकी दूसरी स्थिति (precedence < nxt_precedence) के अर्थ के बारे में थोड़ा सोचें। यदि अगले टोकन की प्रीसिडेंस अधिक है, तो हमने अभी जो एक्सप्रेशन बनाया है (लोकल वेरिएबल expr) शायद एक नोड का बच्चा है जिसे अभी बनाया जाना बाकी है (याद रखें कि हम एक AST, एक एब्सट्रैक्ट सिंटैक्स ट्री बना रहे हैं)। हमारे Stoffle स्निपेट के पार्सिंग के माध्यम से जाने से पहले, आइए एक साधारण अंकगणितीय एक्सप्रेशन के पार्सिंग पर विचार करें: 2 + 2। इस एक्सप्रेशन को पार्स करते समय, हमारे मेथड का पहला भाग पहला 2 दर्शाने वाला एक AST::Number नोड बनाएगा और इसे expr में स्टोर करेगा। फिर, हम while में कदम रखेंगे क्योंकि अगले टोकन (:'+') की प्रीसिडेंस डिफ़ॉल्ट प्रीसिडेंस से अधिक होगी। तब हमें योग को संभालने के लिए पार्सिंग मेथड कॉल किया जाएगा, जिसमें AST::Number नोड पास किया जाएगा और एक बाइनरी ऑपरेटर को दर्शाने वाला नोड (AST::BinaryOperator) वापस प्राप्त होगा। अंत में, हम expr में संग्रहीत मान को 2 + 2 में पहले 2 को दर्शाने वाले नोड से, प्लस ऑपरेटर को दर्शाने वाले इस नए नोड के साथ ओवरराइट करेंगे। ध्यान दें कि अंत में, इस एल्गोरिदम ने हमें नोड्स को पुनर्व्यवस्थित करने की अनुमति दी; हमने AST::Number नोड बनाने से शुरू किया और अंत में यह हमारे ट्री में एक गहरा नोड बन गया, AST::BinaryOperator नोड के बच्चों में से एक के रूप में।
फंक्शन परिभाषा को चरण-दर-चरण पार्स करना
अब जब हम #parse_expr_recursively के समग्र व्याख्या से गुजर चुके हैं, तो आइए हमारी सरल फंक्शन परिभाषा पर वापस आते हैं:
fn double: num
  num * 2
end
यहां तक कि पार्सर निष्पादन के सरलीकृत विवरण को देखने का विचार भी थकाऊ लग सकता है (और, वास्तव में, शायद यह है!), लेकिन मुझे लगता है कि #parse_expr_recursively और विशिष्ट बिट्स (फंक्शन परिभाषा और प्रोडक्ट ऑपरेटर) के पार्सिंग दोनों को बेहतर ढंग से समझने के लिए यह बहुत मूल्यवान है। पहली चीजें पहले, यहां वे टोकन प्रकार हैं जिनसे हम निपटेंगे (नीचे @tokens.map(&:type) के लिए आउटपुट है, पार्सर के अंदर लेक्सर द्वारा स्निपेट को टोकनाइज़ करने के बाद जिसे हमने अभी देखा):
[:fn, :identifier, :":", :identifier, :"\n", :identifier, :*, :number, :"\n", :end, :"\n", :eof] नीचे दी गई तालिका दिखाती है कि ऊपर दिए गए टोकन्स को पार्स करते समय सबसे महत्वपूर्ण मेथड्स किस क्रम में कॉल किए जाते हैं। ध्यान रखें कि यह एक सरलीकरण है, और यदि आप वास्तव में पार्सर निष्पादन के सभी सटीक चरणों को समझना चाहते हैं, तो मैं Ruby डिबगर, जैसे Byebug, का उपयोग करने और प्रोग्राम निष्पादित होते ही लाइन-दर-लाइन आगे बढ़ने के लिए Byebug के step कमांड का उपयोग करने की सलाह देता हूं।
माइक्रोस्कोप के तहत हमारा पार्सर
एक टेस्ट है जो इस सटीक स्निपेट का उपयोग करता है जिसे हम एक्सप्लोर कर रहे हैं, जो Stoffle के स्रोत में उपलब्ध है। आप इसे spec/lib/stoffle/parser_spec.rb के अंदर पा सकते हैं; यह वह टेस्ट है जो
complex_program_ok_2.sfeनामक स्निपेट का उपयोग करता है।पार्सर निष्पादन को चरण-दर-चरण एक्सप्लोर करने के लिए, आप स्रोत को संपादित कर सकते हैं और
Parser#parseकी शुरुआत मेंbyebugकॉल जोड़ सकते हैं, केवल RSpec के साथ उल्लिखित टेस्ट चलाएं, और फिर प्रोग्राम को एक बार में एक लाइन आगे बढ़ाने के लिए Byebug केstepकमांड का उपयोग करें।Byebug कैसे काम करता है और GitHub पर प्रोजेक्ट के README फाइल पर जाकर सभी उपलब्ध कमांड्स के बारे में अधिक जानकारी देखें।
| कॉल किया गया मेथड | वर्तमान टोकन | अगला टोकन | उल्लेखनीय वेरिएबल्स / कॉल परिणाम | ओब्स |
|---|---|---|---|---|
| parse | nil | :fn | ||
| parse_expr_recursively | :fn | :identifier | precedence = 0, parsing_function = :parse_fn | |
| parse_function_definition | :fn | :identifier | parse_fn, parse_function_definition का एक उपनाम है | |
| parse_function_params | :identifier | :": | ||
| parse_block | :"\n" | :identifier | ||
| parse_expr_recursively | :identifier | :* | precedence = 0, parsing_function = :parse_identifier, nxt_precedence() returns 6, infix_parsing_function = :parse_binary_operator | |
| parse_identifier | :identifier | :* | ||
| parse_binary_operator | :* | :number | op_precedence = 6 | |
| parse_expr_recursively | :number | : "\n" | precedence = 6, parsing_function = :parse_number, nxt_precedence() returns 0 | |
| parse_number | :number | : "\n" |
अब जब हमारे पास कौन से मेथड्स कॉल किए जाते हैं, साथ ही क्रम की एक सामान्य धारणा है, आइए कुछ पार्सिंग मेथड्स का अध्ययन करें जिन्हें हमने अभी तक अधिक विस्तार से नहीं देखा है।
#parse_function_definition मेथड
#parse_function_definition मेथड तब कॉल किया गया जब वर्तमान टोकन :fn था और अगला :identifier था:
def parse_function_definition
  return unless consume_if_nxt_is(build_token(:identifier))
  fn = AST::FunctionDefinition.new(AST::Identifier.new(current.lexeme))
  if nxt.type != :"\n" && nxt.type != :':'
    unexpected_token_error
    return
  end
  fn.params = parse_function_params
  if nxt.type == :':'
    return unless consume_if_nxt_is(build_token(:"\n", "\n"))
    fn.body = parse_block
  end
  fn
end
#consume_if_nxt_is - जैसा कि आप अनुमान लगा रहे होंगे - हमारे पॉइंटर को आगे बढ़ाता है यदि अगला टोकन दिए गए प्रकार का है। अन्यथा, यह @errors में एक त्रुटि जोड़ता है। #consume_if_nxt_is बहुत उपयोगी है - और कई पार्सर मेथड्स में उपयोग किया जाता है - जब हम टोकन्स की संरचना की जांच करना चाहते हैं ताकि यह निर्धारित किया जा सके कि हमारे पास वैध सिंटैक्स है। ऐसा करने के बाद, वर्तमान टोकन :identifier प्रकार का है (हम 'double' को संभाल रहे हैं, फंक्शन का नाम), और हम एक AST::Identifier बनाते हैं और इसे फंक्शन परिभाषा को दर्शाने वाले नोड बनाने के लिए कंस्ट्रक्टर को पास करते हैं (AST::FunctionDefinition)। हम इसे यहां विस्तार से नहीं देखने जा रहे हैं, लेकिन मूल रूप से, एक AST::FunctionDefinition नोड फंक्शन नाम, संभावित रूप से पैरामीटर्स की एक सरणी और फंक्शन बॉडी की अपेक्षा करता है।
#parse_function_definition में अगला चरण यह सत्यापित करना है कि आइडेंटिफायर के बाद अगला टोकन एक एक्सप्रेशन टर्मिनेटर है (यानी, बिना पैरामीटर्स वाला फंक्शन) या कोलन (यानी, एक या एकाधिक पैरामीटर्स वाला फंक्शन)। यदि हमारे पास पैरामीटर्स हैं, जैसा कि double फंक्शन के मामले में है जिसे हम परिभाषित कर रहे हैं, तो हम उन्हें पार्स करने के लिए #parse_function_params को कॉल करते हैं। हम इस मेथड को एक पल में देखेंगे, लेकिन आइए पहले जारी रखें और #parse_function_definition की खोज समाप्त करें।
अंतिम चरण एक और सिंटैक्स जांच करना है ताकि यह सत्यापित किया जा सके कि फंक्शन नाम + पैरामीटर्स के बाद एक टर्मिनेटर है और, फिर, #parse_block को कॉल करके फंक्शन बॉडी को पार्स करने के लिए आगे बढ़ें। अंत में, हम fn लौटाते हैं, जिसमें हमारा पूरी तरह से निर्मित AST::FunctionDefinition इंस्टेंस होता है, जिसमें फंक्शन नाम, पैरामीटर्स और एक बॉडी होती है।
फंक्शन पैरामीटर्स पार्सिंग के नट्स और बोल्ट्स
पिछले खंड में, हमने देखा कि #parse_function_params को #parse_function_definition के अंदर कॉल किया जाता है। यदि हम अपने पार्सर के निष्पादन प्रवाह और स्थिति को सारांशित करने वाली तालिका पर वापस जाते हैं, तो हम देख सकते हैं कि जब #parse_function_params चलना शुरू होता है, तो वर्तमान टोकन :identifier प्रकार का है, और अगला :": है (यानी, हमने अभी फंक्शन नाम पार्स करना समाप्त किया है)। इस सब को ध्यान में रखते हुए, आइए कुछ और कोड देखें:
def parse_function_params
  consume
  return unless consume_if_nxt_is(build_token(:identifier))
  identifiers = []
  identifiers << AST::Identifier.new(current.lexeme)
  while nxt.type == :','
    consume
    return unless consume_if_nxt_is(build_token(:identifier))
    identifiers << AST::Identifier.new(current.lexeme)
  end
  identifiers
end
इस मेथड के प्रत्येक भाग की व्याख्या करने से पहले, आइए उन टोकन्स को दोहराएं जिन्हें हमें प्रोसेस करना है और हम इस काम में कहां हैं:
[:fn, :identifier, :":", :identifier, :"\n", :identifier, :*, :number, :"\n", :end, :"\n", :eof]
# here ▲
#parse_function_params का पहला भाग सीधा है। यदि हमारे पास वैध सिंटैक्स है (: के बाद कम से कम एक आइडेंटिफायर), तो हम अपने पॉइंटर को दो पोजीशन से आगे बढ़ाते हैं:
[:fn, :identifier, :":", :identifier, :"\n", :identifier, :*, :number, :"\n", :end, :"\n", :eof]
# ▲
अब, हम पार्स किए जाने वाले पहले पैरामीटर पर बैठे हैं (:identifier प्रकार का टोकन)। अपेक्षित रूप से, हम एक AST::Identifier बनाते हैं और इसे संभावित रूप से कई अन्य पैरामीटर्स की सरणी में पुश करते हैं जिन्हें अभी पार्स किया जाना बाकी है। #parse_function_params के अगले भाग में, हम पैरामीटर्स को पार्स करना जारी रखते हैं जब तक पैरामीटर सेपरेटर्स (यानी, :',' प्रकार के टोकन्स) हैं। हम मेथड को लोकल वेरिएबल identifiers को लौटाकर समाप्त करते हैं, एक सरणी जिसमें संभावित रूप से कई AST::Identifier नोड्स होते हैं, प्रत्येक एक पैरामीटर को दर्शाता है। हालांकि, हमारे मामले में, इस सरणी में केवल एक तत्व है।
फंक्शन बॉडी के बारे में क्या?
अब आइए फंक्शन परिभाषा के अंतिम भाग में गहराई से जाएं: इसके बॉडी से निपटना। जब #parse_block कॉल किया जाता है, तो हम उस टर्मिनेटर पर बैठे होते हैं जिसने फंक्शन पैरामीटर्स की सूची के अंत को चिह्नित किया था:
[:fn, :identifier, :":", :identifier, :"\n", :identifier, :*, :number, :"\n", :end, :"\n", :eof]
# ▲
और, यहां #parse_block का कार्यान्वयन है:
def parse_block
  consume
  block = AST::Block.new
  while current.type != :end && current.type != :eof && nxt.type != :else
    expr = parse_expr_recursively
    block << expr unless expr.nil?
    consume
  end
  unexpected_token_error(build_token(:eof)) if current.type == :eof
  block
end
AST::Block कोड के एक ब्लॉक को दर्शाने के लिए AST नोड है। दूसरे शब्दों में, AST::Block बस एक्सप्रेशन्स की एक सूची रखता है, हमारे प्रोग्राम के रूट नोड, AST::Program नोड (जैसा कि हमने इस पोस्ट की शुरुआत में देखा था) के बहुत समान फैशन में। ब्लॉक (यानी, फंक्शन बॉडी) को पार्स करने के लिए, हम अनप्रोसेस्ड टोकन्स के माध्यम से आगे बढ़ते रहते हैं जब तक कि हम एक टोकन का सामना नहीं करते जो ब्लॉक के अंत को चिह्नित करता है।
ब्लॉक को बनाने वाले एक्सप्रेशन्स को पार्स करने के लिए, हम अपने पहले से ज्ञात #parse_expr_recursively का उपयोग करते हैं। हम इस मेथड कॉल में बस एक पल में कदम रखेंगे; यह वह बिंदु है जहां हम अपने double फंक्शन के अंदर होने वाले प्रोडक्ट ऑपरेशन को पार्स करना शुरू करेंगे। इसका बारीकी से पालन करने से हमें #parse_expr_recursively के अंदर प्रीसिडेंस मानों के उपयोग को समझने में मदद मिलेगी और कैसे एक इन्फिक्स ऑपरेटर (हमारे मामले में *) को निपटाया जाता है। इससे पहले कि हम ऐसा करें, हालांकि, आइए #parse_block की खोज समाप्त करें।
AST::Block को दर्शाने वाला एक AST नोड लौटाने से पहले, हम जांचते हैं कि क्या वर्तमान टोकन :eof प्रकार का है। यदि ऐसा है, तो हमारे पास एक सिंटैक्स त्रुटि है क्योंकि Stoffle को एक ब्लॉक को end कीवर्ड के साथ समाप्त करने की आवश्यकता होती है। #parse_block की व्याख्या को समाप्त करने के लिए, मुझे कुछ ऐसा उल्लेख करना चाहिए जो आपने शायद देखा हो; हमारे लूप की शर्तों में से एक सत्यापित करता है कि अगला टोकन :else प्रकार का है या नहीं। ऐसा इसलिए होता है क्योंकि #parse_block अन्य पार्सिंग मेथड्स द्वारा साझा किया जाता है, जिसमें कंडीशनल्स और लूप्स के लिए जिम्मेदार मेथड्स शामिल हैं। बहुत साफ, है ना?!
इन्फिक्स ऑपरेटर्स पार्स करना
नाम थोड़ा फैंसी लग सकता है, लेकिन इन्फिक्स ऑपरेटर्स मूल रूप से वे हैं जिन्हें हम अंकगणित में देखने के बहुत आदी हैं, साथ ही कुछ अन्य जिनसे हम सॉफ्टवेयर डेवलपर्स के रूप में अधिक परिचित हो सकते हैं:
module Stoffle
  class Parser
    # ...
    BINARY_OPERATORS = [:'+', :'-', :'*', :'/', :'==', :'!=', :'>', :'<', :'>=', :'<='].freeze
    LOGICAL_OPERATORS = [:or, :and].freeze
    # ...
  end
end
उनसे इन्फिक्स नोटेशन का उपयोग करते समय इन्फिक्स्ड उपयोग करने की अपेक्षा की जाती है, जैसा कि Stoffle के मामले में है, जिसका अर्थ है कि उन्हें अपने दो ऑपरेंड्स के बीच में प्रकट होना चाहिए (उदाहरण के लिए, जैसा * हमारे double फंक्शन में num * 2 में प्रकट होता है)। उल्लेखनीय कुछ बात यह है कि हालांकि इन्फिक्स नोटेशन काफी लोकप्रिय है, ऑपरेटर्स को उनके ऑपरेंड्स के संबंध में स्थिति देने के अन्य तरीके हैं। यदि आप उत्सुक हैं, तो "पोलिश नोटेशन" और "रिवर्स पोलिश नोटेशन" मेथड्स के बारे में थोड़ा शोध करें।
हमारे double फंक्शन को पार्स करना समाप्त करने के लिए, हमें * ऑपरेटर से निपटना होगा:
fn double: num
  num * 2
end
पिछले खंड में, हमने उल्लेख किया था कि double के बॉडी को बनाने वाले एक्सप्रेशन को पार्स करना तब शुरू होता है जब #parse_expr_recursively को #parse_block के भीतर कॉल किया जाता है। जब ऐसा होता है, तो यहां @tokens में हमारी स्थिति है:
[:fn, :identifier, :":", :identifier, :"\n", :identifier, :*, :number, :"\n", :end, :"\n", :eof]
# ▲
और, हमारी याददाश्त ताज़ा करने के लिए, यहां #parse_expr_recursively का कोड फिर से है:
def parse_expr_recursively(precedence = LOWEST_PRECEDENCE)
  parsing_function = determine_parsing_function
  if parsing_function.nil?
    unrecognized_token_error
    return
  end
  expr = send(parsing_function)
  return if expr.nil?
  # जब expr nil होता है, तो इसका मतलब है कि हम \n या eof पर पहुंच गए हैं।
  # ध्यान दें कि यहां, हम अगले टोकन की जांच कर रहे हैं।
  while nxt_not_terminator? && precedence < nxt_precedence
    infix_parsing_function = determine_infix_function(nxt)
    return expr if infix_parsing_function.nil?
    consume
    expr = send(infix_parsing_function, expr)
  end
  expr
end
मेथड के पहले भाग में, हम वही #parse_identifier मेथड उपयोग करेंगे जिसका उपयोग हमने num वेरिएबल को पार्स करने के लिए किया था। फिर, पहली बार, while लूप की शर्तें सत्य का मूल्यांकन करेंगी; अगला टोकन टर्मिनेटर नहीं है, और अगले टोकन की प्रीसिडेंस इस वर्तमान parse_expr_recursively निष्पादन की प्रीसिडेंस से अधिक है (precedence डिफ़ॉल्ट, 0 है, जबकि nxt_precedence 6 लौटाता है क्योंकि अगला टोकन :'*' प्रकार का है)। यह इंगित करता है कि हमने जो नोड अभी बनाया है (एक AST::Identifier जो num को दर्शाता है) शायद हमारे AST में गहरा होगा (यानी, यह अभी बनाए जाने वाले नोड का बच्चा होगा)। हम लूप में प्रवेश करते हैं और #determine_infix_function को कॉल करते हैं, इसे अगला टोकन (*) पास करते हुए:
def determine_infix_function(token = current)
  if (BINARY_OPERATORS + LOGICAL_OPERATORS).include?(token.type)
    :parse_binary_operator
  elsif token.type == :'('
    :parse_function_call
  end
end
चूंकि * एक बाइनरी ऑपरेटर है, #determine_infix_function चलाने से :parse_binary_operator परिणाम होगा। #parse_expr_recursively में वापस, हम अपने टोकन्स पॉइंटर को एक पोजीशन से आगे बढ़ाएंगे और फिर #parse_binary_operator को कॉल करेंगे, expr के मान (num को दर्शाने वाला AST::Identifier) को पास करते हुए:
[:fn, :identifier, :":", :identifier, :"\n", :identifier, :*, :number, :"\n", :end, :"\n", :eof]
#▲
def parse_binary_operator(left)
op = AST::BinaryOperator.new(current.type, left)
op_precedence = current_precedence
consume
op.right = parse_expr_recursively(op_precedence)
op
end class Stoffle::AST::BinaryOperator < Stoffle::AST::Expression
attr_accessor :operator, :left, :right
def initialize(operator, left = nil, right = nil)
@operator = operator
@left = left
@right = right
end
def ==(other)
operator == other&.operator && children == other&.children
end
def children
[left, right]
end
end #parse_binary_operator पर, हम * को दर्शाने के लिए एक AST::BinaryOperator बनाते हैं (यदि आप उत्सुक हैं तो इसका कार्यान्वयन ऊपर दिखाया गया है), इसके बाएं ऑपरेंड को #parse_expr_recursively से प्राप्त आइडेंटिफायर (num) पर सेट करते हुए। फिर, हम * की प्रीसिडेंस मान को लोकल वेरिएबल op_precedence पर सेव करते हैं और अपने टोकन पॉइंटर को आगे बढ़ाते हैं। * को दर्शाने वाले हमारे नोड को समाप्त करने के लिए, हम #parse_expr_recursively को फिर से कॉल करते हैं! हमें इस फैशन में आगे बढ़ने की आवश्यकता है क्योंकि हमारे ऑपरेटर का दायां पक्ष हमेशा एक सिंगल नंबर या आइडेंटिफायर नहीं होगा; यह एक अधिक जटिल एक्सप्रेशन हो सकता है, जैसे num * (2 + 2) जैसा कुछ।
एक अत्यंत महत्वपूर्ण बात जो यहां #parse_binary_operator पर होती है, वह है जिस तरह से हम #parse_expr_recursively को वापस कॉल करते हैं। हम इसे 6 को प्रीसिडेंस मान के रूप में पास करके कॉल करते हैं (* की प्रीसिडेंस, op_precedence पर संग्रहीत)। यहां हम अपने पार्सिंग एल्गोरिदम के एक महत्वपूर्ण पहलू का निरीक्षण करते हैं, जिसका पहले उल्लेख किया गया था। एक अपेक्षाकृत उच्च प्रीसिडेंस मान पास करके, ऐसा लगता है जैसे * अगले टोकन को अपने ऑपरेंड के रूप में खींच रहा है। कल्पना करें कि हम num * 2 + 1 जैसे एक्सप्रेशन को पार्स कर रहे थे; इस मामले में, इस अगले #parse_expr_recursively कॉल में पास किया गया * का प्रीसिडेंस मान यह गारंटी देगा कि 2 * के दाएं पक्ष के रूप में समाप्त होगा न कि + का ऑपरेंड, जिसका प्रीसिडेंस मान 5 कम है।
#parse_expr_recursively द्वारा AST::Number नोड लौटाने के बाद, हम इसे * के दाएं पक्ष के रूप में सेट करते हैं और, अंत में, हमारा पूरा AST::BinaryOperator नोड लौटाते हैं। इस बिंदु पर, हमने मूल रूप से अपने Stoffle प्रोग्राम को पार्स करना समाप्त कर लिया है। हमें अभी भी कुछ टर्मिनेटर टोकन्स पार्स करने हैं, लेकिन यह सीधा और बहुत दिलचस्प नहीं है। अंत में, हमारे पास @ast पर एक AST::Program इंस्टेंस होगा जिसमें एक्सप्रेशन्स होंगे जिन्हें इस पोस्ट की शुरुआत में और दूसरे खंड के परिचय में देखे गए ट्री के रूप में विज़ुअली दर्शाया जा सकता है:
समापन
इस पोस्ट में, हमने Stoffle के पार्सर के प्रमुख पहलुओं को कवर किया। यदि आप यहां खोजे गए बिट्स को समझते हैं, तो आपको अन्य पार्सर मेथड्स को समझने में अधिक परेशानी नहीं होनी चाहिए जिन्हें हम कवर नहीं कर पाए, जैसे कंडीशनल्स और लूप्स को पार्स करना। मैं आपको पार्सर के स्रोत कोड को स्वयं एक्सप्लोर करने और यदि आप अधिक साहसी महसूस कर रहे हैं तो कार्यान्वयन को ट्वीक करने के लिए प्रोत्साहित करता हूं! कार्यान्वयन एक व्यापक टेस्ट सूट के साथ है, इसलिए पार्सर के साथ चीजों को आजमाने और गड़बड़ करने से डरो मत।
इस श्रृंखला के बाद के पोस्ट्स में, हम अंततः अपने छोटे राक्षस में जान फूंक देंगे, अंतिम बिट को लागू करके जो हम खो रहे हैं: ट्री-वॉक इंटरप्रेटर। मैं आपके साथ वहां होने का इंतजार नहीं कर सकता जब हम अपना पहला Stoffle प्रोग्राम चलाएंगे!