यह Ruby के साथ विभिन्न सॉर्टिंग एल्गोरिदम को लागू करने पर एक श्रृंखला का भाग 3 है। भाग 1 ने बबल सॉर्ट का पता लगाया, और भाग 2 ने सिलेक्शन सॉर्ट का पता लगाया।
जैसा कि हमने इस श्रृंखला के पिछले पोस्ट्स में चर्चा की है, डेटा को कैसे सॉर्ट किया जाए यह समझना किसी भी सॉफ्टवेयर इंजीनियर के टूलकिट का अभिन्न अंग है। सौभाग्य से, अधिकांश हायर-लेवल लैंग्वेजेज, जैसे Ruby, में पहले से ही बिल्ट-इन मेथड्स हैं जो एरेज़ को सॉर्ट करने में कुशल हैं। उदाहरण के लिए, जब आप एक एरे पर .sort कॉल करते हैं, तो आप हुड के तहत क्विकसॉर्ट का उपयोग कर रहे होते हैं। इस पोस्ट में, हम क्विक सॉर्ट के समान एक एल्गोरिदम सीखने जा रहे हैं -- मर्ज सॉर्ट। ये दोनों एल्गोरिदम "डिवाइड एंड कंकर" दृष्टिकोण का उपयोग करते हैं। मर्ज सॉर्ट का आविष्कार 1945 में जॉन वॉन न्यूमैन ने किया था। वॉन न्यूमैन एक प्रसिद्ध कंप्यूटर साइंटिस्ट और भौतिक विज्ञानी थे जो मैनहट्टन प्रोजेक्ट, "मिनी-मैक्स" थ्योरम, मोंटे कार्लो मेथड, और बहुत कुछ पर काम करने के लिए भी जाने जाते हैं।
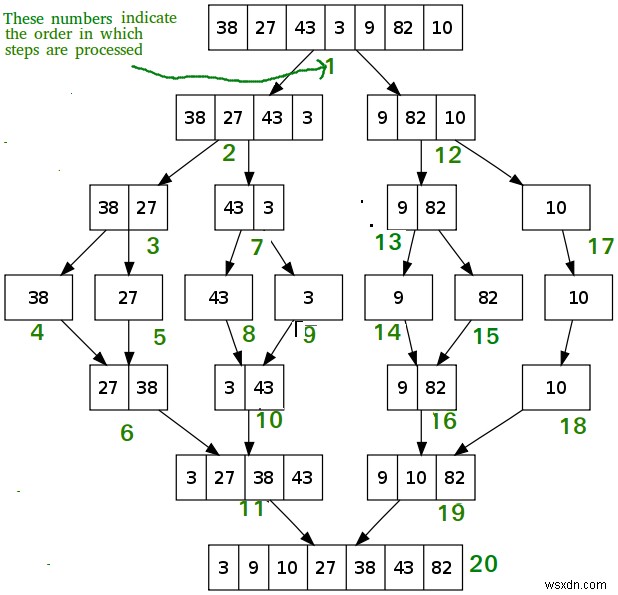
उच्च स्तर पर, मर्ज सॉर्ट एल्गोरिदम एरे को दो सब-एरेज़ में बार-बार विभाजित करता है (रीकर्सन का उपयोग करके) जब तक केवल एक तत्व शेष नहीं रहता। वहां से, तत्वों को अंतिम, सॉर्टेड एरे बनाने के लिए एक साथ "मर्ज" किया जाता है। बबल सॉर्ट और अन्य समान एल्गोरिदम के विपरीत, जिन्हें हमने पहले चर्चा की थी, मर्ज सॉर्ट को विज़ुअलाइज़ेशन के बिना समझना मुश्किल है। निम्न आरेख विकिपीडिया से एक चरण-दर-चरण चित्रण है जो दिखाता है कि मर्ज सॉर्ट कैसे काम करता है। हालांकि, चिंता न करें यदि आप अभी भी थोड़ा अस्पष्ट हैं कि क्या हो रहा है; हम आगे कोड के माध्यम से काम करेंगे।
पहले चर्चा किए गए एल्गोरिदम (यानी बबल और सिलेक्शन) के विपरीत, जो मूल रूप से किसी भी वास्तविक कार्य के लिए अव्यावहारिक थे, मर्ज सॉर्ट Big-O नोटेशन के संदर्भ में बहुत बेहतर प्रदर्शन करता है। यदि आप Big-O नोटेशन से अपरिचित हैं, तो यह विभिन्न एल्गोरिदम के सबसे खराब स्थिति के प्रदर्शन को दर्शाता है। यह हमें उनके Big-O के आधार पर एल्गोरिदम की आसानी से तुलना करने की अनुमति देता है। उदाहरण के लिए, O(1) के Big-O वाला एक एल्गोरिदम का मतलब है कि सबसे खराब स्थिति का रन-टाइम स्थिर है क्योंकि तत्वों की संख्या, "n", बढ़ती है, जबकि O(n) के Big-O नोटेशन वाला एक एल्गोरिदम का मतलब है कि सबसे खराब स्थिति का रन-टाइम n के बढ़ने के साथ रैखिक रूप से बढ़ता है। इसका मतलब है कि यदि आपके पास 100 तत्वों वाला एक एरे है और आपको O(n) और O(1) सॉर्टिंग एल्गोरिदम के बीच चयन करना है, तो आप O(1) एल्गोरिदम चुनेंगे क्योंकि O(1) निश्चित रूप से O(100) को हराता है। बबल और सिलेक्शन सॉर्ट एल्गोरिदम दोनों का सबसे खराब स्थिति O(n²) है। यह बहुत उपयोगी नहीं है क्योंकि इसका मतलब है कि एल्गोरिदम तत्वों की संख्या बढ़ने पर बेहद धीमा प्रदर्शन करेगा। इसके विपरीत, मर्ज सॉर्ट n log(n) पर प्रदर्शन करता है, जिसका अर्थ है कि एल्गोरिदम बबल या सिलेक्शन सॉर्ट जितना दक्षता बलिदान नहीं करेगा।
चलिए आरेख में उदाहरण के माध्यम से चलते हैं। हम [38, 27, 43, 3, 9, 82, 10] के एक एरे से शुरू करते हैं और फिर एरे को आधे में विभाजित करते हैं जब तक हम सिंगल तत्वों के साथ नहीं बचे।
- हम शुरुआती एरे को दो हिस्सों में विभाजित करते हैं:
[38, 27, 43, 3]और[9, 82, 10]। - हम पहले आधे को फिर से विभाजित करते हैं:
[38, 27]और[43, 3]। - हम पहले आधे को सिंगल तत्वों में विभाजित करते हैं:
[38],[27],[43], और[3]। - हम 38 और 27 को सॉर्ट करके
[27, 38]बनाते हैं और 43 और 3 को[3, 43]बनाने के लिए सॉर्ट करते हैं। - इन्हें एक साथ रखने पर, हमारे पास
[3, 27, 38, 43]होता है। - अब, हम मूल एरे के दूसरे आधे पर जाते हैं, जो
[9, 82, 10]था। हम इसे आधे में विभाजित करते हैं और[9, 82]और[10]प्राप्त करते हैं। - हम
[9, 82]को[9]और[82]में विभाजित करते हैं, और फिर हमारे पास[10]होता है, जो पहले से ही सिंगुलर है। - हम
[9, 82]को एक साथ वापस सॉर्ट करते हैं और फिर[10]को वापस मर्ज करते हैं, जिसके परिणामस्वरूप[9, 10, 82]होता है। - अंत में, हम
[3, 27, 38, 43]और[9, 10, 82]को मर्ज करके[3, 9, 10, 27, 38, 43, 82]प्राप्त करते हैं।
एक Ruby कार्यान्वयन
निम्नलिखित Ruby में लिखा गया एक मर्ज सॉर्ट एल्गोरिदम है:
class MergeSort
  def sort(numbers)
    num_elements = numbers.length
    if num_elements <= 1
      return numbers
    end
    half_of_elements = (num_elements / 2).round
    left = numbers.take(half_of_elements)
    right = numbers.drop(half_of_elements)
    sorted_left = sort(left)
    sorted_right = sort(right)
    merge(sorted_left, sorted_right)
  end

  def merge(left_array, right_array)
    if right_array.empty?
      return left_array
    end
    if left_array.empty?
      return right_array
    end
    smallest_number = if left_array.first <= right_array.first
                        left_array.shift
                      else
                        right_array.shift
                      end
    recursive = merge(left_array, right_array)
    [smallest_number].concat(recursive)
  end
end
चलिए देखते हैं कि यहां क्या हो रहा है। पहले, हम शीर्ष पर sort मेथड पर ध्यान केंद्रित करेंगे।
def sort(numbers)
  num_elements = numbers.length
  if num_elements <= 1
    return numbers
  end
  half_of_elements = (num_elements / 2).round
  left = numbers.take(half_of_elements)
  right = numbers.drop(half_of_elements)
  sorted_left = sort(left)
  sorted_right = sort(right)
  merge(sorted_left, sorted_right)
end
इस कोड भाग का लक्ष्य दी गई संख्याओं को आधे में विभाजित करना है जब तक हम प्रत्येक में केवल एक आइटम के साथ नहीं बचे। इसे क्रिया में देखने के लिए, अंतिम लाइन (merge(sorted_left, sorted_right)) को कमेंट आउट करें और, इसके बजाय, sorted_left और sorted_right को प्रिंट करें। हमारे उदाहरण एरे को पास करके प्रोग्राम चलाएं, आपको अपने टर्मिनल में यह देखना चाहिए:
merge_sort = MergeSort.new
puts merge_sort.sort([38, 27, 43, 3, 9, 82, 10])
ruby ruby-merge-sort.rb
27
43
38
3
9
82
10
बढ़िया! हमारे कोड ने हमारे प्रारंभिक एरे को ले लिया है और इसे आधे में विभाजित कर दिया है। चलिए अब कोड के merge भाग को देखते हैं।
def merge(left_array, right_array)
  if right_array.empty?
    return left_array
  end
  if left_array.empty?
    return right_array
  end
  smallest_number = if left_array.first <= right_array.first
                      left_array.shift
                    else
                      right_array.shift
                    end
  recursive = merge(left_array, right_array)
  [smallest_number].concat(recursive)
end
पहले, हम जांचते हैं कि क्या सब-एरेज़ में से कोई खाली है। यदि हां, तो हम बस दूसरे को वापस कर सकते हैं। अन्यथा, यह देखते हुए कि दोनों सब-एरेज़ खाली नहीं हैं, हम प्रत्येक एरे के पहले तत्व के मान की तुलना करते हैं और फिर अनंत लूप के निर्माण को रोकने के लिए तुलना किए गए मानों को शिफ्ट करते हैं। अगला, हम मूल एरे पर रीकर्सन का उपयोग करते हैं (इस पर एक सेकंड में और अधिक!) जब तक हम अंत में दोनों एरेज़ को अच्छी तरह से सॉर्ट करके एक साथ जोड़ नहीं सकते।
रीकर्सन पर थोड़ा अधिक
यदि हमारे कोड में कुछ अजीब लगता है, तो मेरा अनुमान है कि यह यह लाइन है: recursive = merge(left_array, right_array) हम अपने merge मेथड को अपने भीतर से कॉल कर रहे हैं। वाह! इसे रीकर्सन कहते हैं -- एक तकनीक जिसमें एक फंक्शन खुद को एक या अधिक बार तब तक कॉल करता है जब तक एक निर्दिष्ट स्थिति पूरी नहीं हो जाती। हमारे मामले में, merge को तब तक कॉल किया जाता रहेगा जब तक बायां या दायां एरे खाली नहीं हो जाता। यदि आप रीकर्सन के बारे में अधिक सीखने में रुचि रखते हैं, तो यहां एक उदाहरण है जो Ruby और रीकर्सन का उपयोग करके फाइबोनैचि अनुक्रम के लिए एक फंक्शन लिखने के बारे में बताता है।
समापन
मुझे आशा है कि आपको मर्ज सॉर्ट के बारे में अधिक जानने में मज़ा आया! उच्च स्तर पर यह कैसे काम करता है, साथ ही क्यों यह बबल या सिलेक्शन सॉर्ट की तुलना में अधिक कुशल विकल्प है, यह समझना नौकरी के इंटरव्यू या आपके दिन-प्रतिदिन के कार्यों में काम आएगा। इसके अलावा, मर्ज सॉर्ट के कई वेरिएंट हैं जिनके बारे में आप विकिपीडिया पर अधिक पढ़ सकते हैं यदि आप रुचि रखते हैं। अगली बार तक ... हैप्पी सॉर्टिंग!