Gephi और Sigma.js के साथ एक नेटवर्क विज़ुअलाइज़ेशन ट्यूटोरियल
यहां आज हम जो बनाने जा रहे हैं उसका पूर्वावलोकन है: प्रोग्रामिंग लैंग्वेज इन्फ्लुएंस ग्राफ। 250 से अधिक प्रोग्रामिंग लैंग्वेजेज के बीच "डिजाइन इन्फ्लुएंस" संबंधों का पता लगाने के लिए लिंक देखें!
आपकी बारी!
आज की हाइपर-कनेक्टेड दुनिया में, नेटवर्क आधुनिक जीवन का एक सर्वव्यापी पहलू हैं।
आज अब तक मेरे दिन की शुरुआत लें — मैंने शहर में यात्रा करने के लिए लंदन के ट्रांसपोर्ट नेटवर्क का उपयोग किया। फिर मैं अपनी पसंदीदा कॉफी शॉप की एक शाखा में गया और अपने Chromebook का उपयोग करके उनके वाई-फाई नेटवर्क से जुड़ा। अगला, मैंने उन विभिन्न सोशल नेटवर्किंग साइट्स में लॉग इन किया जिन्हें मैं बार-बार देखता हूं।
यह कोई रहस्य नहीं है कि पिछले कुछ दशकों की सबसे प्रभावशाली कंपनियों में से कुछ अपनी सफलता नेटवर्क की शक्ति के लिए मानती हैं।
Facebook, Twitter, Instagram, LinkedIn और अन्य सोशल मीडिया प्लेटफॉर्म सोशल नेटवर्क के छोटे-विश्व गुणों पर भरोसा करते हैं। यह उन्हें अपने उपयोगकर्ताओं को एक-दूसरे से (और विज्ञापनदाताओं से) प्रभावी ढंग से जोड़ने देता है।
Google अपनी वर्तमान सफलता का अधिकांश श्रेय सर्च इंजन मार्केट में अपने शुरुआती प्रभुत्व को देता है — जो उनकी पेज रैंक नेटवर्क एल्गोरिथम की मदद से प्रासंगिक परिणाम लौटाने की उनकी क्षमता के माध्यम से भाग में सक्षम हुआ।
Amazon का कुशल वितरण नेटवर्क उन्हें कुछ प्रमुख शहरों में सेम-डे डिलीवरी की पेशकश करने की अनुमति देता है।
नेटवर्क आर्टिफिशियल इंटेलिजेंस और मशीन लर्निंग जैसे क्षेत्रों में भी सुपर-महत्वपूर्ण हैं। न्यूरल नेटवर्क अनुसंधान का एक बहुत सक्रिय क्षेत्र हैं। कंप्यूटर विजन में आवश्यक कई फीचर डिटेक्शन एल्गोरिदम, छवियों के विभिन्न भागों को मॉडल करने के लिए नेटवर्क का उपयोग करने पर बहुत अधिक भरोसा करते हैं।
वैज्ञानिक घटनाओं की एक विस्तृत श्रृंखला को नेटवर्क मॉडल के संदर्भ में भी समझा जा सकता है। इसमें क्वांटम मैकेनिक्स, बायोकेमिकल पाथवे, और पारिस्थितिक और सामाजिक-आर्थिक प्रणालियां शामिल हैं।
उनके निर्विवाद महत्व को देखते हुए, हम नेटवर्क और उनके गुणों को बेहतर कैसे समझ सकते हैं?
नेटवर्क का गणितीय अध्ययन "ग्राफ थ्योरी" के रूप में जाना जाता है, और यह गणित की अधिक सुलभ शाखाओं में से एक है। यह लेख कम पूर्व ज्ञान या अनुभव मानकर एक परिचय प्रदान करने का लक्ष्य रखता है।
हम Python 3.x और Gephi नामक कुछ भयानक ओपन-सोर्स सॉफ्टवेयर का उपयोग करके एक नेटवर्क विज़ुअलाइज़ेशन को एक साथ रखेंगे कि कैसे अतीत और वर्तमान की प्रोग्रामिंग लैंग्वेजेज की एक श्रृंखला प्रभाव द्वारा जुड़ी हुई है।
लेकिन पहले…
आखिर एक नेटवर्क क्या है?
ऊपर वर्णित उदाहरण हमें कुछ सुराग देते हैं। ट्रांसपोर्ट नेटवर्क डेस्टिनेशन्स से बने होते हैं जो रूट्स से जुड़े होते हैं। सोशल नेटवर्क इंडिविजुअल्स से बने होते हैं, जो एक-दूसरे के साथ अपने रिलेशनशिप्स के माध्यम से जुड़े होते हैं। Google के सर्च इंजन एल्गोरिदम विभिन्न वेबपेजेज की "रैंक" का मूल्यांकन यह देखकर करते हैं कि कौन से पेज दूसरों से लिंक आउट करते हैं।
अधिक आम तौर पर, एक नेटवर्क कोई भी सिस्टम है जिसे नोड्स और एजेस के संदर्भ में वर्णित किया जा सकता है, या बोलचाल की भाषा में, "डॉट्स और लाइन्स"।
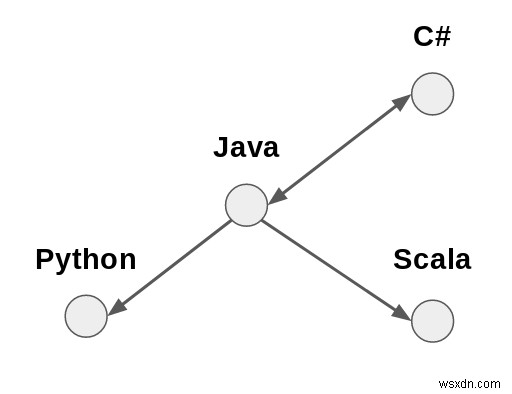
कुछ सिस्टम्स इस तरीके से आसानी से अमूर्त हो जाते हैं। सोशल नेटवर्क शायद सबसे स्पष्ट उदाहरण हैं। कंप्यूटर फाइल सिस्टम्स एक और हैं — फोल्डर्स और फाइल्स उनके "पैरेंट" और "चाइल्ड" रिलेशनशिप्स द्वारा जुड़े हुए हैं।
लेकिन नेटवर्क्स की असली ताकत इस तथ्य से आती है कि कई, कई सिस्टम्स को नेटवर्क शब्दों में अमूर्त और मॉडल किया जा सकता है, भले ही पहली नज़र में यह स्पष्ट न हो कि कैसे।
नेटवर्क का प्रतिनिधित्व
नेटवर्क का गणितीय विश्लेषण और वर्णन करने के लिए हमें पेन-एंड-पेपर स्केच से थोड़ा आगे जाने की जरूरत है। हम डॉट्स और लाइन्स की तस्वीरों को संख्याओं में कैसे बदल सकते हैं जिन्हें हम क्रंच कर सकते हैं?
एक समाधान हमारे नेटवर्क का प्रतिनिधित्व करने के लिए एक एडजेसेंसी मैट्रिक्स बनाना है।
मैट्रिक्स उन अवधारणाओं में से एक हैं जो थोड़ा डराने वाला लग सकता है यदि आप उनसे परिचित नहीं हैं, लेकिन डरें नहीं। उन्हें संख्याओं के ग्रिड के रूप में सोचें जिनका उपयोग एक साथ कई गणनाएं करने के लिए किया जा सकता है। यहां नीचे एक उदाहरण है:
Python Java Scala C# Python 0 1 0 0 Java 0 0 0 1 Scala 0 1 0 0 C# 0 1 0 0इस मैट्रिक्स में, प्रत्येक पंक्ति और कॉलम का प्रतिच्छेदन 0 या 1 है, इस पर निर्भर करता है कि संबंधित भाषाएं जुड़ी हुई हैं या नहीं। आप इसे ऊपर दिए चित्र के विरुद्ध जांच सकते हैं!
अधिकांश उद्देश्यों के लिए, एडजेसेंसी मैट्रिक्स एक नेटवर्क को गणितीय रूप से प्रस्तुत करने का एक अच्छा तरीका है। हालांकि, कम्प्यूटेशनल दृष्टिकोण से, यह कभी-कभी थोड़ा बोझिल हो सकता है।
उदाहरण के लिए, अपेक्षाकृत मामूली संख्या में नोड्स (मान लें 1000) के साथ, मैट्रिक्स में बहुत बड़ी संख्या में एलिमेंट्स होंगे (जैसे, 1000² = 1,000,000)।
कई वास्तविक दुनिया के सिस्टम्स स्पार्स नेटवर्क्स उत्पन्न करते हैं। इन नेटवर्क्स में, अधिकांश नोड्स केवल अन्य सभी के एक छोटे अनुपात से जुड़ते हैं।
यदि हम एक 1000-नोड स्पार्स नेटवर्क को कंप्यूटर मेमोरी में एडजेसेंसी मैट्रिक्स के रूप में प्रस्तुत करते, तो हमारे पास RAM में संग्रहीत 1,000,000 बाइट्स डेटा होगा। अधिकांश शून्य होंगे। इसके बारे में जाने का एक अधिक कुशल तरीका होना चाहिए।
एक वैकल्पिक दृष्टिकोण एज लिस्ट्स के साथ काम करना है। ये ठीक वही हैं जो वे कहते हैं कि वे हैं। वे बस एक सूची हैं कि कौन से नोड जोड़े एक दूसरे से जुड़ते हैं।
उदाहरण के लिए, ऊपर दिए गए प्रोग्रामिंग लैंग्वेज नेटवर्क को इस प्रकार दर्शाया जा सकता है:
Java, Python Java, Scala Java, C# C#, Javaबड़े नेटवर्क्स के लिए, यह उन्हें प्रस्तुत करने का एक बहुत अधिक कम्प्यूटेशनली कुशल साधन है। बेशक, एज लिस्ट से एडजेसेंसी मैट्रिक्स उत्पन्न करना संभव है (और इसके विपरीत)। ऐसा नहीं है कि हमें एक या दूसरे को चुनना होगा।
नेटवर्क का प्रतिनिधित्व करने का एक और साधन एडजेसेंसी लिस्ट्स हैं। यह प्रत्येक नोड को उसके द्वारा लिंक किए गए नोड्स के बाद सूचीबद्ध करता है। उदाहरण के लिए:
Java: Python, Scala, C# C#: Javaडेटा एकत्र करना, कनेक्शन बनाना
कोई भी नेटवर्क मॉडल और विज़ुअलाइज़ेशन केवल उतना ही अच्छा होगा जितना डेटा जिसका उपयोग इसे बनाने के लिए किया गया है। इसका मतलब है, डेटा की सटीकता और पूर्णता सुनिश्चित करने के अलावा, हमें नोड्स के बीच एजेस का अनुमान लगाने का एक साधन भी उचित ठहराने की आवश्यकता है।
कई मायनों में, यह महत्वपूर्ण कदम है। नेटवर्क के बारे में कोई भी बाद का विश्लेषण और निष्कर्ष "लिंकेज क्राइटेरियन" को उचित ठहराने में सक्षम होने पर निर्भर करता है।
उदाहरण के लिए, सोशल नेटवर्क विश्लेषण में, आप लोगों को इस आधार पर जोड़ सकते हैं कि क्या वे सोशल मीडिया पर एक-दूसरे को फॉलो करते हैं। आणविक जीव विज्ञान में, आप जीन्स को उनके सह-अभिव्यक्ति के आधार पर जोड़ सकते हैं।
अक्सर, नोड्स को जोड़ने के लिए उपयोग की जाने वाली विधि वेट्स को एजेस को असाइन करने की अनुमति देगी, जिससे "ताकत" का माप मिलेगा।
उदाहरण के लिए, ऑनलाइन रिटेल के संदर्भ में, आप उत्पादों को इस आधार पर जोड़ सकते हैं कि उन्हें कितनी बार एक साथ खरीदा जाता है। उत्पाद जो अक्सर एक साथ खरीदे जाते हैं, उन्हें उन उत्पादों की तुलना में अधिक वेटेड एज द्वारा जोड़ा जाएगा जो केवल कभी-कभी एक साथ खरीदे जाते हैं। उत्पाद जो संयोग से अपेक्षा से अधिक बार एक साथ नहीं खरीदे जाते, वे बिल्कुल भी लिंक नहीं होंगे।
जैसा कि आप कल्पना कर सकते हैं, नोड्स को एक-दूसरे से जोड़ने के तरीके उतने ही परिष्कृत हो सकते हैं जितना आप चाहें।
हालांकि, इस ट्यूटोरियल के लिए हम प्रोग्रामिंग लैंग्वेजेज को जोड़ने के लिए एक सरल साधन का उपयोग करेंगे। हम Wikipedia की सटीकता पर भरोसा करने जा रहे हैं।
हमारे उद्देश्यों के लिए, यह ठीक होना चाहिए। Wikipedia की सफलता इस बात का प्रमाण है कि वह कुछ सही कर रहा होगा। लेख लिखे जाने की ओपन-सोर्स, सहयोगी विधि कुछ हद तक निष्पक्षता सुनिश्चित करनी चाहिए।
साथ ही, इसकी अपेक्षाकृत सुसंगत पेज संरचना वेब-स्क्रैपिंग तकनीकों को आजमाने के लिए एक सुविधाजनक खेल का मैदान बनाती है।
एक और बोनस व्यापक, अच्छी तरह से प्रलेखित Wikipedia API है, जो सूचना पुनर्प्राप्ति को और भी आसान बनाता है। शुरू करते हैं।
चरण 1 — Gephi इंस्टॉल करना
Gephi Linux, Mac और Windows पर उपलब्ध है। आप इसे यहां डाउनलोड कर सकते हैं।
इस प्रोजेक्ट के लिए, मैं Lubuntu का उपयोग कर रहा था। यदि आप Ubuntu/Debian पर हैं, तो आप Gephi को चालू करने के लिए नीचे दिए चरणों का पालन कर सकते हैं। अन्यथा, इंस्टॉलेशन प्रक्रिया संभवतः वही होगी जिससे आप परिचित हैं।
अपने सिस्टम के लिए Gephi का नवीनतम संस्करण (लिखने के समय यह v.0.9.1 था) डाउनलोड करें। जब यह तैयार हो जाए, तो आपको फ़ाइलों को निकालना होगा।
cd Downloads tar -xvzf gephi-0.9.1-linux.tar.gz cd gephi-0.9.1/bin./gephiआपको अपने Java JRE के संस्करण की जांच करने की आवश्यकता हो सकती है। Gephi को हाल के संस्करण की आवश्यकता होती है। Lubuntu के मेरे अपेक्षाकृत नए इंस्टॉल पर, मैंने बस default-jre इंस्टॉल किया, और वहां से सब कुछ काम कर गया।
apt install default-jre ./gephiशुरू करने से पहले एक और कदम है। वेब पर ग्राफ को निर्यात करने के लिए, आप Gephi के लिए Sigma.js प्लगइन का उपयोग कर सकते हैं।
Gephi के मेनू बार से, "Tools" विकल्प चुनें, और "Plugins" चुनें।
"Available Plugins" टैब पर क्लिक करें और "SigmaExporter" चुनें (मैंने JSON Exporter भी इंस्टॉल किया, क्योंकि यह एक और उपयोगी प्लगइन है जिसे रखना अच्छा है)।
"Install" बटन दबाएं और आपको प्रक्रिया के माध्यम से चलाया जाएगा। एक बार पूरा हो जाने पर Gephi को पुनरारंभ करने की आवश्यकता होगी।
चरण 2 — Python स्क्रिप्ट लिखना
यह ट्यूटोरियल Python 3.x का उपयोग करेगा, साथ ही जीवन को आसान बनाने के लिए कुछ मॉड्यूल्स। Pip मॉड्यूल इंस्टॉलर का उपयोग करके, निम्न कमांड चलाएं:
pip3 install wikipediaअब, एक नई डायरेक्टरी में, script.py जैसी कोई फ़ाइल बनाएं, और इसे अपने पसंदीदा कोड एडिटर/IDE में खोलें। नीचे मुख्य तर्क की रूपरेखा है:
- सबसे पहले, आपको शामिल करने के लिए प्रोग्रामिंग लैंग्वेजेज की एक सूची चाहिए।
- अगला, उस सूची के माध्यम से जाएं और संबंधित Wikipedia लेख का HTML प्राप्त करें।
- इससे, उन प्रोग्रामिंग लैंग्वेजेज की एक सूची निकालें जिन्हें प्रत्येक भाषा ने प्रभावित किया है। यह एक रफ-एंड-रेडी लिंकेज क्राइटेरियन होगा।
- जब आप इसमें हैं, तो प्रत्येक भाषा के बारे में कुछ मेटाडेटा हथियाना अच्छा होगा।
- अंत में, आप अपने द्वारा एकत्र किए गए सभी डेटा को एक .csv फ़ाइल में लिखना चाहेंगे
पूरी स्क्रिप्ट इस gist में पाई जा सकती है।
कुछ मॉड्यूल्स इम्पोर्ट करें
script.py में, कुछ मॉड्यूल्स इम्पोर्ट करके शुरू करें जो चीजों को आसान बनाएंगे:
import csv import wikipedia import urllib.request from bs4 import BeautifulSoup as BS import reOK — नोड्स को शामिल करने की सूची बनाकर शुरू करें। यहां Wikipedia मॉड्यूल काम आता है। यह Wikipedia API तक पहुंच को सुपर-आसान बनाता है।
निम्न कोड जोड़ें:
pageTitle = "List of programming languages" nodes = list(wikipedia.page(pageTitle).links) print(nodes)यदि आप इस स्क्रिप्ट को सेव और चलाते हैं, तो आप देखेंगे कि यह "List of programming languages" Wikipedia लेख के सभी लिंक्स प्रिंट करता है। अच्छा!
हालांकि, किसी भी स्वचालित रूप से एकत्र किए गए डेटा का मैन्युअल निरीक्षण करना हमेशा समझदारी है। एक त्वरित नज़र से पता चलेगा कि, कई वास्तविक प्रोग्रामिंग लैंग्वेजेज के अलावा, स्क्रिप्ट ने कुछ अतिरिक्त लिंक्स भी उठाए हैं।
उदाहरण के लिए, आप वहां "List of markup languages", "Comparison of programming languages" और अन्य देख सकते हैं।
हालांकि Gephi आपको उन नोड्स को हटाने देता है जिन्हें आप शामिल नहीं करना चाहते, आगे बढ़ने से पहले डेटा को "साफ" करने में कोई बुराई नहीं है। यदि कुछ भी हो, तो यह बाद में समय बचाएगा।
removeList = [ "List of", "Lists of", "Timeline", "Comparison of", "History of", "Esoteric programming language" ] nodes = [i for i in nodes if not any(r in i for r in removeList)]ये लाइनें डेटा से हटाए जाने वाले सबस्ट्रिंग्स की एक सूची को परिभाषित करती हैं। स्क्रिप्ट तब डेटा के माध्यम से जाती है, किसी भी तत्व को हटा देती है जिसमें अवांछित सबस्ट्रिंग्स में से कोई भी होता है।
Python में, इसके लिए कोड की केवल एक लाइन की आवश्यकता होती है!
कुछ हेल्पर फ़ंक्शन्स
अब आप एज लिस्ट बनाने (और किसी भी मेटाडेटा को एकत्र करने) के लिए Wikipedia को स्क्रैप करना शुरू कर सकते हैं। इसे आसान बनाने के लिए, पहले कुछ फ़ंक्शन्स को परिभाषित करें।
HTML प्राप्त करना
पहला फ़ंक्शन BeautifulSoup मॉड्यूल का उपयोग करके प्रत्येक भाषा के Wikipedia पेज के लिए HTML प्राप्त करता है।
base = "https://en.wikipedia.org/wiki/" def getSoup(n): try: with urllib.request.urlopen(base+n) as response: soup = BS(response.read(),'html.parser') table = soup.find_all("table",class_="infobox vevent")[0] return table except: passयह फ़ंक्शन urllib.request मॉड्यूल का उपयोग करके “https://en.wikipedia.org/wiki/” + “programming language” पर पेज के लिए HTML प्राप्त करता है।
इसे तब BeautifulSoup को पास किया जाता है, जो HTML को पढ़ता और पार्स करता है जिसे हम जानकारी खोजने के लिए उपयोग कर सकते हैं।
अगला, उस HTML एलिमेंट को निकालने के लिए find_all() मेथड का उपयोग करें जिसमें आप रुचि रखते हैं।
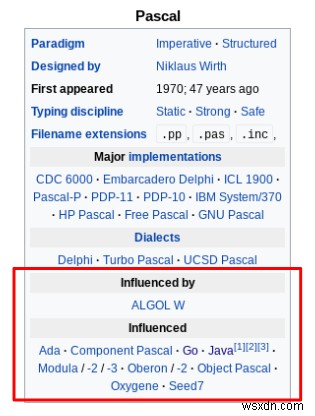
यहां, यह प्रत्येक प्रोग्रामिंग लैंग्वेज लेख के शीर्ष पर सारांश तालिका होगी। इन्हें कैसे पहचाना जा सकता है?
सबसे आसान तरीका प्रोग्रामिंग लैंग्वेज पेज में से एक पर जाना है। यहां, आप रुचि के एलिमेंट्स का निरीक्षण करने के लिए ब्राउज़र के डेवलपर टूल्स का उपयोग कर सकते हैं।
सारांश तालिका में HTML टैग <table> और CSS classes "infobox" और "vevent" हैं, इसलिए आप इनका उपयोग HTML में तालिका की पहचान करने के लिए कर सकते हैं।
इन आर्गुमेंट्स के साथ निर्दिष्ट करें:
"table"औरclass_="infobox vevent"
find_all() उन सभी एलिमेंट्स की एक सूची लौटाता है जो मानदंड से मेल खाते हैं। वास्तव में उस एलिमेंट को निर्दिष्ट करने के लिए जिसमें आप रुचि रखते हैं, इंडेक्स [0] जोड़ें। यदि फ़ंक्शन सफल होता है, तो यह table ऑब्जेक्ट लौटाता है। अन्यथा, यह None लौटाता है।
किसी भी स्वचालित डेटा संग्रह प्रक्रिया के साथ, अपवादों को अच्छी तरह से संभालना हमेशा महत्वपूर्ण होता है। यदि नहीं, तो सर्वोत्तम स्थिति में स्क्रिप्ट क्रैश हो जाएगी और आपको शुरू से शुरुआत करनी होगी।
सबसे खराब स्थिति में, आप असंगतियों और त्रुटियों से भरे डेटा सेट के साथ समाप्त होंगे। इससे बाद में काम करना एक बुरा सपना बन जाएगा।
मेटाडेटा पुनः प्राप्त करना
अगला फ़ंक्शन table ऑब्जेक्ट का उपयोग करके कुछ मेटाडेटा की तलाश करता है। यहां, यह तालिका में उस वर्ष को खोजता है जब भाषा पहली बार दिखाई दी।
def getYear(t): try: t = t.get_text() year = t[t.find("appear"):t.find("appear")+30] year = re.match(r'.*([1-3][0-9]{3})',year).group(1) return int(year) except: return "Could not determine"यह छोटा फ़ंक्शन table ऑब्जेक्ट को अपने आर्गुमेंट के रूप में लेता है, और BeautifulSoup के get_text() फ़ंक्शन का उपयोग करके एक स्ट्रिंग उत्पन्न करता है।
अगला कदम year नामक एक सबस्ट्रिंग बनाना है। यह शब्द "appear" की पहली उपस्थिति के बाद के 30 वर्ण लेता है। इस स्ट्रिंग में भाषा के पहली बार प्रकट होने का वर्ष होना चाहिए।
सिर्फ वर्ष निकालने के लिए, re मॉड्यूल के सौजन्य से एक रेगुलर एक्सप्रेशन का उपयोग करें जो 1 और 3 के बीच एक अंक से शुरू होने वाले और तीन अंकों द्वारा अनुसरण किए गए किसी भी वर्ण से मेल खाता है।
re.match(r'.*([1-3][0-9]{3})',year)यदि यह सफल होता है, तो फ़ंक्शन year को एक पूर्णांक के रूप में लौटाता है। अन्यथा, यह एक दयनीय दिखने वाला "Could not determine" लौटाता है। आप आगे मेटाडेटा स्क्रैप करना चाह सकते हैं — जैसे पैराडाइम, डिजाइनर या टाइपिंग डिसिप्लिन।
लिंक्स एकत्र करना
आपके लिए एक और फ़ंक्शन — इस बार, आप एक दी गई भाषा के लिए table ऑब्जेक्ट को फीड करेंगे, और उम्मीद है कि अन्य प्रोग्रामिंग लैंग्वेजेज की एक सूची प्राप्त करेंगे।
def getLinks(t): try: table_rows = t.find_all("tr") for i in range(0,len(table_rows)-1): try: if table_rows[i].get_text() == "\nInfluenced\n": out = [] for j in table_rows[i+1].find_all("a"): try: out.append(j['title']) except: continue return out except: continue return except: returnवाह, उस सभी नेस्टिंग को देखें… वास्तव में क्या हो रहा है?
यह फ़ंक्शन इस तथ्य का उपयोग करता है कि table ऑब्जेक्ट्स में एक सुसंगत संरचना होती है। तालिका में जानकारी पंक्तियों में संग्रहीत होती है (प्रासंगिक HTML टैग <tr> )। इन पंक्तियों में से एक में `` टेक्स्ट "\nInfluenced\n" होगा। फ़ंक्शन का पहला भाग ढूंढता है कि यह कौन सी पंक्ति है।
एक बार यह पंक्ति मिल जाने पर, आप अगली पंक्ति में वर्तमान द्वारा प्रभावित प्रत्येक प्रोग्रामिंग लैंग्वेज के लिंक्स होने के बारे में काफी निश्चित हो सकते हैं। find_all("a") का उपयोग करके इन लिंक्स को खोजें — जहां आर्गुमेंट "a" HTML टैग <a> से मेल खाता है।
प्रत्येक लिंक j के लिए, इसके ["title"] एट्रिब्यूट को out नामक सूची में जोड़ें। ["title"] एट्रिब्यूट में रुचि होने का कारण यह है कि यह सटीक रूप से उस भाषा के नाम से मेल खाएगा जैसा nodes में संग्रहीत है।
उदाहरण के लिए, Java को nodes में "Java (programming language)" के रूप में संग्रहीत किया जाता है, इसलिए आपको पूरे डेटा सेट में इस सटीक नाम का उपयोग करने की आवश्यकता है।
यदि सफल होता है, तो getLinks() प्रोग्रामिंग लैंग्वेजेज की एक सूची लौटाता है। फ़ंक्शन का बाकी हिस्सा अपवाद प्रबंधन से संबंधित है, यदि किसी भी चरण में कुछ गलत हो जाता है।
डेटा एकत्र करना
आखिरकार, आप लगभग बैठकर स्क्रिप्ट को अपना काम करने देने के लिए तैयार हैं। यह डेटा एकत्र करेगा और इसे दो सूची ऑब्जेक्ट्स में संग्रहीत करेगा।
edgeList = [["Source,Target"]] meta = [["Id","Year"]]अब एक लूप लिखें जो nodes में प्रत्येक आइटम पर पहले परिभाषित फ़ंक्शन्स को लागू करेगा, और आउटपुट को edgeList और meta में संग्रहीत करेगा।
for n in nodes: try: temp = getSoup(n) except: continue try: influenced = getLinks(temp) for link in influenced: if link in nodes: edgeList.append([n+","+link]) print([n+","+link]) except: continue year = getYear(temp) meta.append([n,year])यह फ़ंक्शन nodes में प्रत्येक भाषा को लेता है और उसके Wikipedia पेज से सारांश तालिका प्राप्त करने का प्रयास करता है।
फिर, यह तालिका में सूचीबद्ध सभी भाषाओं को प्राप्त करता है जिन्हें प्रश्न में भाषा द्वारा प्रभावित किया गया है।
प्रत्येक भाषा के लिए जो nodes सूची में भी दिखाई देती है, ["source,target"] के रूप में edgeList में एक तत्व जोड़ें। इस तरह, आप Gephi में फीड करने के लिए एक एज लिस्ट बनाएंगे।
डीबगिंग उद्देश्यों के लिए, edgeList में जोड़े गए प्रत्येक तत्व को प्रिंट करें — बस यह सुनिश्चित करने के लिए कि सब कुछ जैसा होना चाहिए वैसा ही काम कर रहा है। यदि आप अतिरिक्त गहन थे, तो आप except क्लॉज में प्रिंट स्टेटमेंट्स भी जोड़ सकते हैं।
अगला, भाषा का नाम और वर्ष प्राप्त करें, और इन्हें meta सूची में जोड़ें।
CSV में लिखना
एक बार लूप चल जाने के बाद, अंतिम चरण edgeList और meta की सामग्री को कॉमा सेपरेटेड वैल्यू (CSV) फ़ाइलों में लिखना है। यह पहले इम्पोर्ट किए गए csv मॉड्यूल के साथ आसानी से किया जाता है।
with open("edge_list.csv","w") as f: wr = csv.writer(f) for e in edgeList: wr.writerow(e) with open("metadata.csv","w") as f2: wr = csv.writer(f2) for m in meta: wr.writerow(m)हो गया! स्क्रिप्ट को सेव करें, और टर्मिनल से चलाएं:
$ python3 script.py
आपको स्क्रिप्ट को एज लिस्ट बनाते हुए प्रत्येक सोर्स-टार्गेट जोड़ी को प्रिंट करते हुए देखना चाहिए। सुनिश्चित करें कि आपका इंटरनेट कनेक्शन स्थिर है, और बैठकर स्क्रिप्ट को अपना जादू करते हुए देखें।
चरण 3 — Gephi के साथ ग्राफ निर्माण
उम्मीद है कि आपने पहले Gephi इंस्टॉल और चालू कर लिया था। अब आप एक नया प्रोजेक्ट बना सकते हैं और आपके द्वारा एकत्र किए गए डेटा का उपयोग करके एक डायरेक्टेड ग्राफ बना सकते हैं। यह दिखाएगा कि विभिन्न प्रोग्रामिंग लैंग्वेजेज ने एक-दूसरे को कैसे प्रभावित किया है!
Gephi में एक नया प्रोजेक्ट बनाकर शुरू करें, और "Data Laboratory" व्यू पर स्विच करें। यह Gephi में डेटा को संभालने के लिए एक स्प्रेडशीट-जैसा इंटरफेस प्रदान करता है। करने वाली पहली बात एज लिस्ट को इम्पोर्ट करना है।
- "Import spreadsheet" पर क्लिक करें।
- Python स्क्रिप्ट द्वारा उत्पन्न
edge_list.csvफ़ाइल चुनें। सुनिश्चित करें कि Gephi कॉमा को सेपरेटर के रूप में उपयोग करना जानता है। - List type से "Edge List" चुनें।
- "Next" पर क्लिक करें और जांचें कि आप Source और Target दोनों कॉलम को स्ट्रिंग्स के रूप में इम्पोर्ट कर रहे हैं।
यह डेटा लैब को नोड्स की एक सूची के साथ अपडेट करना चाहिए। अब, metadata.csv फ़ाइल इम्पोर्ट करें। इस बार, List type से "Nodes list" चुनना सुनिश्चित करें।
"Preview" टैब पर स्विच करें, और देखें कि नेटवर्क कैसा दिखता है।
आह… यह बस थोड़ा सा… मोनोक्रोम है। और गन्दा। स्पेगेटी की एक प्लेट की तरह। आइए इसे ठीक करें।
इसे सुंदर बनाना
प्रस्तुति पर काम करने के सभी प्रकार के तरीके हैं, और यहां थोड़ी रचनात्मक स्वतंत्रता आती है। नेटवर्क विज़ुअलाइज़ेशन के साथ, अनिवार्य रूप से तीन चीजें हैं जिन पर विचार करना है:
- पोजिशनिंग कई एल्गोरिदम हैं जो एक नेटवर्क के लिए लेआउट पैटर्न उत्पन्न कर सकते हैं। एक लोकप्रिय विकल्प फ्रूच्टरमैन-रेइंगोल्ड एल्गोरिदम है, जो Gephi में उपलब्ध है।
- आकार ग्राफ में नोड्स का आकार किसी दिलचस्प संपत्ति को प्रस्तुत करने के लिए उपयोग किया जा सकता है। अक्सर, यह एक सेंट्रैलिटी माप होता है। सेंट्रैलिटी मापने के कई तरीके हैं, लेकिन वे सभी नेटवर्क के बाकी हिस्सों से कितनी अच्छी तरह जुड़ा हुआ है, इसके संदर्भ में एक दिए गए नोड के "महत्व" को दर्शाते हैं।
- रंग नोड की किसी संपत्ति को दिखाने के लिए रंग का उपयोग करना भी संभव है। अक्सर, रंग का उपयोग कम्युनिटी स्ट्रक्चर को इंगित करने के लिए किया जाता है। इसे मोटे तौर पर "नोड्स का एक समूह जो शेष ग्राफ की तुलना में एक-दूसरे से अधिक जुड़े हुए हैं" के रूप में परिभाषित किया गया है। सोशल नेटवर्क में, यह दोस्ती, परिवार या पेशेवर समूहों को प्रकट कर सकता है। कम्युनिटी स्ट्रक्चर का पता लगाने के कई एल्गोरिदम हैं। Gephi लुवेन विधि के साथ अंतर्निहित आता है।
ये परिवर्तन करने के लिए, आपको कुछ आंकड़ों की गणना करने की आवश्यकता होगी। "Overview" विंडो पर स्विच करें। यहां आप दाईं ओर एक पैनल देखेंगे। इसमें एक "Statistics" टैब होना चाहिए। इसे खोलें, और आप विकल्पों की एक श्रृंखला देखेंगे।
Gephi कई अंतर्निहित सांख्यिकीय क्षमताओं के साथ आता है। उनमें से प्रत्येक के लिए, "Run" पर क्लिक करने से एक रिपोर्ट उत्पन्न होगी जो नेटवर्क के बारे में अंतर्दृष्टि प्रकट करेगी।
जानने के लिए कुछ उपयोगी हैं:
- औसत डिग्री औसत भाषा लगभग चार अन्य से जुड़ी होती है। रिपोर्ट एक डिग्री वितरण ग्राफ भी दिखाती है। यह प्रकट करता है कि अधिकांश भाषाओं के बहुत कम कनेक्शन हैं, जबकि एक छोटे अनुपात में कई हैं। यह सुझाव देता है कि यह एक स्केल-फ्री नेटवर्क है। स्केल-फ्री नेटवर्क पर बहुत शोध किया गया है, और वे प्रक्रियाएं जो उन्हें उत्पन्न करती हैं।
- डायमीटर इस नेटवर्क का डायमीटर 12 है — अर्थात यह किन्हीं दो भाषाओं के बीच कनेक्शन की "सबसे चौड़ी" संख्या है। औसत पथ लंबाई चार से थोड़ी कम है। इसका मतलब है कि, औसतन, किन्हीं दो भाषाओं को चार एजेस द्वारा अलग किया जाता है। ये आंकड़े नेटवर्क के "आकार" का माप देते हैं।
- मॉड्यूलैरिटी यह एक स्कोर है जो दिखाता है कि नेटवर्क कितना "कम्पार्टमेंटलाइज़्ड" है। यहां, मॉड्यूलैरिटी स्कोर लगभग 0.53 है। यह अपेक्षाकृत उच्च है, सुझाव देता है कि इस नेटवर्क के भीतर अलग-अलग मॉड्यूल हैं। फिर से, यह अंतर्निहित प्रणाली के बारे में कुछ दिलचस्प इंगित करता है। भाषाएं अलग-अलग "इन्फ्लुएंस ग्रुप्स" में गिरती हैं।
किसी भी तरह, नेटवर्क की उपस्थिति को संशोधित करने के लिए, बाएं पैनल पर जाएं।
"Layout" टैब में, आप चुन सकते हैं कि किस लेआउट एल्गोरिदम का उपयोग करना है। "Run" दबाएं और ग्राफ को रीयल-टाइम में शिफ्ट होते हुए देखें! देखें कि आपको कौन सा लेआउट एल्गोरिदम सबसे अच्छा लगता है।
Layout टैब के ऊपर "Appearance" टैब है। यहां, आप नोड और एज रंगों, आकारों और लेबल्स के लिए विभिन्न सेटिंग्स के साथ खेल सकते हैं। इन्हें एट्रिब्यूट्स (आपके द्वारा Gephi से गणना कराए गए आंकड़ों सहित) के आधार पर कॉन्फिगर किया जा सकता है।
एक सुझाव के रूप में, आप कर सकते हैं:
- उनके मॉड्यूलैरिटी एट्रिब्यूट द्वारा नोड्स को रंगें। यह उन्हें उनकी कम्युनिटी सदस्यता के अनुसार रंगता है।
- उनकी डिग्री द्वारा नोड्स का आकार दें। बेहतर जुड़े नोड्स कम जुड़े हुए की तुलना में बड़े दिखाई देंगे।
हालांकि, आपको प्रयोग करना चाहिए और एक लेआउट लेकर आना चाहिए जो आपको सबसे अच्छा लगे।
एक बार जब आप अपने ग्राफ की उपस्थिति से खुश हो जाते हैं, तो अंतिम चरण — वेब पर निर्यात करने पर जाने का समय है!
चरण 4 — Sigma.js
आपके पास पहले से ही एक नेटवर्क विज़ुअलाइज़ेशन है जिसे Gephi में एक्सप्लोर किया जा सकता है। आप एक स्क्रीनशॉट लेना चुन सकते हैं, या ग्राफ को SVG, PDF या PNG फॉर्मेट में सेव कर सकते हैं।
हालांकि, यदि आपने पहले Sigma.js प्लगइन इंस्टॉल किया था, तो ग्राफ को HTML में निर्यात क्यों नहीं करते? यह एक इंटरैक्टिव विज़ुअलाइज़ेशन बनाएगा जिसे आप ऑनलाइन होस्ट कर सकते हैं, या GitHub पर अपलोड करके दूसरों के साथ साझा कर सकते हैं।
ऐसा करने के लिए, Gephi के मेनू बार से "Export > Sigma.js template…" चुनें।
आवश्यकतानुसार विवरण भरें। वह डायरेक्टरी चुनना सुनिश्चित करें जिसमें आप प्रोजेक्ट को निर्यात करते हैं। आप शीर्षक, लीजेंड, विवरण, होवर व्यवहार और कई अन्य विवरण बदल सकते हैं। जब आप तैयार हों, तो "OK" पर क्लिक करें।
अब, यदि आप उस डायरेक्टरी पर नेविगेट करते हैं जिसमें आपने प्रोजेक्ट निर्यात किया था, तो आपको Sigma.js द्वारा उत्पन्न सभी फ़ाइलों वाला एक फ़ोल्डर दिखाई देगा।
अपने पसंदीदा ब्राउज़र में index.html खोलें। ता-दा! वहां आपका नेटवर्क है! यदि आप थोड़ा CSS और JavaScript जानते हैं, तो आप आउटपुट को अपनी इच्छानुसार ट्वीक करने के लिए विभिन्न उत्पन्न फ़ाइलों में गोता लगा सकते हैं।
और यह इस ट्यूटोरियल का समापन करता है!
सारांश
- कई सिस्टम्स को नेटवर्क के रूप में मॉडल और विज़ुअलाइज़ किया जा सकता है। ग्राफ थ्योरी गणित की एक शाखा है जो नेटवर्क संरचनाओं और गुणों को समझने में मदद करने के लिए उपकरण प्रदान करती है।
- आपने Wikipedia से डेटा स्क्रैप करके प्रोग्रामिंग लैंग्वेज इन्फ्लुएंस ग्राफ बनाने के लिए Python का उपयोग किया। लिंकेज क्राइटेरियन यह था कि क्या दी गई भाषा को किसी अन्य के डिजाइन पर प्रभाव के रूप में सूचीबद्ध किया गया था।
- Gephi और Sigma.js ओपन-सोर्स टूल्स हैं जो आपको नेटवर्क का विश्लेषण और विज़ुअलाइज़ करने की अनुमति देते हैं। वे आपको नेटवर्क को इमेज, PDF या वेब फॉर्मेट में निर्यात करने की अनुमति देते हैं।
पढ़ने के लिए धन्यवाद — मैं आपके किसी भी टिप्पणी या प्रश्न की प्रतीक्षा करता हूं! ग्राफ थ्योरी के बारे में अधिक जानने के लिए एक शानदार संसाधन के लिए, Albert-László Barabási की इंटरैक्टिव ऑनलाइन किताब देखें।
इस ट्यूटोरियल का पूरा कोड यहां पाया जा सकता है।