पायथन एक बहुत बहुमुखी भाषा है क्योंकि यह विभिन्न आवश्यकताओं पर काम करने के लिए लाइब्रेरीज़ का एक बड़ा सेट प्रदान करता है। हम सभी पोर्टेबल डॉक्यूमेंट फॉर्मेट (PDF) फाइल्स पर काम करते हैं। पायथन PDF फाइलों के साथ काम करने के विभिन्न तरीके प्रदान करता है। इसमें हम पायथन लाइब्रेरी PyPDF2 का उपयोग करके PDF फाइल के साथ काम करने जा रहे हैं।
PyPDF2 एक प्योर-पायथन PDF लाइब्रेरी है जो PDF फाइलों के पेजों को विभाजित, मर्ज, क्रॉप और ट्रांसफॉर्म करने में सक्षम है। यह PDF फाइलों में कस्टम डेटा, व्यूइंग ऑप्शन और पासवर्ड भी जोड़ सकता है। यह PDF से टेक्स्ट और मेटाडेटा भी प्राप्त कर सकता है और पूरी फाइलों को एक साथ मर्ज कर सकता है।
चूंकि हम PyPDF2 के साथ PDFs पर कई ऑपरेशन कर सकते हैं, इसलिए यह स्विस-आर्मी नाइफ की तरह काम करता है।
शुरुआत करना
क्योंकि PyPDF2 एक स्टैंडर्ड पायथन पैकेज है, इसलिए हमें इसे इंस्टॉल करने की आवश्यकता है। अच्छी बात यह है कि यह बहुत आसान है, हम इसे इंस्टॉल करने के लिए pip का उपयोग कर सकते हैं। बस अपने कमांड टर्मिनल पर नीचे दी गई कमांड चलाएं:
C:\Users\rajesh>pip install pypdf2
Collecting pypdf2
Downloading https://files.pythonhosted.org/packages/b4/01/68fcc0d43daf4c6bdbc6b33cc3f77bda531c86b174cac56ef0ffdb96faab/PyPDF2-1.26.0.tar.gz (77kB)
100% |████████████████████████████████| 81kB 83kB/s
Building wheels for collected packages: pypdf2
Building wheel for pypdf2 (setup.py) ... done
Stored in directory: C:\Users\rajesh\AppData\Local\pip\Cache\wheels\53\84\19\35bc977c8bf5f0c23a8a011aa958acd4da4bbd7a229315c1b7
Successfully built pypdf2
Installing collected packages: pypdf2
Successfully installed pypdf2-1.26.0
सत्यापित करने के लिए, पायथन शेल से pypdf2 इम्पोर्ट करें:
>>> import PyPDF2
>>> Successful, Great.
मेटाडेटा निकालना
हम किसी भी PDF से कुछ महत्वपूर्ण उपयोगी डेटा निकाल सकते हैं। उदाहरण के लिए, हम डॉक्यूमेंट के लेखक, उसके शीर्षक, विषय और PDF फाइल में निहित पेजों की संख्या की जानकारी निकाल सकते हैं।
नीचे PyPDF2 पैकेज का उपयोग करके PDF फाइल से उपयोगी जानकारी निकालने का पायथन प्रोग्राम है।
from PyPDF2 import PdfFileReader

def extract_pdfMeta(path):
    with open(path, 'rb') as f:
        pdf = PdfFileReader(f)
        info = pdf.getDocumentInfo()
        number_of_pages = pdf.getNumPages()
    print("Author: \t", info.author)
    print()
    print("Creator: \t", info.creator)
    print()
    print("Producer: \t", info.producer)
    print()
    print("Subject: \t", info.subject)
    print()
    print("Title: \t", info.title)
    print()
    print("Number of Pages in pdf: \t", number_of_pages)

if __name__ == '__main__':
    path = 'DeepLearning.pdf'
    extract_pdfMeta(path)
आउटपुट
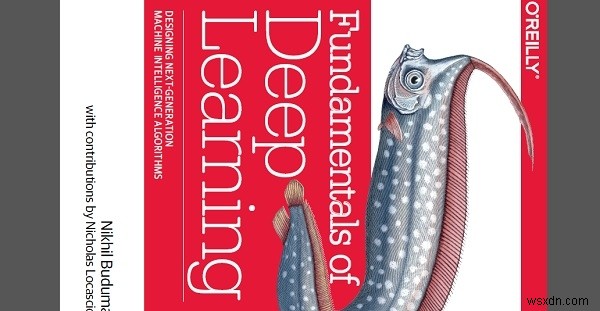
Author: Nikhil Buduma,Nicholas Locascio
Creator: AH CSS Formatter V6.2 MR4 for Linux64 : 6.2.6.18551 (2014/09/24 15:00JST)
Producer: Antenna House PDF Output Library 6.2.609 (Linux64)
Subject: None
Title: Fundamentals of Deep Learning
Number of Pages in pdf: 298
तो PDF फाइल्स खोले बिना, हम PDF फाइल से कुछ उपयोगी जानकारी प्राप्त करने में सक्षम हैं।
PDF से टेक्स्ट निकालना
हम PDFs से टेक्स्ट निकाल सकते हैं। हालांकि इसमें इमेजेज निकालने के लिए बिल्ट-इन सपोर्ट नहीं है।
आइए ऊपर डाउनलोड की गई PDF फाइल के एक विशेष पेज (उदाहरण के लिए: पेज 50) से टेक्स्ट निकालने का प्रयास करें।
from PyPDF2 import PdfFileReader

def extract_pdfText(path):
    with open(path, 'rb') as f:
        pdf = PdfFileReader(f)
        # 50वां पेज प्राप्त करें
        page = pdf.getPage(50)
        print(page)
        print('Page type: {}'.format(str(type(page))))
        # 50वें पेज से टेक्स्ट निकालें
        text = page.extractText()
        print(text)

if __name__ == '__main__':
    path = 'DeepLearning.pdf'
    extract_pdfText(path)
आउटपुट
{'/Annots': IndirectObject(1421, 0), '/Contents': IndirectObject(179, 0), '/CropBox': [0, 0, 595.3, 841.9], '/Group': {'/CS': '/DeviceRGB', '/S': '/Transparency', '/Type': '/Group'}, '/MediaBox': [0, 0, 504, 661.5], '/Parent': IndirectObject(4863, 0), '/Resources': IndirectObject(1423, 0), '/Rotate': 0, '/Type': '/Page' }
Page type:
time. In inverted dropout, any neuron whose activation hasn't been silenced has its output divided by p before the value is propagated to the next layer. With this fix, Eoutput=p/xp+1(x) p/0= x, and we can avoid arbitrarily scaling neuronal output at test time. SummaryIn this chapter, we've learned all of the basics involved in training feed-forward neural networks. We've talked about gradient descent, the backpropagation algorithm, as well as various methods we can use to prevent overfitting. In the next chapter, we'll put these lessons into practice when we use the TensorFlow library to efficiently implement our first neural networks. Then in Chapter 4, we'll return to the problem of optimizing objective functions for training neural networks and design algorithmsto significantly improve performance. These improvements will enable us to process much more data, which means we'll be able to build more comprehensive models. Summary | 37
हालांकि हम पेज 50 से कुछ टेक्स्ट प्राप्त करने में सक्षम हैं लेकिन यह उतना साफ नहीं है। दुर्भाग्य से, PyPDF2 का PDFs से टेक्स्ट निकालने के लिए बहुत सीमित सपोर्ट है।
PDF फाइल के विशेष पेज को घुमाना
>>> import PyPDF2
>>> deeplearningFile = open('DeepLearning.pdf', 'rb')
>>> pdfReader = PyPDF2.PdfFileReader(deeplearningFile)
>>> page = pdfReader.getPage(0)
>>> page.rotateClockwise(90)
{ '/Contents': [IndirectObject(4870, 0), IndirectObject(4871, 0), ...], '/CropBox': [0, 0, 595.3, 841.9], '/MediaBox': [0, 0, 504, 661.5], '/Parent': IndirectObject(4862, 0), '/Resources': IndirectObject(4889, 0), '/Rotate': 90, '/Type': '/Page' }
>>> pdfWriter = PyPDF2.PdfFileWriter()
>>> pdfWriter.addPage(page)
>>> resultPdfFile = open('rotatedPage.pdf', 'wb')
>>> pdfWriter.write(resultPdfFile)
>>> resultPdfFile.close()
>>> deeplearningFile.close()
आउटपुट