सांख्यिकी ML और AI सीखने के लिए मौलिक है। चूंकि पायथन इन टेक्नोलॉजीज के लिए पसंद की भाषा है, हम देखेंगे कि सांख्यिकीय विश्लेषण को शामिल करने वाले पायथन प्रोग्राम कैसे लिखें। इस लेख में हम देखेंगे कि विभिन्न पायथन मॉड्यूल्स का उपयोग करके ग्राफ और चार्ट कैसे बनाएं। चार्ट की यह विविधता हमें डेटा का तेजी से विश्लेषण करने और निष्कर्ष ग्राफिकल रूप से निकालने में मदद करती है।
डेटा तैयारी
हम विभिन्न बीजों के बारे में डेटा वाले डेटासेट को लेते हैं। यह डेटासेट कागल पर नीचे दिए गए प्रोग्राम में दिखाए गए लिंक पर उपलब्ध है। इसमें आठ कॉलम हैं जिनका उपयोग विभिन्न प्रकार के चार्ट बनाने के लिए विभिन्न बीजों की विशेषताओं की तुलना के लिए किया जाएगा। नीचे दिया गया प्रोग्राम डेटासेट को स्थानीय वातावरण से लोड करता है और पंक्तियों का एक नमूना प्रदर्शित करता है।
उदाहरण
import pandas as pd
import warnings
warnings.filterwarnings("ignore")
datainput = pd.read_csv('E:\\seeds.csv')
# https://www.kaggle.com/jmcaro/wheat-seedsuci
print(datainput)
आउटपुट
उपरोक्त कोड चलाने से हमें निम्न परिणाम मिलता है -
    Area  Perimeter  Compactness ...  Asymmetry.Coeff  Kernel.Groove  Type
0  15.26      14.84       0.8710 ...           2.221          5.220     1
1  14.88      14.57       0.8811 ...           1.018          4.956     1
2  14.29      14.09       0.9050 ...           2.699          4.825     1
3  13.84      13.94       0.8955 ...           2.259          4.805     1
4  16.14      14.99       0.9034 ...           1.355          5.175     1
..   ...        ...          ... ...            ...            ...   ...
194 12.19      13.20       0.8783 ...           3.631          4.870     3
195 11.23      12.88       0.8511 ...           4.325          5.003     3
196 13.20      13.66       0.8883 ...           8.315          5.056     3
197 11.84      13.21       0.8521 ...           3.598          5.044     3
198 12.30      13.34       0.8684 ...           5.637          5.063     3
[199 rows x 8 columns]
हिस्टोग्राम बनाना
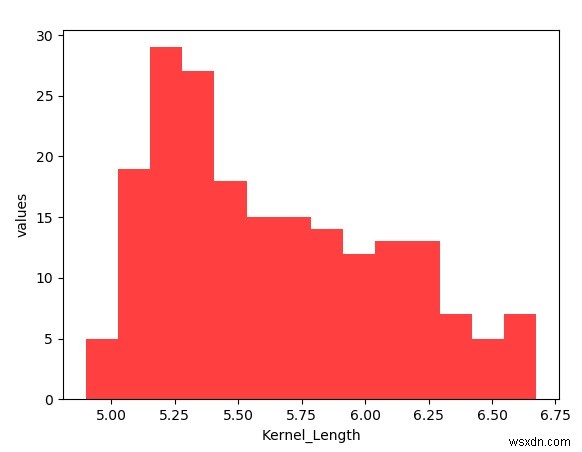
हिस्टोग्राम बनाने के लिए हम CSV फाइल से हेडर पंक्ति को हटाते हैं और फाइल को नम्पी ऐरे के रूप में पढ़ते हैं। फिर हम फाइल पढ़ने के लिए genfromtxt मॉड्यूल का उपयोग करते हैं। कर्नेल लंबाई फील्ड ऐरे में कॉलम इंडेक्स 3 पर स्थित है। अंत में हम नम्पी द्वारा बनाए गए डेटासेट का उपयोग करके matplotlib से हिस्टोग्राम प्लॉट करते हैं और आवश्यक लेबल भी लागू करते हैं।
उदाहरण
import matplotlib.pyplot as plot
import numpy as np
from numpy import genfromtxt
seed_data = genfromtxt('E:\\seeds.csv', delimiter=',')
Kernel_Length = seed_data[:, [3]]
x = len(Kernel_Length)
y = np.sqrt(x)
y = int(y)
z = plot.hist(Kernel_Length, bins=y, color='#FF4040')
z = plot.xlabel('Kernel_Length')
z = plot.ylabel('values')
plot.show()
आउटपुट
उपरोक्त कोड चलाने से हमें निम्न परिणाम मिलता है -
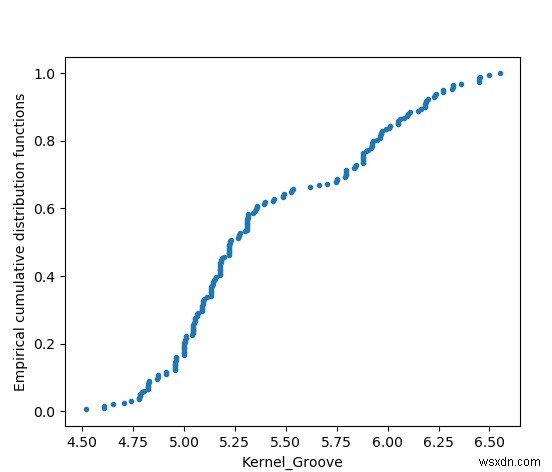
एम्पिरिकल क्यूमुलेटिव डिस्ट्रीब्यूशन फंक्शन्स
यह चार्ट डेटासेट में वितरित कर्नेल ग्रूव आकार का प्लॉट दिखाता है। इसे न्यूनतम से अधिकतम मूल्य तक व्यवस्थित किया जाता है और इसे वितरण के रूप में दिखाया जाता है।
उदाहरण
import matplotlib.pyplot as plot
import numpy as np
from numpy import genfromtxt
seed_data = genfromtxt('E:\\seeds.csv', delimiter=',')
Kernel_groove = seed_data[:, 6]
def ECDF(seed_data):  # एम्पिरिकल क्यूमुलेटिव डिस्ट्रीब्यूशन फंक्शन्स
    i = len(seed_data)
    m = np.sort(seed_data)
    n = np.arange(1, i + 1) / i
    return m, n
m, n = ECDF(Kernel_groove)
plot.plot(m, n, marker='.', linestyle='none')
plot.xlabel('Kernel_Groove')
plot.ylabel('Empirical cumulative distribution functions')
plot.show()
आउटपुट
उपरोक्त कोड चलाने से हमें निम्न परिणाम मिलता है -
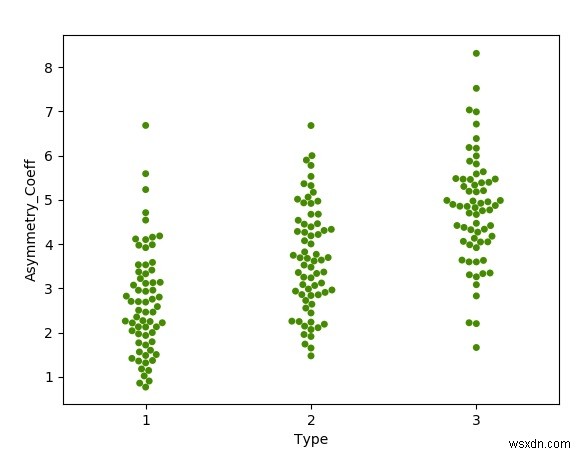
बी स्वार्म प्लॉट्स
एक बीस्वार्म प्लॉट डेटा बिंदुओं के एक समूह के आकार को प्रत्येक व्यक्तिगत डेटा बिंदु को दृश्य रूप से क्लस्टर करके दिखाता है। हम इस ग्राफ को बनाने के लिए seaborn लाइब्रेरी का उपयोग करते हैं। हम डेटासेट से Type कॉलम का उपयोग करके समान प्रकार के बीजों को एक साथ क्लस्टर करते हैं।
उदाहरण
import pandas as pd
import matplotlib.pyplot as plot
import seaborn as sns
datainput = pd.read_csv('E:\\seeds.csv')
sns.swarmplot(x='Type', y='Asymmetry.Coeff', data=datainput, color='#458B00')  # बी स्वार्म प्लॉट
plot.xlabel('Type')
plot.ylabel('Asymmetry_Coeff')
plot.show()
आउटपुट
उपरोक्त कोड चलाने से हमें निम्न परिणाम मिलता है -