मशीन लर्निंग में कई प्रकार के क्लस्टरिंग एल्गोरिदम होते हैं। इन एल्गोरिदम को पायथन में लागू किया जा सकता है। इस लेख में, आइए 'मीन-शिफ्ट' एल्गोरिदम पर चर्चा करें और इसे पायथन का उपयोग करके लागू करें। यह एक क्लस्टरिंग एल्गोरिदम है जिसका उपयोग अनसुपरवाइज़्ड लर्निंग मेथड के रूप में किया जाता है।
इस एल्गोरिदम में, कोई धारणा नहीं बनाई जाती है। इसका तात्पर्य है कि यह एक नॉन-पैरामीट्रिक एल्गोरिदम है। यह एल्गोरिदम डेटा पॉइंट्स को कुछ क्लस्टर्स को पुनरावृत्त रूप से असाइन करता है, जो इन डेटा पॉइंट्स को डेटा पॉइंट्स के उच्चतम घनत्व की ओर शिफ्ट करके किया जाता है।
डेटा पॉइंट्स का यह उच्च घनत्व क्लस्टर के सेंट्रॉइड के रूप में जाना जाता है। मीन शिफ्ट एल्गोरिदम और K मीन्स क्लस्टरिंग के बीच अंतर यह है कि पूर्व में (K-मीन्स) क्लस्टर्स की संख्या को पहले से निर्दिष्ट करने की आवश्यकता होती है।
ऐसा इसलिए है क्योंकि क्लस्टर्स की संख्या मौजूद डेटा के आधार पर K मीन्स एल्गोरिदम की मदद से पाई जाती है।
आइए मीन-शिफ्ट एल्गोरिदम के चरणों को समझते हैं:
डेटा पॉइंट्स को अपने स्वयं के क्लस्टर को असाइन किया जाता है।
फिर, इन क्लस्टर्स के सेंट्रॉइड्स निर्धारित किए जाते हैं।
इन सेंट्रॉइड्स का स्थान पुनरावृत्त रूप से अपडेट किया जाता है।
अगला, प्रक्रिया उच्च घनत्व क्षेत्रों की ओर बढ़ती है।
एक बार जब सेंट्रॉइड्स ऐसी स्थिति में पहुंच जाते हैं जहां वे आगे नहीं बढ़ सकते, तो प्रक्रिया रुक जाती है।
आइए समझते हैं कि इसे पायथन में, scikit-learn का उपयोग करके कैसे लागू किया जा सकता है:
उदाहरण
import numpy as np
from sklearn.cluster import MeanShift
import matplotlib.pyplot as plt
from matplotlib import style
style.use("ggplot")
from sklearn.datasets.samples_generator import make_blobs

centers = [[3,3,1],[4,5,5],[11,10,10]]
X, _ = make_blobs(n_samples=950, centers=centers, cluster_std=0.89)
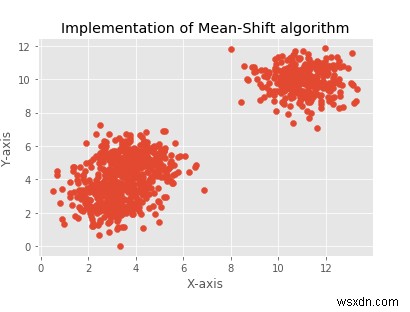
plt.title("मीन-शिफ्ट एल्गोरिदम का कार्यान्वयन")
plt.xlabel("X-अक्ष")
plt.ylabel("Y-अक्ष")
plt.scatter(X[:,0], X[:,1])
plt.show()

ms = MeanShift()
ms.fit(X)
labels = ms.labels_
clusterCent = ms.cluster_centers_
print(clusterCent)
numCluster = len(np.unique(labels))
print("अनुमानित क्लस्टर्स:", numCluster)

colors = 10*['r.','g.','b.','c.','k.','y.','m.']
for i in range(len(X)):
    plt.plot(X[i][0], X[i][1], colors[labels[i]], markersize=3)
plt.scatter(clusterCent[:,0], clusterCent[:,1],
    marker=".", color='k', s=20, linewidths=5, zorder=10)
plt.show()
आउटपुट
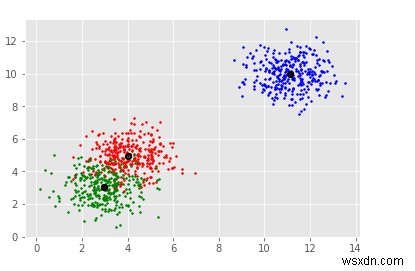
[[ 3.05250924  3.03734994  1.06159541]
 [ 3.92913017  4.99956874  4.86668482]
 [10.99127523 10.02361122 10.00084718]]
अनुमानित क्लस्टर्स: 3
व्याख्या
आवश्यक पैकेज इम्पोर्ट किए जाते हैं और उपयोग में आसानी के लिए उनका उपनाम परिभाषित किया जाता है।
'style' क्लास में मौजूद 'use' फ़ंक्शन को 'ggplot' निर्दिष्ट किया जाता है।
डेटा के क्लस्टर बनाने के लिए 'make_blobs' फ़ंक्शन का उपयोग किया जाता है।
set_xlabel, set_ylabel और set_title फ़ंक्शन का उपयोग 'X' अक्ष, 'Y' अक्ष और शीर्षक के लिए लेबल प्रदान करने के लिए किया जाता है।
'MeanShift' फ़ंक्शन को कॉल किया जाता है, और एक वेरिएबल को असाइन किया जाता है।
डेटा को मॉडल में फिट किया जाता है।
लेबल और क्लस्टर्स की संख्या परिभाषित की जाती है।
इस डेटा को प्लॉट किया जाता है, और मॉडल में फिट डेटा के लिए स्कैटर प्लॉट भी प्रदर्शित किया जाता है।
'show' फ़ंक्शन का उपयोग करके इसे कंसोल पर दिखाया जाता है।