TensorFlow, Google द्वारा प्रदान किया गया एक मशीन लर्निंग फ्रेमवर्क है। यह एक ओपन-सोर्स फ्रेमवर्क है जिसका उपयोग Python के साथ एल्गोरिदम, डीप लर्निंग एप्लिकेशन और बहुत कुछ लागू करने के लिए किया जाता है। इसका उपयोग अनुसंधान और उत्पादन उद्देश्यों के लिए किया जाता है। इसमें ऑप्टिमाइज़ेशन तकनीकें हैं जो जटिल गणितीय संचालन को तेजी से करने में मदद करती हैं क्योंकि यह NumPy और बहुआयामी सरणियों का उपयोग करता है। इन बहुआयामी सरणियों को 'टेंसर' के रूप में भी जाना जाता है। यह फ्रेमवर्क डीप न्यूरल नेटवर्क के साथ काम करने का समर्थन करता है।
इंस्टॉलेशन
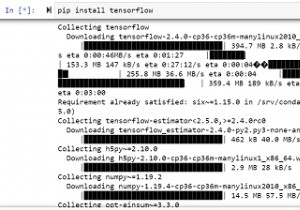
Windows पर 'tensorflow' पैकेज को निम्न कमांड से इंस्टॉल किया जा सकता है:
pip install tensorflow
टेंसर क्या है?
टेंसर TensorFlow में उपयोग की जाने वाली एक डेटा संरचना है। यह फ्लो डायग्राम में एज को जोड़ने में मदद करता है। इस फ्लो डायग्राम को 'डेटा फ्लो ग्राफ' के रूप में जाना जाता है। टेंसर एक बहुआयामी सरणी या सूची के अलावा कुछ नहीं हैं।
Iliad डेटासेट
हम Iliad डेटासेट का उपयोग करेंगे, जिसमें विलियम कूपर, एडवर्ड (डर्बी के अर्ल), और सैमुअल बटलर के तीन अनुवाद कार्यों का टेक्स्ट डेटा होता है। मॉडल को एक पंक्ति टेक्स्ट दिए जाने पर अनुवादक की पहचान करने के लिए प्रशिक्षित किया जाता है। उपयोग की गई टेक्स्ट फाइलें पूर्व-प्रसंस्कृत हैं। इसमें डॉक्यूमेंट हेडर और फूटर, लाइन नंबर और चैप्टर शीर्षक को हटाना शामिल है।
Google Colaboratory का उपयोग
हम नीचे दिए गए कोड को चलाने के लिए Google Colaboratory का उपयोग कर रहे हैं। Google Colab या Colaboratory ब्राउज़र पर Python कोड चलाने में मदद करता है और इसके लिए शून्य कॉन्फ़िगरेशन और GPUs (ग्राफिकल प्रोसेसिंग यूनिट्स) तक मुफ्त पहुंच की आवश्यकता होती है। Colaboratory को Jupyter Notebook के शीर्ष पर बनाया गया है।
कोड उदाहरण
vocab_size += 2
print("Configure the dataset for better performance")
train_data = configure_dataset(train_data)
validation_data = configure_dataset(validation_data)
print("Train the model")
model = create_model(vocab_size=vocab_size, num_labels=3)
model.compile(
    optimizer='adam',
    loss=losses.SparseCategoricalCrossentropy(from_logits=True),
    metrics=['accuracy'])
print("Fit the training data to the model")
history = model.fit(train_data, validation_data=validation_data, epochs=3)
print("Finding the accuracy and loss associated with training")
loss, accuracy = model.evaluate(validation_data)
print("The loss is : ", loss)
print("The accuracy is : {:2.2%}".format(accuracy))
कोड क्रेडिट: https://www.tensorflow.org/tutorials/load_data/text
आउटपुट
Configure the dataset for better performance
Train the model
Fit the training data to the model
Epoch 1/3
697/697 [==============================] - 35s 17ms/step - loss: 0.6891 - accuracy: 0.6736 - val_loss: 0.3718 - val_accuracy: 0.8404
Epoch 2/3
697/697 [==============================] - 8s 11ms/step - loss: 0.3149 - accuracy: 0.8713 - val_loss: 0.3621 - val_accuracy: 0.8422
Epoch 3/3
697/697 [==============================] - 8s 11ms/step - loss: 0.2165 - accuracy: 0.9162 - val_loss: 0.4002 - val_accuracy: 0.8404
Finding the accuracy and loss associated with training
79/79 [==============================] - 1s 2ms/step - loss: 0.4002 - accuracy: 0.8404
The loss is : 0.40021833777427673
The accuracy is : 84.04%
व्याख्या
मॉडल को पूर्व-प्रसंस्कृत, वेक्टराइज़्ड डेटासेट पर प्रशिक्षित किया जाता है।
एक बार यह हो जाने के बाद, इसे संकलित किया जाता है और मॉडल में फिट किया जाता है।
'evaluate' विधि का उपयोग करके मॉडल से जुड़े नुकसान और सटीकता का मूल्यांकन किया जाता है।
यह डेटा कंसोल पर प्रदर्शित होता है।