tf.Data डेटासेट में डेटा को शफल करके मॉडल बिल्डिंग पाइपलाइन को कस्टमाइज़ करने में मदद करता है ताकि सभी प्रकार का डेटा समान रूप से वितरित हो जाए (यदि संभव हो)।
और पढ़ें: TensorFlow क्या है और Keras, TensorFlow के साथ मिलकर न्यूरल नेटवर्क कैसे बनाता है?
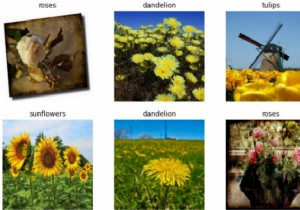
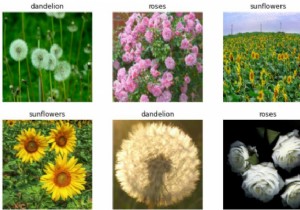
हम फ्लावर्स डेटासेट का उपयोग करेंगे, जिसमें कई हजारों फूलों की छवियां होती हैं। इसमें 5 सब-डायरेक्टरीज हैं, और प्रत्येक क्लास के लिए एक सब-डायरेक्टरी है।
हम नीचे दिए गए कोड को चलाने के लिए Google Colaboratory का उपयोग कर रहे हैं। Google Colab या Colaboratory ब्राउज़र पर Python कोड चलाने में मदद करता है और इसके लिए शून्य कॉन्फ़िगरेशन और GPUs (ग्राफ़िकल प्रोसेसिंग यूनिट्स) तक मुफ्त पहुंच की आवश्यकता होती है। Colaboratory को Jupyter Notebook के ऊपर बनाया गया है।
print("कस्टमाइज़्ड इनपुट पाइपलाइन परिभाषित की जा रही है")
list_ds = tf.data.Dataset.list_files(str(data_dir/'*/'), shuffle=False)
list_ds = list_ds.shuffle(image_count, reshuffle_each_iteration=False)
for f in list_ds.take(5):
    print(f.numpy())
class_names = np.array(sorted([item.name for item in data_dir.glob('*') if item.name != "LICENSE.txt"]))
print(class_names)
print("डेटासेट को ट्रेनिंग और वैलिडेशन सेट में विभाजित किया गया है")
val_size = int(image_count * 0.2)
train_ds = list_ds.skip(val_size)
val_ds = list_ds.take(val_size)
print("प्रत्येक सबसेट की लंबाई नीचे प्रदर्शित है")
print(tf.data.experimental.cardinality(train_ds).numpy())
print(tf.data.experimental.cardinality(val_ds).numpy())
कोड क्रेडिट: https://www.tensorflow.org/tutorials/load_data/images
आउटपुट
कस्टमाइज़्ड इनपुट पाइपलाइन परिभाषित की जा रही है
b'/root/.keras/datasets/flower_photos/dandelion/14306875733_61d71c64c0_n.jpg'
b'/root/.keras/datasets/flower_photos/dandelion/8935477500_89f22cca03_n.jpg'
b'/root/.keras/datasets/flower_photos/sunflowers/3001531316_efae24d37d_n.jpg'
b'/root/.keras/datasets/flower_photos/daisy/7133935763_82b17c8e1b_n.jpg'
b'/root/.keras/datasets/flower_photos/tulips/17844723633_da85357fe3.jpg'
['daisy', 'dandelion', 'roses', 'sunflowers', 'tulips']
डेटासेट को ट्रेनिंग और वैलिडेशन सेट में विभाजित किया गया है
प्रत्येक सबसेट की लंबाई नीचे प्रदर्शित है
2936
734
व्याख्या
- keras.preprocessing यूटिलिटीज इमेजेज की डायरेक्टरी का उपयोग करके 'tf.data.Dataset' बनाने का एक तरीका है।
- इस पर अधिक नियंत्रण पाने के लिए, 'tf.data' का उपयोग करके कस्टमाइज़्ड इनपुट पाइपलाइन लिखी जा सकती है।
- फाइल्स की ट्री संरचना का उपयोग 'class_names' सूची को कंपाइल करने के लिए किया जा सकता है।