TensorFlow, Google द्वारा प्रदान किया गया एक मशीन लर्निंग फ्रेमवर्क है। यह एक ओपन-सोर्स फ्रेमवर्क है जिसे Python के साथ मिलकर एल्गोरिदम, डीप लर्निंग एप्लिकेशन और बहुत कुछ लागू करने के लिए उपयोग किया जाता है। इसका उपयोग अनुसंधान और उत्पादन उद्देश्यों के लिए किया जाता है।
इंस्टॉलेशन
Windows पर 'tensorflow' पैकेज इंस्टॉल करने के लिए:
pip install tensorflow
Fashion MNIST डेटासेट
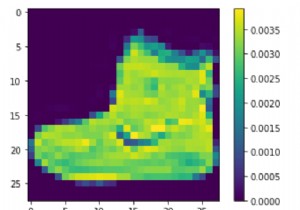
'Fashion MNIST' डेटासेट में विभिन्न प्रकार के कपड़ों की छवियां होती हैं। इसमें 70 हजार से अधिक कपड़ों की ग्रेस्केल छवियां होती हैं जो 10 विभिन्न श्रेणियों से संबंधित होती हैं। ये छवियां कम रिज़ॉल्यूशन (28 x 28 पिक्सल) की होती हैं।
Google Colaboratory का उपयोग
हम नीचे दिए गए कोड को चलाने के लिए Google Colaboratory का उपयोग कर रहे हैं। Google Colab या Colaboratory ब्राउज़र पर Python कोड चलाने में मदद करता है और इसके लिए शून्य कॉन्फ़िगरेशन की आवश्यकता होती है और GPUs (ग्राफिकल प्रोसेसिंग यूनिट्स) तक मुफ्त पहुंच प्रदान करता है। Colaboratory को Jupyter Notebook के शीर्ष पर बनाया गया है।
उदाहरण
import tensorflow as tf
import numpy as np
import matplotlib.pyplot as plt
print("उपयोग किया गया TensorFlow संस्करण है")
print(tf.__version__)
print("डेटासेट लोड किया जा रहा है")
fashion_mnist = tf.keras.datasets.fashion_mnist
print("डेटासेट को प्रशिक्षण और टेस्ट डेटा में वर्गीकृत किया जा रहा है")
(train_images, train_labels), (test_images, test_labels) = fashion_mnist.load_data()
class_names = ['T-shirt/top', 'Trouser', 'Pullover', 'Dress', 'Coat', 'Sandal', 'Shirt', 'Sneaker', 'Bag', 'Ankle boot']
print("प्रशिक्षण डेटा के आयाम")
print(train_images.shape)
print("प्रशिक्षण डेटा में पंक्तियों की संख्या")
print(len(train_labels))
print("डेटासेट के कॉलम नाम")
print(train_labels)
print("टेस्ट डेटा के आयाम")
print(test_images.shape)
print("टेस्ट डेटा में पंक्तियों की संख्या")
print(len(test_labels))
कोड क्रेडिट - TensorFlow ट्यूटोरियल
आउटपुट
उपयोग किया गया TensorFlow संस्करण है 2.4.0
डेटासेट लोड किया जा रहा है
डेटासेट को प्रशिक्षण और टेस्ट डेटा में वर्गीकृत किया जा रहा है
Downloading data from https://storage.googleapis.com/tensorflow/tf-keras-datasets/train-labels-idx1-ubyte.gz 32768/29515 [=================================] - 0s 0us/step
Downloading data from https://storage.googleapis.com/tensorflow/tf-keras-datasets/train-images-idx3-ubyte.gz 26427392/26421880 [==============================] - 0s 0us/step
Downloading data from https://storage.googleapis.com/tensorflow/tf-keras-datasets/t10k-labels-idx1-ubyte.gz 8192/5148 [===============================================] - 0s 0us/step
Downloading data from https://storage.googleapis.com/tensorflow/tf-keras-datasets/t10k-images-idx3-ubyte.gz 4423680/4422102 [==============================] - 0s 0us/step
प्रशिक्षण डेटा के आयाम (60000, 28, 28)
प्रशिक्षण डेटा में पंक्तियों की संख्या 60000
डेटासेट के कॉलम नाम [9 0 0 ... 3 0 5]
टेस्ट डेटा के आयाम (10000, 28, 28)
टेस्ट डेटा में पंक्तियों की संख्या 10000
व्याख्या
- आवश्यक पैकेज आयात किए जाते हैं।
- उपयोग किए जा रहे TensorFlow के संस्करण का निर्धारण किया जाता है।
- Fashion MNIST डेटासेट लोड किया जाता है, और Fashion MNIST डेटासेट को सीधे TensorFlow से एक्सेस किया जा सकता है।
- अगला, डेटा को प्रशिक्षण और टेस्ट डेटासेट में विभाजित किया जाता है।
- डेटासेट में कुल 70000 पंक्तियां हैं, जिनमें से 60k छवियों का उपयोग प्रशिक्षण के लिए किया जाता है और 10k का उपयोग यह मूल्यांकन करने के लिए किया जाता है कि मॉडल ने छवियों को विभिन्न लेबलों में वर्गीकृत करना कितनी अच्छी तरह सीखा है।
- यह एक वर्गीकरण समस्या है जहां डेटासेट से प्रत्येक छवि को एक विशिष्ट लेबल दिया जाता है।
- ये कपड़ों की छवियां हैं, और उन्हें संबंधित लेबल दिए जाते हैं।
- प्रशिक्षण और टेस्ट डेटासेट का आकार, पंक्तियों की संख्या, और डेटासेट में कॉलम नाम कंसोल पर प्रदर्शित किए जाते हैं।