विधि 1 - केंद्रीय प्रवृत्ति और परिवर्तनशीलता की गणना
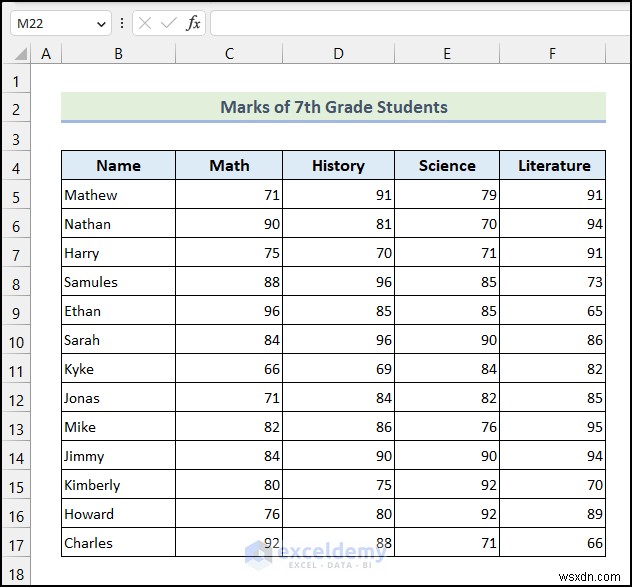
उपरोक्त डेटासेट में 7वीं कक्षा के छात्रों के अंक गणित, इतिहास, विज्ञान, और साहित्य विषयों के आधार पर दिए गए हैं।
1.1 AVERAGE फंक्शन का उपयोग करना
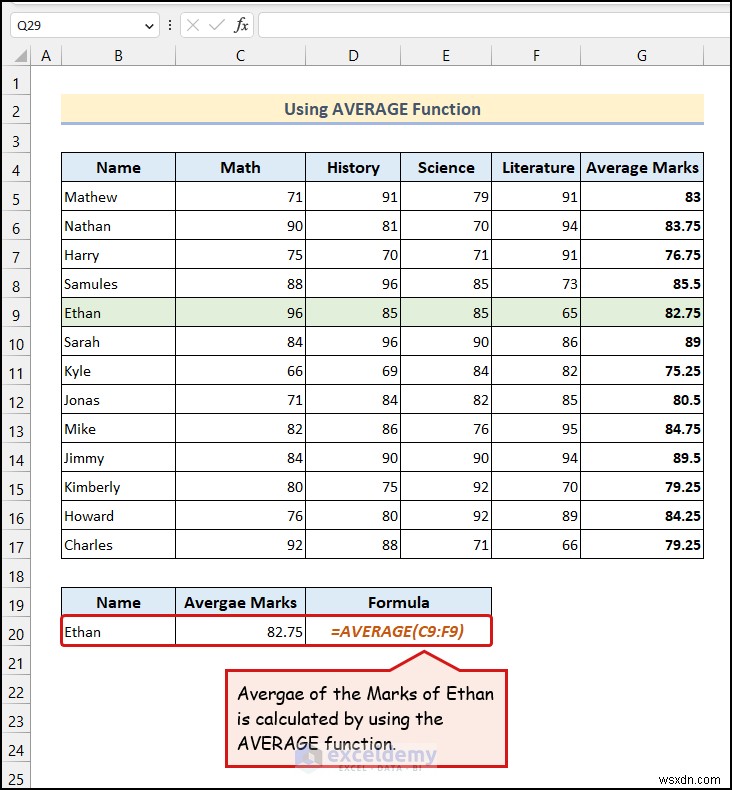
आप Ethan के लिए सेल C20 में औसत अंक देखते हैं।
यहां, हमने AVERAGE फंक्शन का उपयोग किया है, जो डेटासेट का अंकगणितीय माध्य लौटाता है।
- सेल C20 में निम्नलिखित फॉर्मूला दर्ज करें:
यहां, सेल की रेंज C9:F9 Ethan के विभिन्न विषयों के अंकों को संदर्भित करती है।
1.2 AVERAGEIF और AVERAGEIFS फंक्शन का उपयोग करना
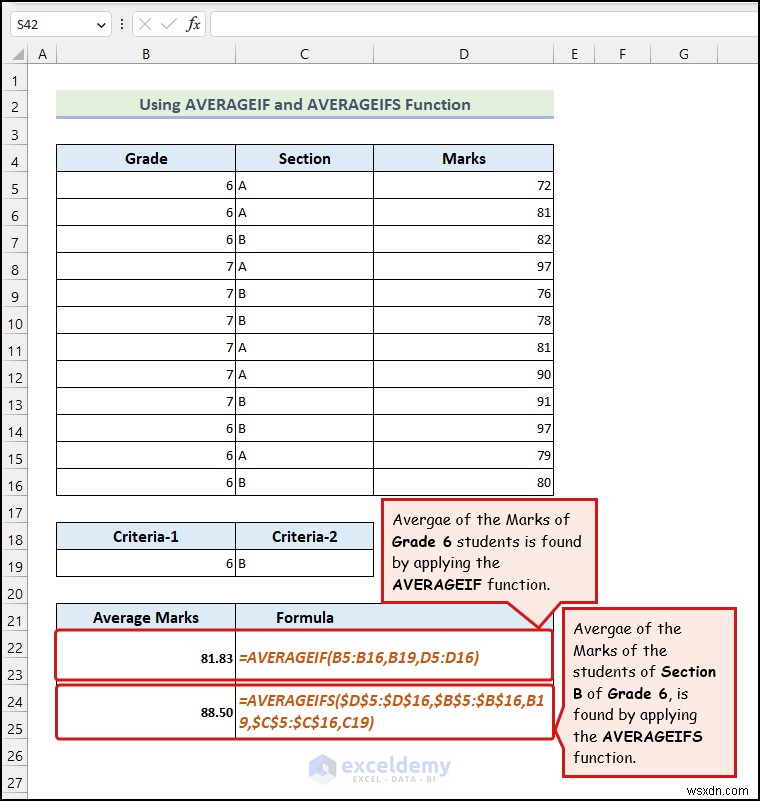
उपरोक्त डेटासेट AVERAGEIF और AVERAGEIFS फंक्शन के विविध उपयोगों को दर्शाता है।
आप कक्षा 6 के छात्रों द्वारा प्राप्त अंकों का औसत निकालना चाहते हैं। ऐसा करने के लिए,
- सेल B22 में निम्नलिखित फॉर्मूला दर्ज करें:
=AVERAGEIF(B5:B16,B19,D5:D16)
यहां, सेल B19 उस मानदंड को इंगित करता है जिसके आधार पर हम औसत अंक निकालेंगे।
आइए एक और स्थिति मान लें जहां हम दो मानदंडों: उनकी कक्षा और सेक्शन के आधार पर छात्रों के औसत अंक निकालना चाहते हैं।
- सेल C24 में निम्नलिखित फॉर्मूला दर्ज करें:
=AVERAGEIFS($D$5:$D$16,$B$5:$B$16,B19,$C$5:$C$16,C19)
यहां, सेल की रेंज $D$5:$D$16 Marks कॉलम के सेल को इंगित करती है, सेल की रेंज $B$5:$B$16 Grade कॉलम के सेल को संदर्भित करती है, और सेल की रेंज $C$5:$C$16 Section कॉलम के सेल को इंगित करती है। सेल B19 और C19 दो मानदंडों का प्रतिनिधित्व करते हैं।
1.3 HARMEAN और GEOMEAN फंक्शन का उपयोग करना
मान लें हमारे पास हमारे डेटा के रूप में छह संख्याएं हैं। संख्याएं 1,2,3,4,5 और 6 हैं। तब हमारा हार्मोनिक माध्य मान निम्नानुसार होगा।
हार्मोनिक माध्य = 1/(1+1/2+1/3+1/4+1/5+1/6)/6 = 2.4489
GEOMEAN फंक्शन चयनित डेटासेट के ज्यामितीय माध्य की गणना करता है। ज्यामितीय माध्य डेटासेट के n मानों को गुणा करने के बाद nवां मूल निकालकर गणना की जाती है। यहां, n डेटासेट में मानों की कुल संख्या है। उदाहरण के लिए, मान लें हमारे पास डेटासेट के रूप में 5 संख्याएं हैं। ये 1, 2, 3, 4, और 5 हैं। तो, ज्यामितीय माध्य होगा,
ज्यामितीय माध्य = 5√(1*2*3*4*5) = 2.6051.
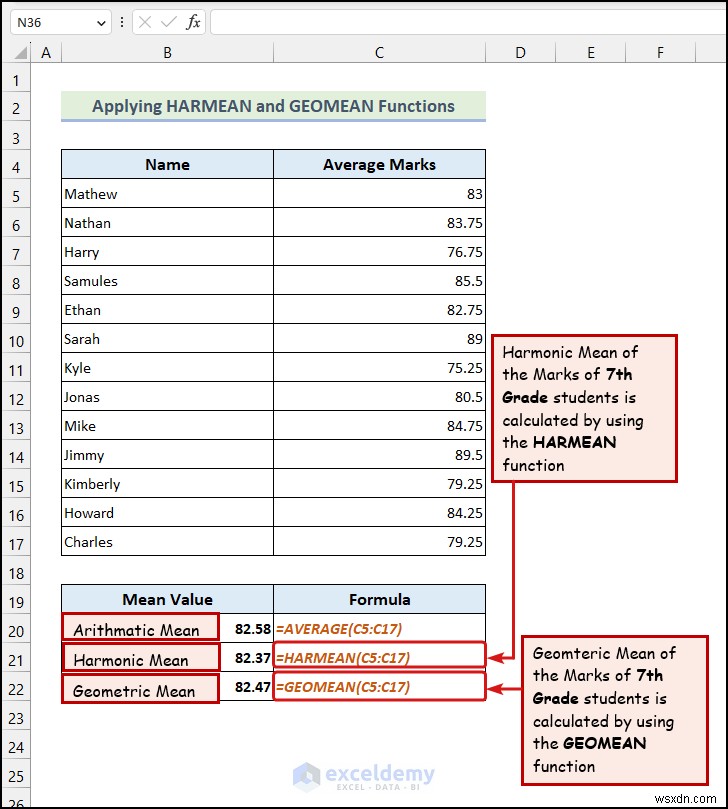
उपरोक्त छवि HARMEAN और GEOMEAN फंक्शन दोनों के उपयोग का एक व्यावहारिक उदाहरण दर्शाती है।
- B21 सेल में हार्मोनिक माध्य की गणना के लिए फॉर्मूला है:
यहां, सेल की रेंज C5:C17 Average Marks कॉलम के सेल का प्रतिनिधित्व करती है।
एक बात स्पष्ट है: इस मामले में हार्मोनिक माध्य का मान Average Marks के औसत मान से कम है। अंकगणितीय माध्य 82.58 है, लेकिन हार्मोनिक माध्य 82.37 है। इसका मतलब है कि यह Average Marks के बड़े मान को सीमित करता है।
- ज्यामितीय माध्य निकालने के मामले में, हमने सेल C22 में निम्नलिखित फॉर्मूला उपयोग किया है:
हार्मोनिक माध्य की तरह, ज्यामितीय माध्य (82.47) अंकगणितीय माध्य (82.58) से भिन्न होता है। निवेशक ज्यामितीय माध्य का उपयोग करते हैं क्योंकि यह कई अवधियों में पंक्ति मान दिए जाने पर अधिक सटीक औसत मान प्रदान करता है।
1.4 STANDARDIZE फंक्शन लागू करना
चरण:
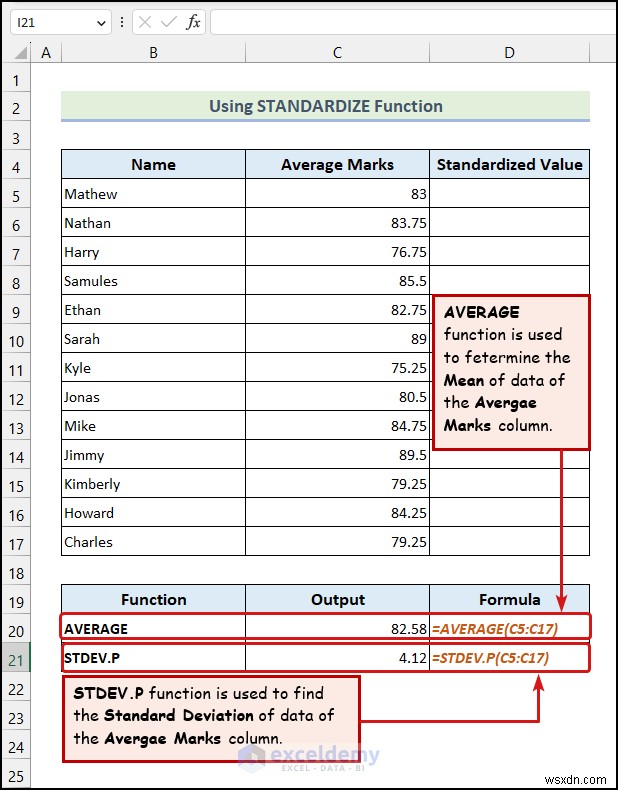
- डेटासेट का माध्य और मानक विचलन Calculate करें।
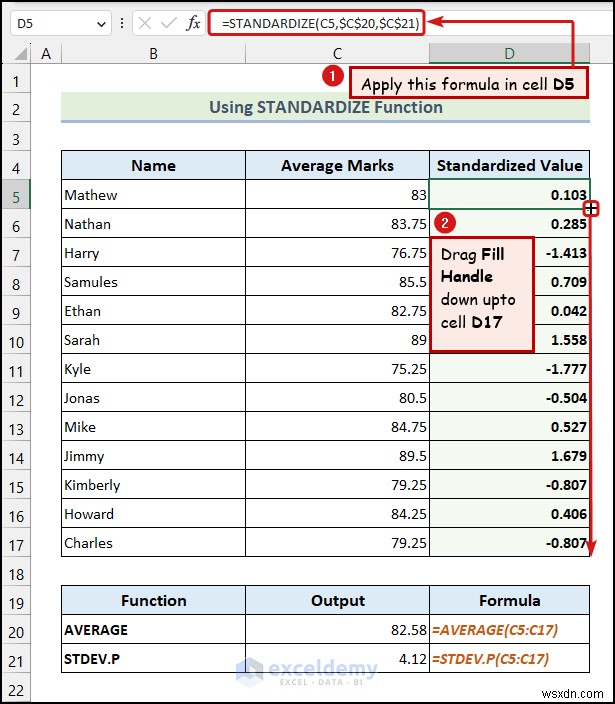
- सेल D5 में निम्नलिखित फॉर्मूला दर्ज करें:
=STANDARDIZE(C5,$C$20,$C$21)
यहां, सेल C5 Mathew के Average Marks का प्रतिनिधित्व करता है, सेल $C$20 माध्य मान को इंगित करता है, और सेल $C$21 STDEV.P (मानक विचलन) मान को संदर्भित करता है।
आप MODE.SNGL, MEDIAN, VAR.S, VAR.P, STDEV.S, और STDEV.P फंक्शन का उपयोग करके एक्सेल में डेटा का आगे सांख्यिकीय विश्लेषण कर सकते हैं।
विधि 2 - सापेक्ष स्थिति की गणना
मान लें 5वें और 6ठे रैंक के मान समान हैं। उस स्थिति में, RANK.EQ फंक्शन दोनों मानों के लिए रैंक 5 लौटाएगा, और अगला रैंक मान रैंक 7 होगा। यहां, हमारे पास डेटासेट के रूप में 7वीं कक्षा के छात्रों के कुल अंक हैं।
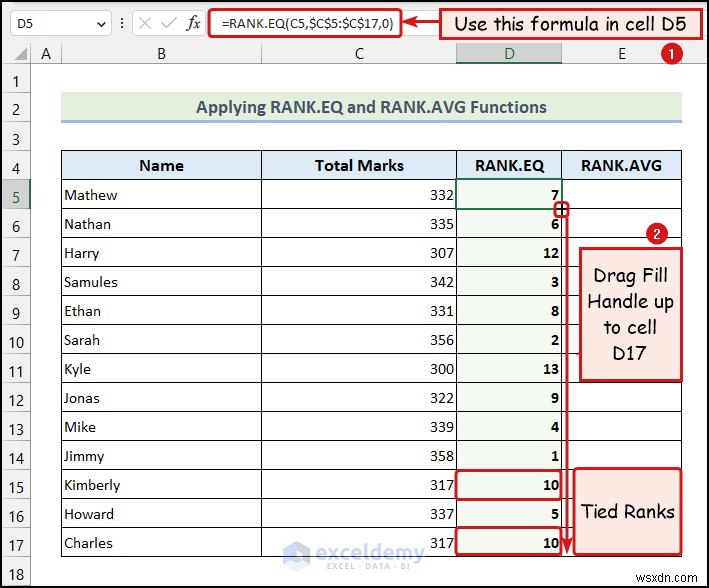
यहां, आप देख सकते हैं कि 10वें और 11वें मान बराबर थे। इसलिए, RANK.EQ फंक्शन ने दोनों मानों के लिए रैंक 10 लौटाया।
- हमने सेल D5 में निम्नलिखित फॉर्मूला लागू किया है।
=RANK.EQ(C5,$C$5:$C$17,0)
यहां, सेल C5 Total Marks कॉलम के पहले सेल को संदर्भित करता है, और सेल की रेंज $C$5:$C$17 Total Marks कॉलम के सेल का प्रतिनिधित्व करती है।
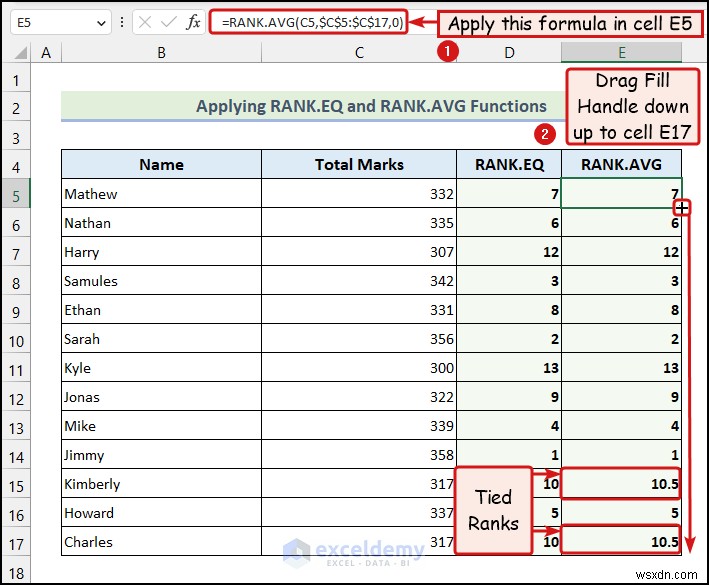
यहां, 10वें और 11वें मान बराबर थे, इसलिए RANK.AVG फंक्शन ने दोनों मानों के लिए 10.5 का औसत लौटाया।
RANK.AVG फंक्शन डेटासेट की सापेक्ष रैंक भी लौटाता है। लेकिन, टाई के मामले में, यह टाई मानों के लिए एक औसत रैंक लौटाएगा। उदाहरण के लिए, मान लें 4थे और 5वें रैंक के मान बराबर हैं। तो, RANK.AVG फंक्शन दोनों मानों के लिए 4.5 की रैंक लौटाएगा। अगले मान की रैंक 6 होगी। अब, एक्सेल में RANK.AVG फंक्शन का उपयोग करके डेटा का सांख्यिकीय विश्लेषण करने के लिए नीचे दिए गए निर्देशों का उपयोग करें।
- हमने सेल E5 में निम्नलिखित फॉर्मूला उपयोग किया है:
=RANK.AVG(C5,$C$5:$C$17,0)
इसके अलावा, आप PERCENTRANK.INC, PERCENTRANK.EXC, PERCENTILE.INC, PERCENTILE.EXC, QUARTILE.INC और QUARTILE.EXC फंक्शन का उपयोग करके एक्सेल में डेटा की सापेक्ष स्थिति की गणना कर सकते हैं।
विधि 3 - सहसंबंध और प्रतिगमन निर्धारित करना
3.1 SLOPE, INTERCEPT, और STEYX फंक्शन का उपयोग करना
STEYX फंक्शन हमें दिए गए X मानों के लिए Y मानों की मानक त्रुटि देता है। हम इसका उपयोग X मान से Y मान का अनुमान लगाने के लिए कर सकते हैं।
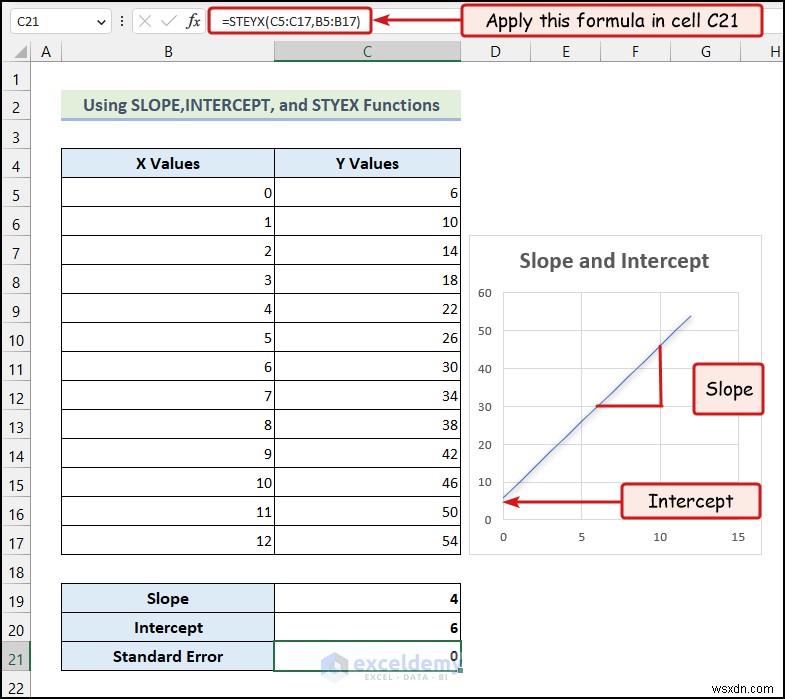
चरण:
- सेल C21 में नीचे दिया गया फॉर्मूला दर्ज करें:
यहां, सेल की रेंज C5:C17 Y Values कॉलम के सेल को इंगित करती है, और सेल की रेंज B5:B17 X Values कॉलम के सेल को संदर्भित करती है।
- ENTER दबाएं।
आपको सेल C21 में दिए गए X मानों के लिए Y मानों की मानक त्रुटि मिलेगी।
3.2 CORREL फंक्शन लागू करना
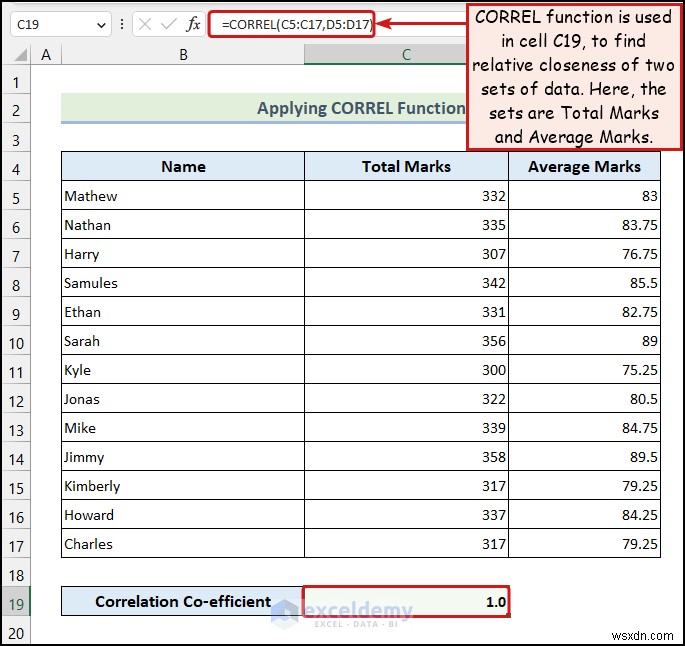
CORREL फंक्शन हमें यह पता लगाने में मदद करता है कि डेटा के दो सेट कितने निकट से संबंधित हैं।
- हमने C19 सेल में निम्नलिखित फॉर्मूला उपयोग किया है:
यहां, रेंज C5:C17 Total Marks कॉलम के सेल को इंगित करती है, और रेंज D5:D17 Average Marks कॉलम के सेल को संदर्भित करती है।
4. सांख्यिकीय विश्लेषण के लिए ऐरे फंक्शन लागू करना
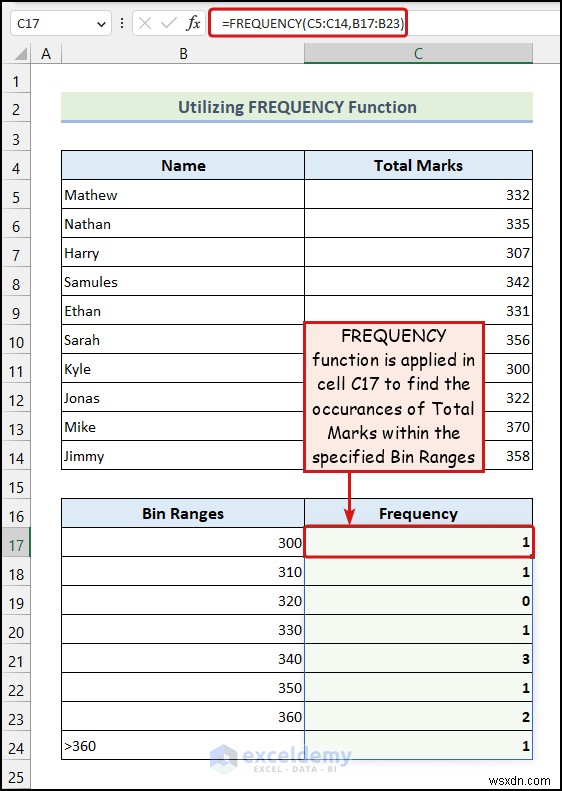
यहां, हमारे पास निम्नलिखित चित्र में प्रदर्शित प्रत्येक Bin Range के विरुद्ध आवृत्तियां हैं। हमने FREQUENCY फंक्शन का उपयोग किया है, जो सबसे अधिक उपयोग किए जाने वाले ऐरे फंक्शन में से एक है, एक्सेल में डेटा का सांख्यिकीय विश्लेषण करने के लिए।
- सेल C17 में निम्नलिखित फॉर्मूला दर्ज करें:
=FREQUENCY(C5:C14,B17:B23)
यहां, रेंज B17:B23 Bin Ranges कॉलम के पहले सात सेल का प्रतिनिधित्व करती है।
आप MODE.MULT फंक्शन, LINEST फंक्शन, TREND फंक्शन, और GROWTH फंक्शन का उपयोग करके एक्सेल में डेटा का सांख्यिकीय विश्लेषण कर सकते हैं।
नोट: यदि आप एक्सेल के पुराने संस्करण का उपयोग कर रहे हैं, तो आपको ऐरे फॉर्मूला का उपयोग करने के लिए CTRL + SHIFT + ENTER दबाने की आवश्यकता हो सकती है। चूंकि हम एक्सेल 365 का उपयोग करते हैं, बस ENTER दबाना हमारे लिए पर्याप्त होगा।
विधि 5 - मूविंग एवरेज की गणना के लिए डेटा एनालिसिस टूलपैक का उपयोग करना
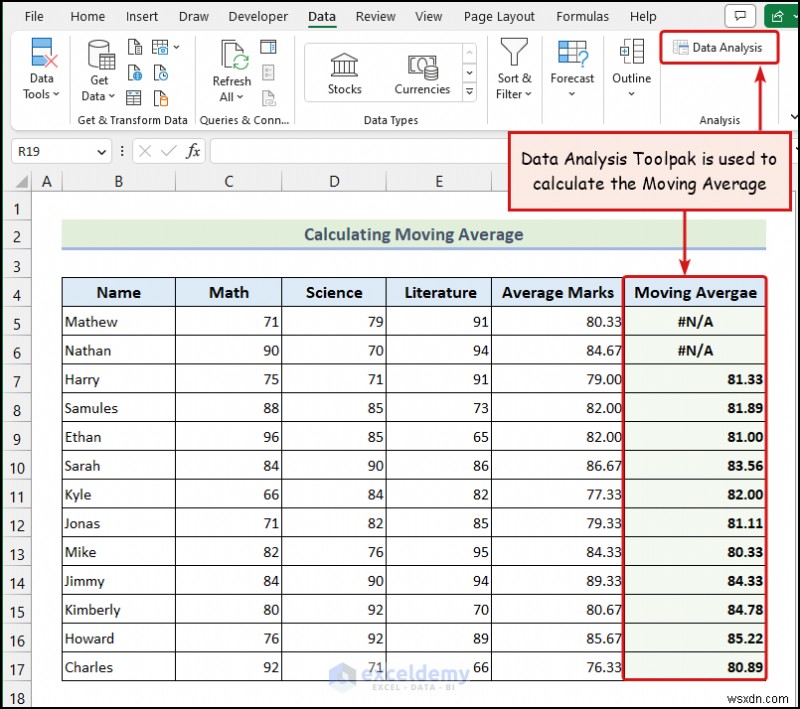
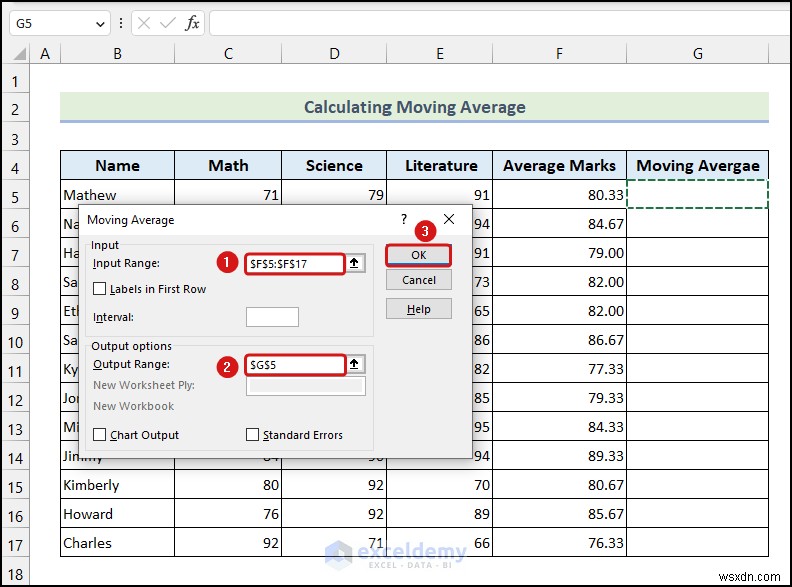
उपरोक्त छवि हमारे डेटासेट के मूविंग एवरेज का प्रतिनिधित्व करती है। Data Analysis ToolPak विकल्प डिफ़ॉल्ट रूप से एक्सेल रिबन में नहीं होता है। आपको इस सुविधा को मैन्युअल रूप से सक्रिय करना होगा। आप डेटा एनालिसिस टूलपैक को सक्रिय करने और इसके विभिन्न उपयोगों के बारे में जानने के लिए इस लेख का पालन कर सकते हैं।
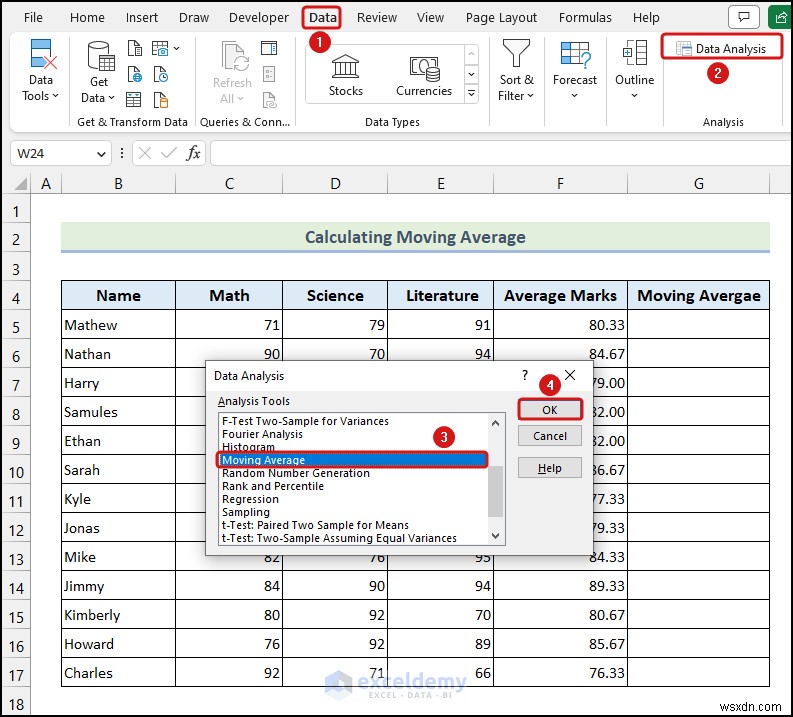
- Ribbon से Data टैब पर जाएं >> Analysis समूह से Data Analysis विकल्प चुनें।
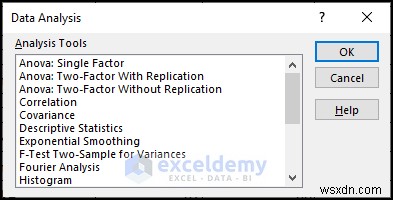
Data Analysis डायलॉग बॉक्स आपकी वर्कशीट पर दिखाई देगा, जैसा कि उपरोक्त छवि में दिखाया गया है।
- Input Range फ़ील्ड पर जाएं Average Marks कॉलम के सेल चुनने के लिए >> Output Range फ़ील्ड पर क्लिक करें और सेल G5 चुनें >> OK पर क्लिक करें।
एक्सेल में कुछ सामान्य डेटा विश्लेषण टूल
- Anova: Single Factor → यह दो या अधिक अवलोकनों के लिए विचरण का विश्लेषण करता है।
- Anova: Two Factor with Replication → चर के स्तरों के प्रत्येक संयोजन के लिए, यह दो स्वतंत्र चर और विभिन्न अवलोकनों के साथ विचरण का विश्लेषण बनाता है।
- Anova: Two Factor Without Replication → चर के स्तरों के प्रत्येक संयोजन के लिए, यह दो स्वतंत्र चर और एकल अवलोकन के साथ विचरण का विश्लेषण बनाता है।
- Correlation → जब लोगों के नमूने पर दो से अधिक माप होते हैं, तो माप के प्रत्येक संभावित जोड़े के लिए सहसंबंध गुणांकों का एक मैट्रिक्स गणना की जाती है।
- Covariance → जब लोगों के नमूने पर दो से अधिक माप होते हैं, तो माप के प्रत्येक संभावित जोड़े के लिए सहप्रसरण गुणांकों का एक मैट्रिक्स गणना की जाती है।
- Descriptive Statistics → यह परिभाषित सेल रेंज के भीतर मानों की केंद्रीय प्रवृत्ति, परिवर्तनशीलता, और अन्य गुणों को सारांशित करने वाली एक रिपोर्ट तैयार करता है।
- Exponential Smoothing → यह पिछले मानों और पिछले अनुमानों के अनुक्रम का उपयोग करके अनुक्रम के अगले मान का अनुमान लगाता है।
- F-Test Two-Sample for Variances → यह F-Test करके दो विचरणों की तुलना करता है।
- Histogram → यह चुने गए सेल रेंज के भीतर मानों की आवृत्ति वितरण का सारणीबद्ध चित्रण बनाता है।
- Random Number Generation → सात संभावित वितरणों में से एक के आधार पर, एक विशिष्ट मात्रा में यादृच्छिक संख्याएं उत्पन्न करता है।
- Rank and Percentile → यह मानों के एक सेट में प्रत्येक मान को उसके क्रमिक और प्रतिशत रैंक के साथ प्रदर्शित करने वाली एक तालिका बनाता है।
- Regression → यह एक रिपोर्ट बनाता है जिसमें एक आश्रित चर और एक या अधिक स्वतंत्र चर वाले डेटा सेट पर लागू रैखिक प्रतिगमन सांख्यिकी होती है।
- Sampling → यह निर्दिष्ट रेंज में सेल से मानों का एक नमूना उत्पन्न करता है।
आपको Data Analysis ToolPak में निम्नलिखित विश्लेषण टूल मिलेंगे।
याद रखने योग्य बातें
- एक्सेल में किसी भी डेटा विश्लेषण को करने से पहले, आपको अपने डेटा प्रकार के बारे में स्पष्ट होना चाहिए, जैसे सतत या श्रेणीबद्ध।
- इसके बाद, आपको सांख्यिकीय विश्लेषण टूल की समृद्ध सूची से चयन करना होगा, जैसे t-test, ANOVA, प्रतिगमन, और सहसंबंध।
- एक बार जब आप अपना विश्लेषण कर लेते हैं, तो अपने परिणामों को सार्थक रूप से व्याख्या करना महत्वपूर्ण है। इसका अर्थ है संख्याओं का अर्थ समझना और वे आपके शोध प्रश्न से कैसे संबंधित हैं।
- अंत में, त्रुटियों की जांच करके और यह सुनिश्चित करके कि आपका विश्लेषण मजबूत है, अपने परिणामों को मान्य करना महत्वपूर्ण है। इसमें बाहरी मानों की जांच, धारणाओं का परीक्षण, और संवेदनशीलता विश्लेषण करना शामिल है।
प्रैक्टिस सेक्शन
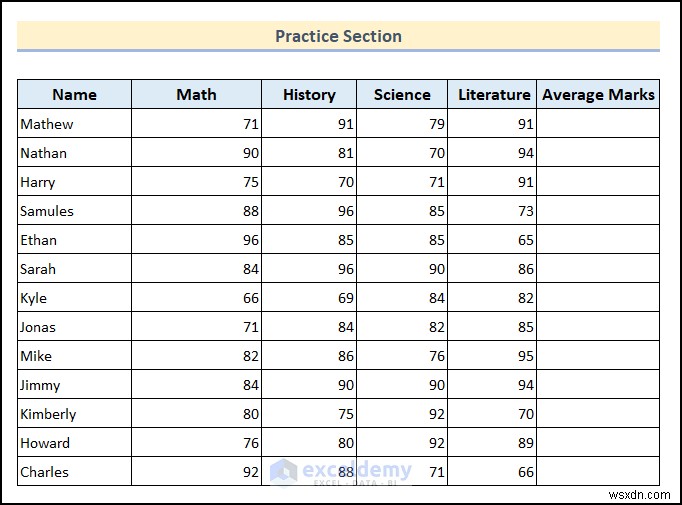
एक्सेल वर्कबुक में, हमने वर्कशीट के दाईं ओर एक Practice Section प्रदान किया है।
प्रैक्टिस वर्कबुक की प्रत्येक वर्कशीट में एक नमूना प्रैक्टिस सेक्शन प्रदान किया गया है।
प्रैक्टिस वर्कबुक डाउनलोड करें
निम्नलिखित वर्कबुक डाउनलोड करें और अभ्यास करें।
मुफ्त उन्नत एक्सेल अभ्यास समाधान के साथ प्राप्त करें!