मूल रूप से 17 जून, 2020 को Onica.com/blog पर प्रकाशित
उद्योगों की एक विस्तृत श्रृंखला के संगठन संचालन और सफलता के लिए महत्वपूर्ण अन्य कार्यों के लिए डेटा एनालिटिक्स का उपयोग करना चाहते हैं। हालांकि, जैसे-जैसे डेटा वॉल्यूम बढ़ता है, प्रबंधन और मूल्य-निष्कर्षण तेजी से जटिल हो सकते हैं।
Amazon Redshift
Amazon® Redshift® Amazon Web Services® (AWS) की एक शक्तिशाली डेटा वेयरहाउस सेवा है जो डेटा प्रबंधन और एनालिटिक्स को सरल बनाती है। आइए Amazon Redshift और कुछ सर्वोत्तम अभ्यासों पर एक नज़र डालें जिन्हें आप डेटा क्वेरीिंग प्रदर्शन को अनुकूलित करने के लिए लागू कर सकते हैं।
डेटा लेक्स बनाम डेटा वेयरहाउस
Amazon Redshift में खुदाई करने से पहले, डेटा लेक्स और वेयरहाउस के बीच अंतर जानना महत्वपूर्ण है। Amazon S3 जैसा एक डेटा लेक, एक केंद्रीकृत डेटा रिपॉजिटरी है जो संरचित और असंरचित डेटा को किसी भी पैमाने पर और कई स्रोतों से, डेटा को बदले बिना संग्रहीत करता है। दूसरी ओर, डेटा वेयरहाउस डेटा को एक सामंजस्यपूर्ण स्थिति में संग्रहीत करते हैं जो चल रहे एनालिटिक्स करने के लिए अनुकूलित है और केवल डेटा लेक्स से एनालिटिक्स के लिए आवश्यक डेटा लोड करते हैं।
Amazon Redshift डेटा एनालिटिक्स के लिए स्टोरेज को एक स्तर आगे ले जाता है, डेटा लेक्स और वेयरहाउस के गुणों को "लेक हाउस" दृष्टिकोण में समामेलित करता है। यह बड़े एक्साबाइट-स्केल डेटा लेक्स की क्वेरीइंग की अनुमति देता है जबकि लागत-प्रभावी रहता है, डेटा रिडंडेंसी को कम करता है, और रखरखाव ओवरहेड और परिचालन लागत को कम करता है।
Amazon Redshift आर्किटेक्चर
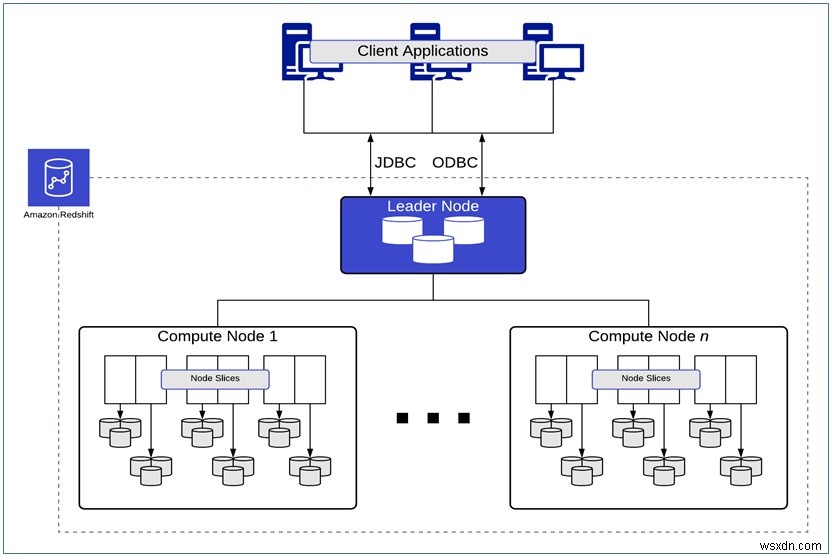
बड़े डेटा सेट पर जटिल queries को तेजी से संसाधित करने के लिए, Amazon Redshift आर्किटेक्चर मासिवली पैरेलल प्रोसेसिंग (MPP) का समर्थन करता है जो नौकरी को समवर्ती प्रसंस्करण के लिए कई कंप्यूट नोड्स में वितरित करता है।
ये नोड्स क्लस्टर्स में समूहीकृत हैं, और प्रत्येक क्लस्टर में तीन प्रकार के नोड्स होते हैं:
-
लीडर नोड: ये कनेक्शन प्रबंधित करते हैं, SQL एंडपॉइंट के रूप में कार्य करते हैं, और पैरेलल SQL प्रोसेसिंग का समन्वय करते हैं।
-
कंप्यूट नोड्स: स्लाइसेस से बना, ये कॉलमर प्रारूप में संग्रहीत डेटा पर और 1 MB अपरिवर्तनीय ब्लॉक्स में queries को पैरेलल में निष्पादित करते हैं। एक Amazon Redshift क्लस्टर में 1 और 128 कंप्यूट नोड्स के बीच हो सकते हैं, जिन्हें स्लाइस में विभाजित किया जाता है जिनमें टेबल डेटा होता है और स्थानीय प्रसंस्करण क्षेत्र के रूप में कार्य करते हैं।
-
Amazon Redshift Spectrum Nodes: ये Amazon S3 डेटा लेक के विरुद्ध queries निष्पादित करते हैं।
क्वेरी प्रदर्शन अनुकूलित करना
क्लस्टर में डेटा के भौतिक लेआउट को अपने क्वेरी पैटर्न के अनुरूप लाकर, आप इष्टतम क्वेरीइंग प्रदर्शन निकाल सकते हैं। यदि Amazon Redshift इष्टतम रूप से प्रदर्शन नहीं कर रहा है, तो वर्कलोड प्रबंधन को पुनः कॉन्फ़िगर करने पर विचार करें।
वर्कलोड मैनेजमेंट (WLM) को पुनः कॉन्फ़िगर करें
अक्सर इसकी डिफ़ॉल्ट सेटिंग में छोड़ दिया जाता है, WLM को ट्यून करने से प्रदर्शन में सुधार हो सकता है। आप इस कार्य को स्वचालित या मैन्युअल रूप से कर सकते हैं। स्वचालित होने पर, Amazon Redshift क्लस्टर-संसाधन उपयोग के आधार पर मेमोरी उपयोग और समवर्ती को प्रबंधित करता है। यह आपको आठ प्राथमिकता-नामित कतारें सेट करने की अनुमति देता है। मैन्युअल रूप से किए जाने पर, आप समवर्ती queries की संख्या, मेमोरी आवंटन, और लक्ष्यों को समायोजित कर सकते हैं।
आप निम्नलिखित WLM कॉन्फ़िगरेशन पैरामीटर्स के माध्यम से क्वेरीइंग प्रदर्शन को भी अनुकूलित कर सकते हैं:
-
क्वेरी मॉनिटरिंग नियम आपको महंगे या भगोड़े queries को प्रबंधित करने में मदद करते हैं।
-
शॉर्ट क्वेरी त्वरण मशीन लर्निंग एल्गोरिदम का उपयोग करके क्वेरी निष्पादन समय की भविष्यवाणी करके लंबे समय तक चलने वाले queries पर छोटे queries को प्राथमिकता देने में आपकी सहायता करता है।
-
समवर्ती स्केलिंग आपको सेकंड में कई क्षणिक क्लस्टर्स जोड़कर समवर्ती रीड queries को गति देने में मदद करता है।
WLM सर्वोत्तम अभ्यास
कुछ WLM ट्यूनिंग सर्वोत्तम अभ्यासों में शामिल हैं:
- विभिन्न प्रकार के वर्कलोड के लिए अलग-अलग WLM queries बनाना।
- मुख्य क्लस्टर के लिए अधिकतम कुल समवर्ती को 15 या उससे कम तक सीमित करना ताकि थ्रूपुट को अधिकतम किया जा सके।
- समवर्ती स्केलिंग सक्षम करना।
- कतार में संसाधनों की संख्या को कम करना।
डेटा वितरण को परिष्कृत करना
एक टेबल की पंक्तियाँ Amazon Redshift द्वारा नोड स्लाइस में निम्नलिखित वितरण शैलियों के आधार पर स्वचालित रूप से वितरित की जाती हैं:
AUTO: ALL से शुरू होता है और टेबल बढ़ने पर EVEN पर स्विच करता है।ALL: छोटी, अक्सर जुड़ी, और कम संशोधित टेबल्स से बना होता है जो प्रत्येक कंप्यूट नोड के पहले स्लाइस पर रखी जाती हैं।EVEN: बड़ी, स्टैंडअलोन फैक्ट टेबल्स से बना होता है जो अक्सर जुड़ी या एकत्रित नहीं होती हैं, स्लाइस में राउंड-रॉबिन वितरण में।KEY: अक्सर जुड़ी फैक्ट टेबल्स या बड़ी डायमेंशन टेबल्स से बना होता है। इस शैली में, एक कॉलम मान हैश किया जाता है, और समान हैश मान को उसी स्लाइस पर रखा जाता है।
सही वितरण पैटर्न का उपयोग JOIN, GROUP BY, और INSERT INTO SELECT ऑपरेशन के प्रदर्शन को अधिकतम कर सकता है।
डेटा सॉर्टिंग को परिष्कृत करना
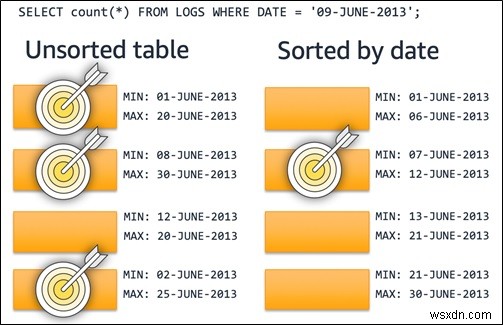
सॉर्ट कीज़ डिस्क पर डेटा के भौतिक क्रम को परिभाषित करती हैं। WHERE क्लॉज predicates में उपयोग किए जाने वाले टेबल कॉलम सॉर्ट कीज़ के लिए एक अच्छा विकल्प हैं और आमतौर पर दिनांक या समय-संबंधी कॉलम का उपयोग करते हैं। जोन मैप्स का उपयोग करें, जो मेमोरी में संग्रहीत होते हैं और स्वचालित रूप से उत्पन्न होते हैं, प्रत्येक डेटा ब्लॉक के लिए मूल्य चरम को परिभाषित करने के लिए। सॉर्ट कीज़ और जोन मैप्स को एक साथ प्रभावी ढंग से उपयोग करने से आपको स्कैन को आवश्यक न्यूनतम ब्लॉक्स की संख्या तक सीमित करने में मदद मिल सकती है।
निम्न आरेख दर्शाता है कि टेबल सॉर्टिंग समय-आधारित queries के लिए स्कैनिंग लक्ष्यों को कैसे केंद्रित करती है, जिससे क्वेरी प्रदर्शन में सुधार होता है।
इष्टतम क्वेरी प्रदर्शन सर्वोत्तम अभ्यास
पहले उल्लिखित Amazon Redshift परिवर्तनों का उपयोग क्वेरी प्रदर्शन में सुधार कर सकता है और लागत और संसाधन दक्षता में सुधार कर सकता है। यहां कुछ और सर्वोत्तम अभ्यास हैं जिन्हें आप आगे के प्रदर्शन सुधार के लिए लागू कर सकते हैं:
WHEREक्लॉज फ़िल्टर में अक्सर उपयोग किए जाने वाले कॉलम परSORTकीज़ का उपयोग करें।JOINpredicates में अक्सर उपयोग किए जाने वाले कॉलम परDISTKEYका उपयोग करें।- पहले सॉर्ट-की कॉलम को छोड़कर सभी कॉलम को कंप्रेस करें।
- एक्सेस पैटर्न जैसे क्वेरी फ़िल्टर के आधार पर डेटा लेक में डेटा पार्टीशन करें।
कुछ और सर्वोत्तम अभ्यासों का पता लगाने के लिए, Amazon Redshift परिवर्तनों में गहराई से जाएं, और एक गहन क्वेरी विश्लेषण का उदाहरण देखें, AWS पार्टनर नेटवर्क (APN) ब्लॉग पढ़ें।
यदि आप एक डेटा यात्रा पर जा रहे हैं और अपनी डेटा प्लेटफॉर्म को तेजी से, मज़बूती से, और लागत-प्रभावी ढंग से विकसित करने के लिए AWS सेवाओं का लाभ उठाना चाहते हैं, तो आज हमारी डेटा इंजीनियरिंग और एनालिटिक्स टीम से संपर्क करें।
Onica सेवाओं के बारे में अधिक जानें।
कोई टिप्पणी करने या प्रश्न पूछने के लिए Feedback टैब का उपयोग करें। आप Sales Chat पर क्लिक करके अभी चैट कर सकते हैं और बातचीत शुरू कर सकते हैं।