आप एक्जीक्यूशन प्लान को कैसे पढ़ते हैं? दाएं से बाएं, बाएं से दाएं, या लागत की जांच करके? या इंडेक्स स्कैन, टेबल स्कैन और लुकअप जैसे ऑब्जेक्ट्स के बारे में क्या? यह ब्लॉग चर्चा करता है कि Microsoft® SQL Server एक्जीक्यूशन प्लान को कैसे पढ़ा जाए।
परिचय
हालांकि SQL Server आमतौर पर एक अच्छा प्लान जनरेट करता है, कभी-कभी यह अपने प्लान को वैलिडेट करने और खराब प्लान को ठीक करने के लिए पर्याप्त स्मार्ट नहीं होता है।
आप SQL Server में अनुमानित एक्जीक्यूशन प्लान और वास्तविक ग्राफिकल एक्जीक्यूशन प्लान प्राप्त कर सकते हैं। कमांड Ctrl+M या Ctrl+L का उपयोग करके या SQL Server Management Studio (SSMS) के स्टैंडर्ड टूलबार पर एक्जीक्यूट आइकन के दाईं ओर स्थित आइकन का उपयोग करके ये प्लान जनरेट करें। SQL Server में अन्य प्रकार के प्लान भी हैं, लेकिन वे इस पोस्ट में शामिल नहीं हैं।
अनुमानित और वास्तविक एक्जीक्यूशन प्लान
दो प्रकार के एक्जीक्यूशन प्लान हैं:
-
अनुमानित एक्जीक्यूशन प्लान: अनुमानित प्लान SQL सर्वर द्वारा डेटा प्राप्त करने के लिए किए जाने वाले अपेक्षित कार्य का अनुमान प्रदान करते हैं।
-
वास्तविक एक्जीक्यूशन प्लान: वास्तविक एक्जीक्यूशन प्लान Transact-SQL क्वेरी या बैच के निष्पादन के बाद जनरेट होते हैं। इस वजह से, एक वास्तविक एक्जीक्यूशन प्लान में रनटाइम जानकारी होती है, जैसे वास्तविक संसाधन उपयोग मेट्रिक्स और कोई रनटाइम चेतावनी।
डेटा प्रोसेसिंग
क्या आपने कभी एक ही क्वेरी के लिए अनुमानित प्लान और वास्तविक प्लान के बीच अंतर देखा है? ज्यादातर समय यह समान होगा, लेकिन यह आंकड़ों में बदलाव, स्कीमा से संबंधित बदलाव, या डेटा में बदलाव के कारण अलग हो सकता है। समस्या निवारण करते समय आपको हमेशा वास्तविक एक्जीक्यूशन प्लान की जांच करनी चाहिए।
वास्तविक बिंदु की पहचान करने के लिए एक्जीक्यूशन प्लान को सही ढंग से पढ़ें। लागत के बजाय डेटा फ्लो को देखकर शुरू करें। लॉजिकल या फिजिकल रीड के बारे में न सोचें। इनपुट/आउटपुट (I/O) ऑपरेशन की संख्या को कम करना महत्वपूर्ण है। एक डेटाबेस एडमिनिस्ट्रेटर (DBA) के रूप में, आप जानते हैं कि स्टोरेज एक्सेस करना हार्डवेयर संसाधनों में सबसे धीमा है, इसलिए आपको उस गतिविधि को कम करने का प्रयास करना चाहिए। तो आप आंकड़ों का पता कैसे लगाते हैं, और क्या एक्जीक्यूशन प्लान इसे दिखाता है? हां, यह करता है! माउस को दाएं-से-बाएं इंडिकेटर पर होवर करके दिशा रेखाओं की जांच करें। यह रिकॉर्ड की संख्या और डेटा आकार प्रदर्शित करता है। प्रत्येक रेखा ऑपरेशन द्वारा लौटाए गए डेटा वॉल्यूम के आधार पर मोटी या पतली होती है जैसा कि निम्नलिखित चित्रण में दिखाया गया है:
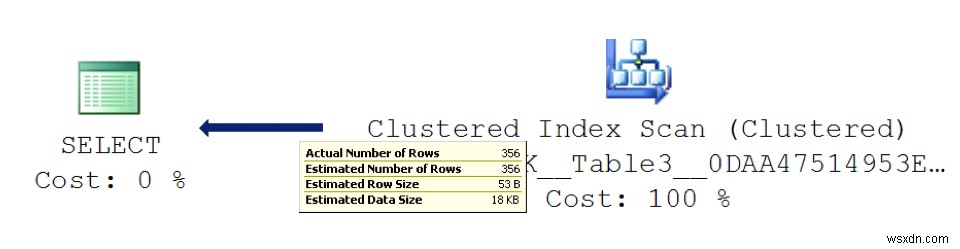
यदि आपके पास कई ऑब्जेक्ट हैं, तो आपको प्रत्येक ऑपरेशन द्वारा प्रोसेस किए गए डेटा की मात्रा का अवलोकन प्राप्त करने का एक बेहतर तरीका चाहिए। SentryOne Plan Explorer डाउनलोड करें और इस टूल का उपयोग करके प्लान देखें ताकि आसानी से अवलोकन प्राप्त किया जा सके।
SentryOne को अपने सिस्टम पर डाउनलोड और कॉन्फ़िगर करने के बाद, एक्जीक्यूशन प्लान को इसके साथ खोलें। SentryOne में कई व्यू और विवरण हैं, जिनका आप आवश्यकतानुसार उपयोग कर सकते हैं। डेटा प्रोसेसिंग व्यू प्राप्त करने के लिए, Data size in MB विकल्प का चयन करके व्यू बदलें जैसा कि निम्नलिखित छवि में दिखाया गया है। आपका लक्ष्य समग्र डेटा प्रोसेसिंग को कम करने का अवसर ढूंढना है।
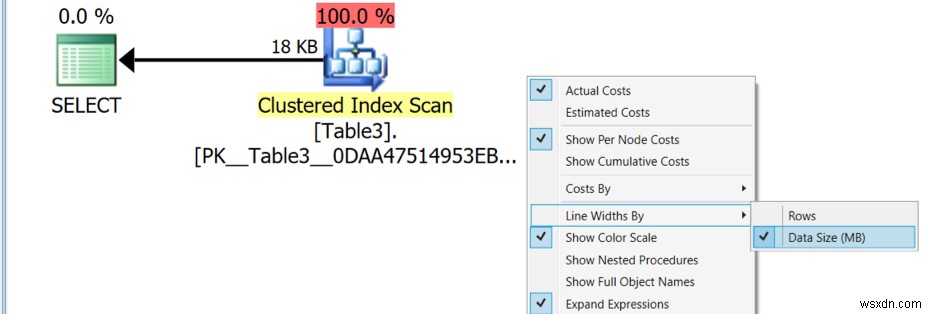
यदि आपको I/O तनाव को कम करने की आवश्यकता है, तो आप क्वेरी के लिए I/O उपयोग का समग्र विचार प्राप्त करने के लिए SET STATISTICS IO ON T-SQL मान को देख सकते हैं। इसे SSMS में क्वेरी निष्पादन से पहले सेट करें ताकि रिजल्ट पैनल में मैसेज टैब पर स्विच करें। यह निम्नलिखित परिणाम के समान दिखना चाहिए:
(356 row(s) affected) Table 'Table3'. Scan count 1, logical reads 5, physical reads 0, read-ahead reads 0, lob logical reads 0, lob physical reads 0, lob read-ahead reads 0.लॉजिकल रीड्स 5 परिणाम दर्शाता है कि SQL Server मेमोरी से डेटा प्राप्त करने के लिए 40 KB (5 * 8 KB) पेज पढ़ता है। क्वेरी को ऑप्टिमाइज़ करते समय लॉजिकल रीड को नजरअंदाज न करें क्योंकि यह लाइव सर्वर पर फिजिकल के साथ-साथ लॉजिकल भी हो सकता है। आप कभी नहीं जानते कि जिन पेजों को आप संदर्भित कर रहे हैं वे मेमोरी पर हैं या डिस्क पर। लक्ष्य संचयी रीड ऑपरेशन की संख्या को कम करना होना चाहिए।
अनुमानित बनाम वास्तविक प्लान
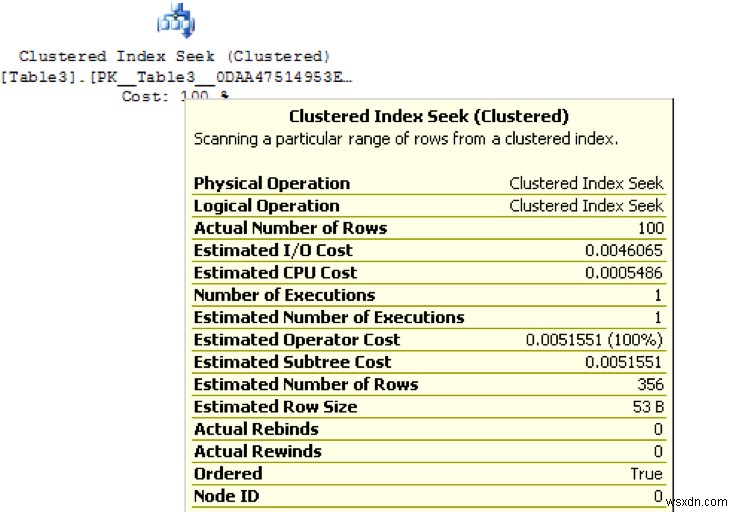
वास्तविक प्लान जनरेट होने के बाद, एक्जीक्यूशन प्लान में किसी भी ऑपरेशन या लॉजिकल यूनिट पर अपना माउस होवर करें। फिजिकल ऑपरेशन के प्रकार को देखने के लिए निम्नलिखित छवि देखें, जैसे क्लस्टर्ड इंडेक्स सीक या स्कैन परिणाम। निष्पादन की संख्या और वास्तविक और अनुमानित पंक्तियों की संख्या देखें। व्यक्तिगत ऑपरेशन की लागत को देखने से बचें क्योंकि यह पुराने हार्डवेयर के आधार पर सेकंड में एक अनुमान है और सटीक विवरण प्रदान नहीं कर सकता है। निम्नलिखित छवि में, क्लस्टर्ड इंडेक्स सीक ऑपरेटर ने 100 रिकॉर्ड प्राप्त करने के लिए एक बार निष्पादित किया, और SQL का अनुमान 356 रिकॉर्ड है। अंतर पुराने आंकड़ों या क्वेरी प्रदर्शन के कारण हो सकता है।
एक्जीक्यूशन इटरेशन
निम्नलिखित छवि दिखाती है कि क्लस्टर इंडेक्स पर अनुमानित निष्पादन की संख्या 1154121 बार है ताकि एक रिकॉर्ड प्राप्त किया जा सके। यह महत्वपूर्ण है। भले ही ऑपरेटर की लागत कम है, और हम इसे आसानी से नजरअंदाज कर सकते थे, इसके बजाय उच्च लागत वाले अन्य ऑपरेशन को देखते हुए, यह एक महंगा विकल्प साबित हो सकता है। क्लस्टर इंडेक्स होने के बावजूद ऐसे ऑपरेशंस का क्वेरी प्रदर्शन पर उच्च प्रभाव पड़ता है। रो आईडी (RID) लुकअप हीप के लिए एक समान ऑपरेशन है।
टेम्पररी डेटाबेस
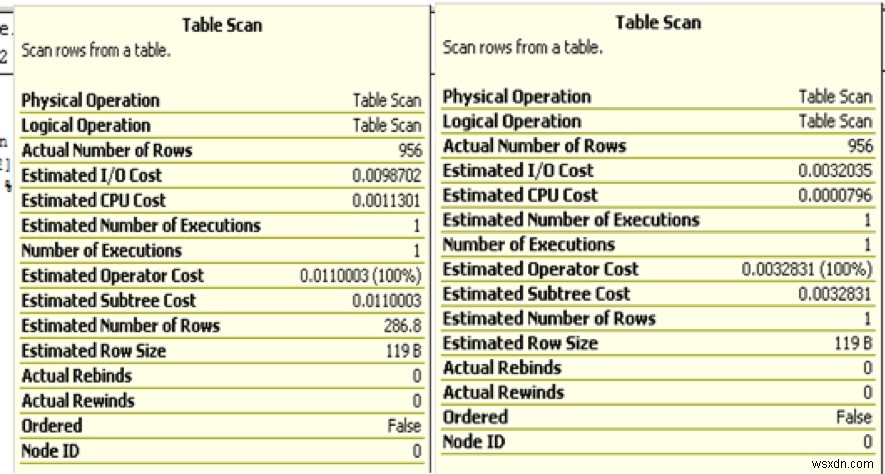
अनुमानित और वास्तविक रिकॉर्ड की संख्या के बीच का अंतर एक और चीज है जिस पर आपको विचार करना चाहिए। एक गलत अनुमान के परिणामस्वरूप एक क्वेरी को सीमित मेमोरी आवंटित हो सकती है। जब ऐसा होता है, तो यह काम पूरा करने के लिए टेम्पररी डेटाबेस (tempdb) का उपयोग करता है। SQL Server द्वारा ऑपरेटर या प्लान का गलत चयन धीमे ऑपरेशन और क्वेरी के एक्सट्रैक्शन का परिणाम हो सकता है, जैसा कि निम्नलिखित छवि में दिखाया गया है। वास्तविक रिकॉर्ड की संख्या समान है, लेकिन अनुमान अलग हैं। यह पुराने या लापता आंकड़ों के कारण हो सकता है। ध्यान दें कि टेबल वेरिएबल्स के कोई आंकड़े नहीं हैं, इसलिए प्लान हमेशा नए रिलीज में पुनः संकलन विकल्प का उपयोग होने तक 1 और 1K लौटाता है। इस प्रकार, बड़ी संख्या में रिकॉर्ड के लिए टेबल वेरिएबल्स एक अच्छा विकल्प नहीं हैं।
सॉर्ट ऑपरेटर
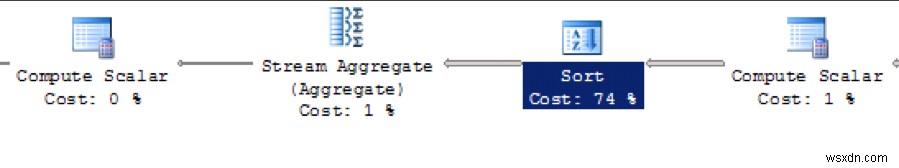
आपको सॉर्टिंग के प्रभाव पर विचार करने की आवश्यकता है। सॉर्ट ऑपरेटर का उपयोग ज्यादातर निम्नलिखित कार्यों के लिए किया जाता है: एग्रीगेट, मर्ज जॉइन, या ऑर्डर बाय क्लॉज। इसका केवल कुछ रिकॉर्ड के साथ प्रभाव नहीं हो सकता है, लेकिन प्रत्येक अतिरिक्त रिकॉर्ड के साथ, प्रोसेसिंग धीमी हो जाती है। सॉर्टिंग से बचने का प्रयास करें या ऑर्डर बाय क्लॉज का उपयोग न करें। यदि सॉर्टिंग आवश्यक है, तो सॉर्टेड डेटा को एप्लिकेशन पर भेजने के बजाय एप्लिकेशन ग्रिड का उपयोग करके सॉर्ट करें।
निम्नलिखित छवि सॉर्ट लागत दिखाती है:
स्पूल ऑपरेटर
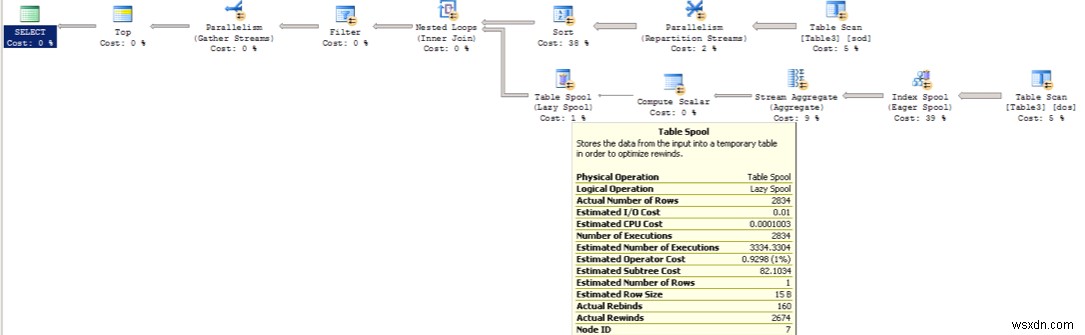
एक और प्रमुख ऑपरेटर जिसे आपको देखने की आवश्यकता है वह है स्पूल। स्पूल एक धीमा ऑपरेटर है क्योंकि यह हिडन या टेम्पररी ऑब्जेक्ट्स या वर्क टेबल्स को tempdb में स्टोर करता है। यह विशिष्ट ऑपरेटर्स के कारण रीबाइंड या रिवाइंड होने पर भी धीमा हो जाता है। SQL Server में कई प्रकार के स्पूल हैं, जैसे Eager, Lazy, Table/Index, आदि। SQL Server स्पूल का उपयोग तब करता है जब सोर्स टेबल पर वापस जाने के बजाय इंटरमीडिएट रिजल्ट सेट के लिए टेम्प वर्क टेबल को संदर्भित करना बेहतर होता है। निम्नलिखित छवि एक उदाहरण दिखाती है:
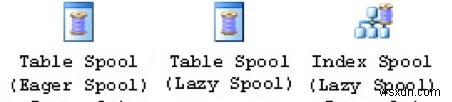
स्पूल के साथ, रीबाइंड और रिवाइंड की संख्या को नोटिस करना महत्वपूर्ण है। रिवाइंड रीबाइंड से अधिक महंगा है। उदाहरण के लिए, निम्नलिखित छवि में, ऑपरेटर 2674 रिवाइंड दिखाता है, जिसका अर्थ है कि डेटा प्राप्त करने के लिए क्वेरी को 2674 बार पुनः निष्पादित किया जाता है। यह टेबल स्पूल से टेबल स्कैन तक प्रत्येक ऑपरेटर को रिवाइंड में प्रत्येक रिकॉर्ड प्राप्त करने के लिए लौटाता है। रीबाइंड का अर्थ है कि इसे स्पूल से डेटा मिला और टेबल स्कैन के लिए वापस नहीं गया।
हैश और नेस्टेड लूप ऑपरेटर्स
चूंकि वे छोटे रिकॉर्ड सेट पर अच्छा प्रदर्शन करते हैं, हैश और नेस्टेड लूप अगले ऑपरेटर हैं जिन पर आपको विचार करना चाहिए। हालांकि, बड़े रिकॉर्ड सेट के लिए, या जब अनुमानित और वास्तविक प्लान के बीच बड़ा अंतर होता है, तो ये ऑपरेटर्स एक बड़ा प्रभाव पैदा कर सकते हैं क्योंकि वे मेमोरी के बजाय tempdb का उपयोग कर सकते हैं। SQL Server ऑपरेटर विवरण में निम्नलिखित चेतावनी पोस्ट करता है: "ऑपरेटर ने निष्पादन के दौरान tempdb में डेटा स्पिल करने के लिए उपयोग किया"। यदि ऐसा होता है, तो आंकड़ों पर ध्यान दें। गलत अनुमान के साथ, लूप मेमोरी आवंटन पर कम पड़ जाता है या यह पुनरावृत्ति करता रहता है। निष्पादन के लिए आवंटित मेमोरी को देखें। मेमोरी आवंटन देखने के लिए, एक्जीक्यूशन प्लान के प्रारंभ बिंदु (बाएं-से-दाएं) का चयन करके प्रॉपर्टी बॉक्स खोलें। यदि कुछ भी असामान्य नहीं है, तो क्वेरी ट्यूनिंग आदर्श विकल्प होना चाहिए।
निष्कर्ष
क्वेरी को ऑप्टिमाइज़ करने के लिए आपका पहला लक्ष्य समग्र रीड और राइट (यानी डिस्क पर I/O) को कम करना होना चाहिए। मेमोरी में रीड और राइट के लिए लॉजिकल रीड को न भूलें। I/O को कम करने से अधिकांश समस्याएं हल हो जाती हैं और क्वेरी बहुत तेजी से चलती हैं।
इसके बाद, उन अन्य ऑपरेशंस को देखें जो tempdb पर गतिविधि के कारण महंगे हैं। याद रखें, tempdb कई ऑपरेशंस के लिए उपयोग किया जाता है और हमेशा महंगा होता है। रिवाइंड देखें - किसी भी ऑपरेशन की निष्पादन संख्या, स्पूल, सॉर्टिंग, और लूप।
ये tempdb के साथ उपयोग किए जाने पर महंगे होते हैं। प्रत्येक ऑपरेटर पर चेतावनियों की समीक्षा करना न भूलें क्योंकि वे अच्छे सुराग प्रदान करते हैं। भले ही यह पोस्ट मिसिंग इंडेक्स ऑपरेटर पर चर्चा नहीं करता, इसका मतलब यह नहीं है कि आप इसे नजरअंदाज कर सकते हैं।
इसकी समीक्षा करें, लेकिन इंडेक्स को अंधाधुंध न बनाएं। उसी कॉलम पर उपलब्ध अन्य इंडेक्स की जांच करें, और अपने डेटाबेस में चल रही क्वेरी पर प्रभाव पर विचार करें।
कोई भी टिप्पणी करने या प्रश्न पूछने के लिए फीडबैक टैब का उपयोग करें। आप हमारे साथ बातचीत भी शुरू कर सकते हैं।