रिट्रीवल-ऑगमेंटेड जेनरेशन (RAG) का उद्देश्य बड़े भाषा मॉडल को बाहरी ज्ञान के साथ बढ़ाना है। यह डेमो में खूबसूरती से काम कर सकता है: एक छोटा क्यूरेटेड डेटासेट, साफ क्वेरी, और एक अनकंस्ट्रेन्ड लेटेंसी बजट जानकार, ग्राउंडेड उत्तर देते हैं जो उपयोगकर्ताओं को सही लगते हैं। हालांकि, कई टीमें पाती हैं कि एक बार जब वे अपने RAG एप्लिकेशन को उपयोगकर्ताओं के लिए तैनात करते हैं, तो प्रदर्शन गिर जाता है। क्वेरी अस्पष्ट हो जाती हैं, कॉर्पस का विस्तार होता है, रिट्रीवल गुणवत्ता गिरती है, लेटेंसी बढ़ जाती है, और सिस्टम चुपचाप सटीकता में फीका पड़ने लगता है। इससे भी बदतर, खराब मूल्यांकन तकनीकें छिपाती हैं कि सिस्टम वास्तव में कहां विफल होने लगता है जब तक कि उपयोगकर्ता शिकायत न करें। यह लेख उन कारणों की पड़ताल करता है जिनकी वजह से कई RAG सिस्टम उत्पादन में विफल होते हैं। हम हाल के शोध और उद्योग दिशानिर्देशों से आकर्षित करते हैं। हम मुद्दों को रिट्रीवल गुणवत्ता, लेटेंसी ट्रेड-ऑफ, एम्बेडिंग ड्रिफ्ट, और मूल्यांकन अंतराल के आसपास फ्रेम करते हैं जो विफलता मोड की एक श्रृंखला में लिंक के रूप में हैं। एक मजबूत उत्पादन RAG सिस्टम बनाने के लिए इस श्रृंखला में प्रत्येक लिंक को ध्यान में रखा जाना चाहिए।
मुख्य निष्कर्ष
- अधिकांश RAG विफलताएं रिट्रीवल में शुरू होती हैं, जेनरेशन में नहीं। जब सिस्टम अधूरे, अप्रासंगिक, या खराब रैंक वाले साक्ष्य प्राप्त करता है, तो एक मजबूत LLM भी कमजोर उत्तर देगा।
- बेहतर रिट्रीवल के लिए बेहतर इंजीनियरिंग विकल्पों की आवश्यकता होती है। डोमेन-अवेयर चंकिंग, हाइब्रिड रिट्रीवल, और रीरैंकिंग को प्रासंगिकता में सुधार और साइलेंट रिट्रीवल विफलताओं को कम करने के लिए मुख्य तकनीकों के रूप में प्रस्तुत किया गया है।
- लेटेंसी जल्दी से एक उत्पादन बॉटलनेक बन जाती है। बड़े top_k, रीरैंकर्स, लंबे संदर्भ, और अतिरिक्त रिट्रीवल चरण जोड़ने से रिकॉल में सुधार हो सकता है, लेकिन यह सिस्टम को वास्तविक उपयोगकर्ताओं के लिए बहुत धीमा भी बना सकता है।
- एम्बेडिंग ड्रिफ्ट समय के साथ चुपचाप प्रदर्शन को खराब करता है। एम्बेडिंग मॉडल, दस्तावेज़ संग्रह, और उपयोगकर्ता शब्दावली में परिवर्तन सभी रिट्रीवल व्यवहार को बदल सकते हैं, इसलिए वर्जनिंग और ऑब्जर्वेबिलिटी आवश्यक हैं।
- केवल अंतिम उत्तर गुणवत्ता मूल्यांकन के लिए पर्याप्त नहीं है। टीमों को अलग रिट्रीवल और जेनरेशन मेट्रिक्स, यथार्थवादी टेस्ट सेट, निरंतर निगरानी, और सिस्टम के लिए सबूत कमजोर या गायब होने पर रुकने की क्षमता की आवश्यकता होती है।
खराब रिट्रीवल गुणवत्ता के कारण विफलता
कम रिट्रीवल गुणवत्ता उत्पादन में तैनात RAG सिस्टम की विफलता के सबसे लगातार कारणों में से एक है। डेवलपर्स अक्सर गलत/खराब उत्तरों के लिए LLM को दोषी ठहराते हैं; हालांकि, गलती आमतौर पर पाइपलाइन में पहले होती है। यदि सिस्टम पूर्ण या प्रासंगिक साक्ष्य प्राप्त नहीं कर सकता, या साक्ष्य को खराब रैंक देता है, तो सबसे अच्छा मॉडल भी एक भरोसेमंद प्रतिक्रिया उत्पन्न करने की संभावना नहीं है। रिट्रीवल गुणवत्ता को एक पृष्ठभूमि चरण के बजाय प्रथम श्रेणी की इंजीनियरिंग चिंता के रूप में माना जाना चाहिए।
अधिकांश विफलताएं LLM के क्वेरी देखने से पहले होती हैं
मानक पाइपलाइन उपयोगकर्ता क्वेरी को एम्बेड करता है, एक वेक्टर स्टोर से शीर्ष-k दस्तावेज़ प्राप्त करता है, और उन्हें LLM को भेजता है। उस पाइपलाइन में हर तीर विफलता का एक संभावित बिंदु है।
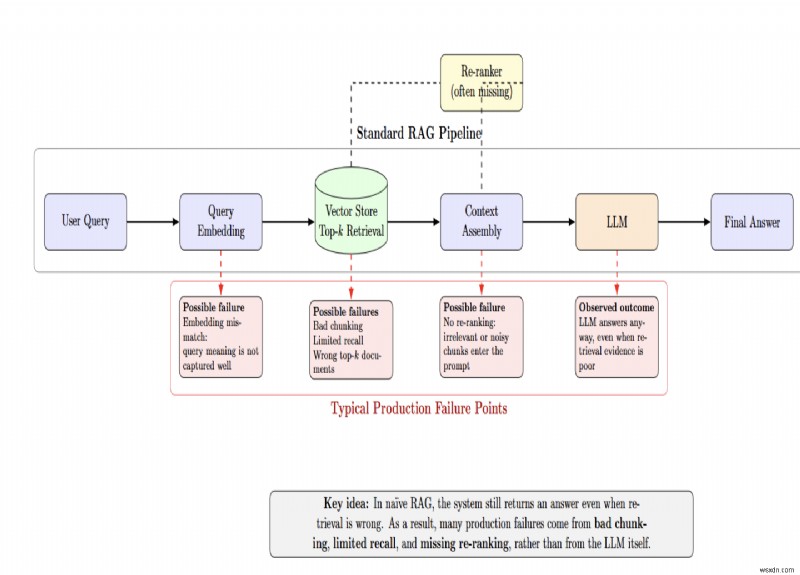
नाइव RAG इन विफलताओं को अस्पष्ट करता है क्योंकि सिस्टम रिट्रीवल गलत होने पर भी एक उत्तर प्रदान करता है। कई उत्पादन मुद्दे खराब चंकिंग रणनीतियों, सीमित रिकॉल, और लापता री-रैंकिंग से उत्पन्न होते हैं, न कि LLM की कमियों से।
चंकिंग गलतियाँ साइलेंट विफलताएँ पैदा करती हैं
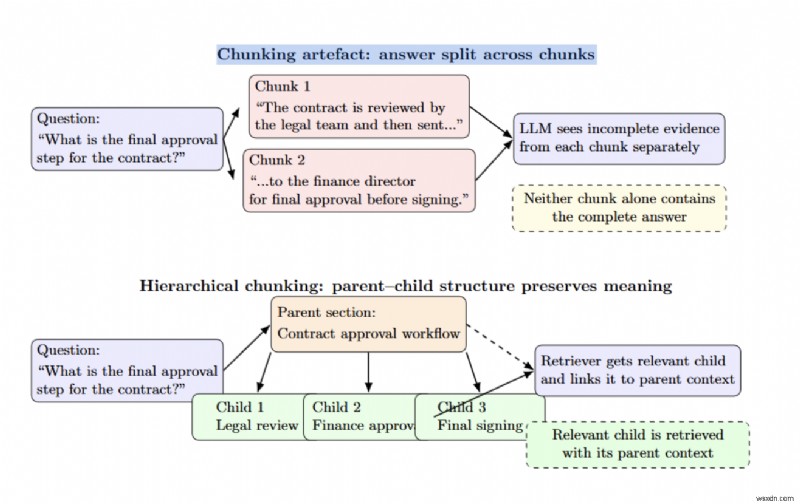
चंक आकार सटीकता/रिकॉल को प्रभावित करता है — बड़े चंक कम प्रासंगिकता के साथ अधिक संदर्भ प्रदान करते हैं, जबकि छोटे चंक उच्च सटीकता प्रदान करते हैं लेकिन आसपास की जानकारी खो देते हैं। हायरार्किकल (पेरेंट-चाइल्ड) चंकिंग इस ट्रेड-ऑफ को हल करता है पूरे सेक्शन को पेरेंट चंक के रूप में संग्रहीत करके और केवल छोटे प्रासंगिक चाइल्ड चंक को प्राप्त करके।
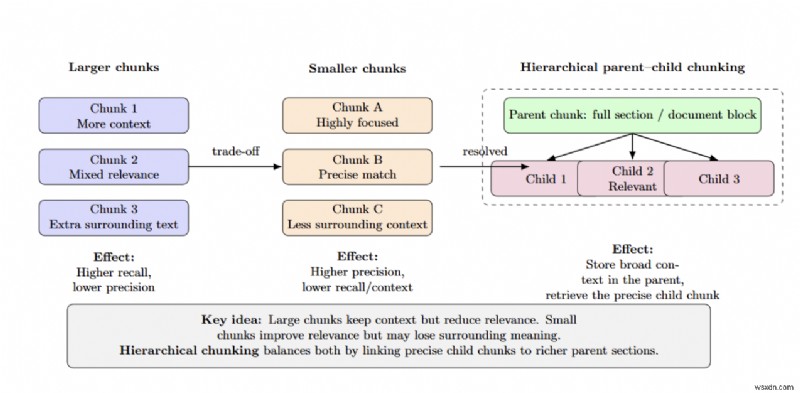
विश्वविद्यालय प्रस्तुति डेक पर NVIDIA के आंतरिक परीक्षण में पाया गया कि हायरार्किकल चंकिंग फिक्स्ड-साइज़ चंक के साथ 61% से 89% तक उत्तर सटीकता में सुधार करता है। संरचनात्मक सीमाओं का सम्मान करते हुए और जहां संभव हो डोमेन-अवेयर स्प्लिटिंग लागू करते हुए एक उपयुक्त चंक आकार चुनना महत्वपूर्ण है।
हाइब्रिड रिट्रीवल और री-रैंकिंग
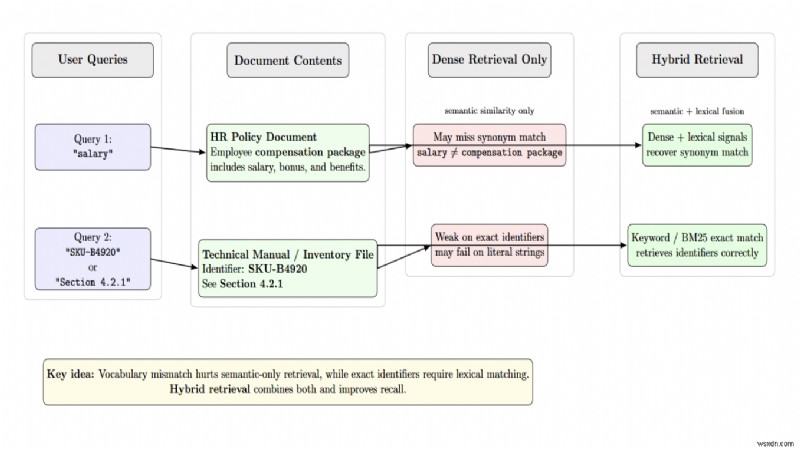
प्योर डेंस रिट्रीवल सिमेंटिक समानता में अच्छा है लेकिन सटीक पहचानकर्ताओं से चूक जाता है। प्योर कीवर्ड सर्च सटीक शर्तों के प्रति संवेदनशील है, लेकिन सिमेंटिक पैराफ्रेस पर विफल रहता है। हाइब्रिड रिट्रीवल सिस्टम डेंस (वेक्टर) रिट्रीवल और स्पार्स (BM25/कीवर्ड) रिट्रीवल को एक साथ चलाते हैं, फिर रेसिप्रोकल रैंक फ्यूजन के साथ उनके परिणामों को फ्यूज करते हैं।
हाइब्रिड रिट्रीवल सिस्टम सिमेंटिक समानता संकेतों को लेक्सिकल मिलान संकेतों के साथ जोड़कर शब्दावली बेमेल को हल करते हैं। फ्यूजन के बाद एक री-रैंकर (क्रॉस-एनकोडर) के साथ उम्मीदवार जोड़े को रीस्कोर करने से रिकॉल में सुधार होता है। अनिवार्य रूप से, रीरैंकर्स प्राप्त दस्तावेजों को पुनः क्रमबद्ध करते हैं ताकि केवल सबसे प्रासंगिक दस्तावेज़ उस संदर्भ में आएं जिसकी LLM समीक्षा करता है। यह टोकन सीमाओं को बचाता है और संदर्भ स्टफिंग से बचाता है जबकि LLM रिकॉल में सुधार करता है।
रिट्रीवल मेट्रिक्स को अलग से मॉनिटर किया जाना चाहिए
टीमें केवल एंड-टू-एंड उत्तर गुणवत्ता को मापती हैं। रिट्रीवल के अपने मेट्रिक्स हैं जिनका आप उपयोग कर सकते हैं: precision@k (प्राप्त चंक का कितना अंश प्रासंगिक है?), recall@k (प्रासंगिक चंक का कितना अंश आपने प्राप्त किया?), मीन रेसिप्रोकल रैंक (पहला प्रासंगिक चंक कितना ऊंचा था?), और नॉर्मलाइज़्ड डिस्काउंटेड क्यूमुलेटिव गेन (आपकी समग्र रैंकिंग कितनी अच्छी है?)।
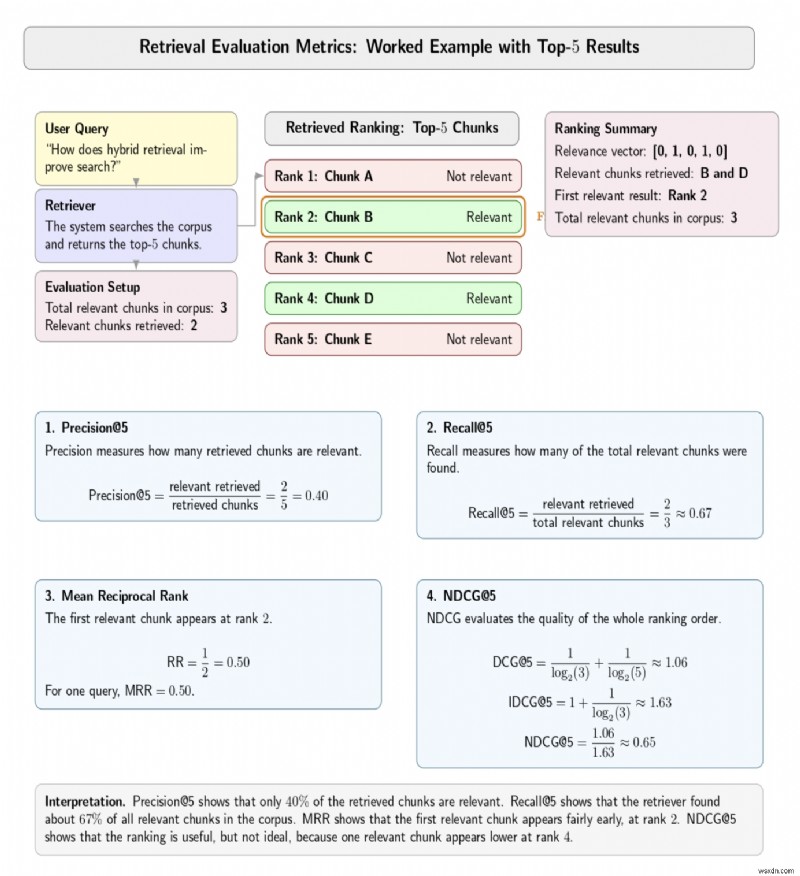
यदि आप इन्हें नहीं मापते हैं, तो आपको पता नहीं चलेगा कि विफलताएं खराब रिट्रीवल से हैं या खराब जेनरेटर से। टेस्ट क्वेरी और गोल्डन डेटासेट आपको ऑफ़लाइन मूल्यांकन करने देंगे। यदि आप वास्तविक क्वेरी पर इन मेट्रिक्स को ट्रैक करते हैं, तो आप उत्पादन प्रतिगमन को सामने ला सकते हैं।
उदाहरणों के साथ रिट्रीवल विफलता का निदान
अस्पष्ट क्वेरी और शब्दावली बेमेल अक्सर गलत रिट्रीवल का कारण बनते हैं। एक उपयोगकर्ता "वेतन" खोज सकता है जबकि दस्तावेज़ "मुआवजा पैकेज" को संदर्भित करता है। डेंस एम्बेडिंग समानार्थी को पहचानने में विफल हो सकते हैं, जबकि हाइब्रिड रिट्रीवल इसे ठीक करता है। एक अन्य मामला सटीक मिलान के लिए है, जैसे पहचानकर्ता। "SKU-B4920" या "धारा 4.2.1" के लिए एक क्वेरी को सटीक लेक्सिकल मिलान की आवश्यकता होती है।
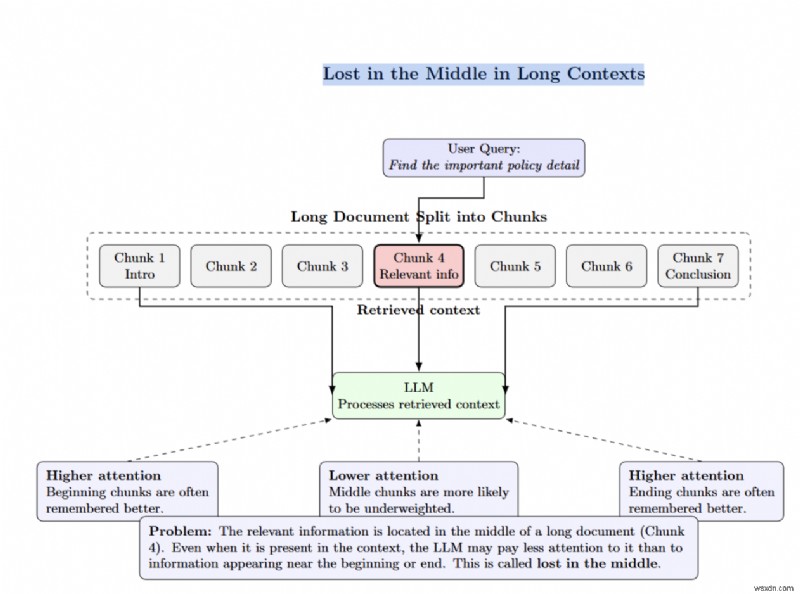
"मिडिल में खो गया" तब होता है जब प्रासंगिक जानकारी एक लंबे दस्तावेज़ में गहराई से दबी होती है। LLM मिडिल चंक में टोकन को कम वजन देगा।
चंकिंग आर्टिफैक्ट्स तब उत्पन्न होते हैं जब एक उत्तर दो चंक में विभाजित होता है, इसलिए कोई भी चंक पूर्ण उत्तर नहीं रखता। हायरार्किकल चंकिंग पेरेंट और चाइल्ड नोड्स को जोड़कर इसे कम करने में मदद करता है।
वास्तविक सिस्टम में लेटेंसी विस्फोट के कारण विफलता
लेटेंसी मुख्य कारणों में से एक है कि एक RAG सिस्टम जो डेमो में काम करता है, उत्पादन में संघर्ष करता है। जैसे-जैसे रिट्रीवल पाइपलाइन अधिक परिष्कृत होती जाती है, प्रतिक्रिया समय तेजी से बढ़ सकता है और टीमों को उत्तर गुणवत्ता के विरुद्ध उपयोगिता का व्यापार करने के लिए मजबूर कर सकता है।
रिट्रीवल-लेटेंसी ट्रेड-ऑफ
उत्पादन टीमों को अक्सर रिट्रीवल गुणवत्ता और उनके लेटेंसी बजट को संतुलित करना चाहिए। जो कुछ भी प्रतिक्रिया समय बढ़ाता है (बड़े top_k के साथ जाना, हाइब्रिड रिट्रीवल जोड़ना, रीरैंकिंग करना, या लॉन्ग-कॉन्टेक्स्ट मॉडल चलाना) उन बजट में कटौती करता है। ट्रेड-ऑफ विशेष रूप से कठिन है क्योंकि उपयोगकर्ता उत्तरदायी उत्तर की उम्मीद करते हैं, और एंटरप्राइज़ एकीकरण कठोर लेटेंसी बजट के साथ आते हैं। हालांकि, कॉर्नेल और NVIDIA के हालिया कार्य के अनुसार, RAG महत्वपूर्ण लेटेंसी ओवरहेड खर्च करता है। रिट्रीवल को बहुत बार चलाने से सटीकता बढ़ सकती है, लेकिन एंड-टू-एंड लेटेंसी को लगभग 30 सेकंड तक बढ़ा सकती है—उत्पादन उपयोग के लिए बहुत अधिक।
जेनरेशन आमतौर पर हावी होता है, लेकिन रिट्रीवल मायने रखता है
RAGPerf के साथ बेंचमार्किंग से पता चलता है कि जेनरेशन अक्सर टेक्स्ट-ओनली RAG पाइपलाइन का प्रमुख हिस्सा होता है। यदि रिट्रीवल गुणवत्ता बनाए रखी जाती है तो एक छोटा LLM चुनने से उत्तर गुणवत्ता का त्याग किए बिना लेटेंसी को काफी कम किया जा सकता है। मल्टीमॉडल पाइपलाइन (PDF और इमेज रिट्रीवल) के रीरैंकिंग और संबंधित क्रॉस-मोडल मॉडल के कारण बड़े कंप्यूट डिमांड होते हैं। रिट्रीवल लेटेंसी बढ़ सकती है जब वेक्टर डेटाबेस धीमे हों या समवर्ती लुकअप की अनुमति न दें। हालांकि, तेज लुकअप के साथ भी, रीरैंकिंग कई RAG वर्कलोड के लिए कुल लेटेंसी पर हावी हो सकती है।
लेटेंसी, लागत, और संदर्भ विंडो
कुछ टीमें top_k बढ़ाकर या LLM के संदर्भ में अधिक दस्तावेज़ भरकर रिकॉल को हल करने का प्रयास करती हैं। अध्ययन दिखाते हैं कि इसका विपरीत प्रभाव होता है। जितने अधिक दस्तावेज़ आप प्रॉम्प्ट में जोड़ते हैं, LLM उतना ही कम सही जानकारी को याद रख पाता है। रिट्रीवल रीरैंकिंग कई दस्तावेज़ प्राप्त करके, फिर LLM के लिए केवल सर्वश्रेष्ठ का चयन करके इसे हल करता है। लंबी संदर्भ विंडो "मिडिल में खो गया" और खगोलीय कम्प्यूटेशनल लागत का कारण बनती है।
लेटेंसी ऑप्टिमाइज़ करना
RAG सिस्टम में लेटेंसी को संबोधित करने के लिए पूरे पाइपलाइन में जानबूझकर ऑर्केस्ट्रेशन की आवश्यकता होती है:
| फोकस क्षेत्र | क्या करें | यह क्यों मायने रखता है |
|---|---|---|
| रिट्रीवल गुणवत्ता | डिफ़ॉल्ट फिक्स्ड विंडो के बजाय डोमेन-अवेयर चंकिंग का उपयोग करें। जहां यह मायने रखता है दस्तावेज़ संरचना को संरक्षित करें। डेंस और लेक्सिकल रिट्रीवल को मिलाएं। रीरैंकिंग जोड़ें। मेटाडेटा का बुद्धिमानी से उपयोग करें। | कवरेज और प्रासंगिकता में सुधार करता है, और सिस्टम को ग्राउंडेड उत्तरों के लिए अधिक उपयोगी संदर्भ प्राप्त करने में मदद करता है। |
| लेटेंसी नियंत्रण | हर चरण को मापें। उन चरणों को हटाएं जो सार्थक लाभ नहीं देते। पाइपलाइन को उतना ही सरल रखें जितना उपयोग केस अनुमति देता है। वास्तविक इंटरैक्शन पैटर्न के लिए निर्माण करें। | अनावश्यक ओवरहेड को कम करता है और वास्तविक उत्पादन सेटिंग्स में सिस्टम को उत्तरदायी रखता है। |
| ड्रिफ्ट प्रबंधन | एम्बेडिंग, इंडेक्स, चंकिंग रणनीतियों, और इंजेस्टन नीतियों को वर्जन दें। जब दस्तावेज़ बदलते हैं या मॉडल स्वैप किए जाते हैं तो पुनर्मूल्यांकन करें। ताजगी को स्पष्ट रूप से इंजीनियर करें। | सामग्री, मॉडल, और क्वेरी पैटर्न के विकसित होने पर साइलेंट गुणवत्ता क्षय को रोकता है। |
| मूल्यांकन | वास्तविक क्वेरी पर आधारित गोल्डन डेटासेट बनाए रखें। रिट्रीवल मेट्रिक्स को जेनरेशन मेट्रिक्स से अलग करें। संदर्भ सटीकता, रिकॉल, ग्राउंडेडनेस, और वफादारी मापें। | केवल अंतिम उत्तर गुणवत्ता पर भरोसा करने के बजाय वास्तविक विफलता बिंदु की पहचान करने में मदद करता है। |
| निगरानी और ट्रेसिंग | तैनाती से पहले मूल्यांकन चलाएं और लॉन्च के बाद निगरानी करें। रिट्रीवल और जेनरेशन लेयर्स में ट्रेसिंग जोड़ें। | प्रतिगमन को दृश्यमान बनाता है और टीमों को उत्पादन में विफलताओं का अधिक सटीक निदान करने में मदद करता है। |
| परहेज व्यवहार | सिस्टम को यह कहने दें जब साक्ष्य गायब, पुराना, या विरोधाभासी हो। | आत्मविश्वासपूर्ण लेकिन कमजोर उत्तरों पर अनुशासित ग्राउंडिंग को पसंद करके भरोसा सुधारता है। |
एम्बेडिंग ड्रिफ्ट और ज्ञान परिवर्तन के कारण विफलता
एम्बेडिंग टेक्स्ट को उच्च-आयामी वैक्टर के रूप में दर्शाते हैं जिनके समान अर्थ एक दूसरे के करीब होते हैं। टीमें अक्सर अपने दस्तावेजों को एक अलग एम्बेडिंग मॉडल के साथ पुनः एम्बेड करती हैं या क्वेरी एनकोडर को स्वैप करती हैं बिना अपने इंडेक्स को ठीक से वर्जन दिए या प्रासंगिकता परिवर्तनों को बेंचमार्क किए। नया मॉडल वस्तुनिष्ठ रूप से मजबूत हो सकता है, लेकिन यह पड़ोस संरचना को अप्रत्याशित तरीकों से बदल सकता है जो रैंकिंग, रिकॉल, या यहां तक कि डोमेन-विशिष्ट भाषा को प्रभावित करते हैं। एक मॉडल जो सामान्य बेंचमार्क में उत्कृष्ट है, वह आपके वास्तविक-विश्व एंटरप्राइज़ लिंगो के साथ भयानक प्रदर्शन कर सकता है।
ड्रिफ्ट के तीन कारण
- मॉडल ड्रिफ्ट। एम्बेडिंग मॉडल लगातार अपडेट होते हैं। जब आप एक एम्बेडिंग मॉडल के एक वर्जन का उपयोग करके दस्तावेजों को इंडेक्स करते हैं, तो आप उन्हें दूसरे मॉडल के एम्बेडिंग के साथ खोज नहीं सकते। कॉर्पस को पुनः इंडेक्स किए बिना एम्बेडिंग मॉडल को स्विच करने से आपकी रिट्रीवल प्रभावित होगी।
- कॉर्पस ड्रिफ्ट। जब आप इंडेक्स में नए दस्तावेज़ जोड़ते हैं, विशेष रूप से नए प्रकार के दस्तावेज़, तो वेक्टर स्पेस बदल जाता है। घने वैक्टर के नए क्लस्टर दिखाई देते हैं। वे घने क्लस्टर उन क्वेरी को खींचना शुरू कर देते हैं जिन्हें अन्य दस्तावेज़ों के विरुद्ध मिलान करना चाहिए। उपयोगकर्ता-जनित या शोर वाली सामग्री जोड़ने से रिट्रीवल गुणवत्ता समय के साथ खराब हो जाएगी, भले ही आप एम्बेडिंग मॉडल न बदलें।
- क्वेरी ड्रिफ्ट। उपयोगकर्ताओं की शब्दावली समय के साथ विस्तारित और स्थानांतरित होती है। नए शब्द उपयोग में आते हैं ("रिमोट वर्क," "स्टेबलकॉइन," "प्रॉम्प्ट इंजीनियरिंग") और पुरानी शब्दावली फीकी पड़ जाती है। पहले से मौजूद एम्बेडिंग उन शब्दों से मेल नहीं खा सकते जो उनके प्रशिक्षण के समय मौजूद नहीं थे। यदि कोई कंपनी अपने किसी उत्पाद का नाम बदलती है, तो नए नाम की खोज विफल हो जाती है क्योंकि एम्बेडिंग अभी भी पुराने नाम को दर्शाते हैं।
मीन रेसिप्रोकल रैंक के साथ एम्बेडिंग ड्रिफ्ट का पता लगाना
नीचे एक उदाहरण आरेख दिखाता है कि रिट्रीवल प्रदर्शन में परिवर्तनों की निगरानी करके एम्बेडिंग ड्रिफ्ट का पता कैसे लगाया जाता है, सिस्टम परिवर्तन से पहले और बाद में, या समय के साथ। आरेख पहले एक बेसलाइन MRR स्कोर की गणना करता है जहां प्रासंगिक दस्तावेज़ रैंकिंग के शीर्ष के पास दिखाई देते हैं। फिर यह एक वर्तमान MRR स्कोर की गणना करता है जहां प्रासंगिक दस्तावेज़ रैंकिंग में और नीचे रैंक किए जाते हैं। सिस्टम तब बेसलाइन MRR और वर्तमान MRR के बीच प्रतिशत गिरावट की गणना करता है। यदि MRR गिरावट एक पूर्व-चयनित सीमा से ऊपर है, तो सिस्टम एम्बेडिंग ड्रिफ्ट के लिए अलर्ट उठाता है और एम्बेडिंग मॉडल, डेटा वितरण, और इंडेक्स की समीक्षा करने का सुझाव देता है। अन्यथा, यदि गिरावट सीमा से नीचे है, तो सिस्टम निर्धारित करता है कि रिट्रीवल सिस्टम स्थिर है और निगरानी जारी रखता है।
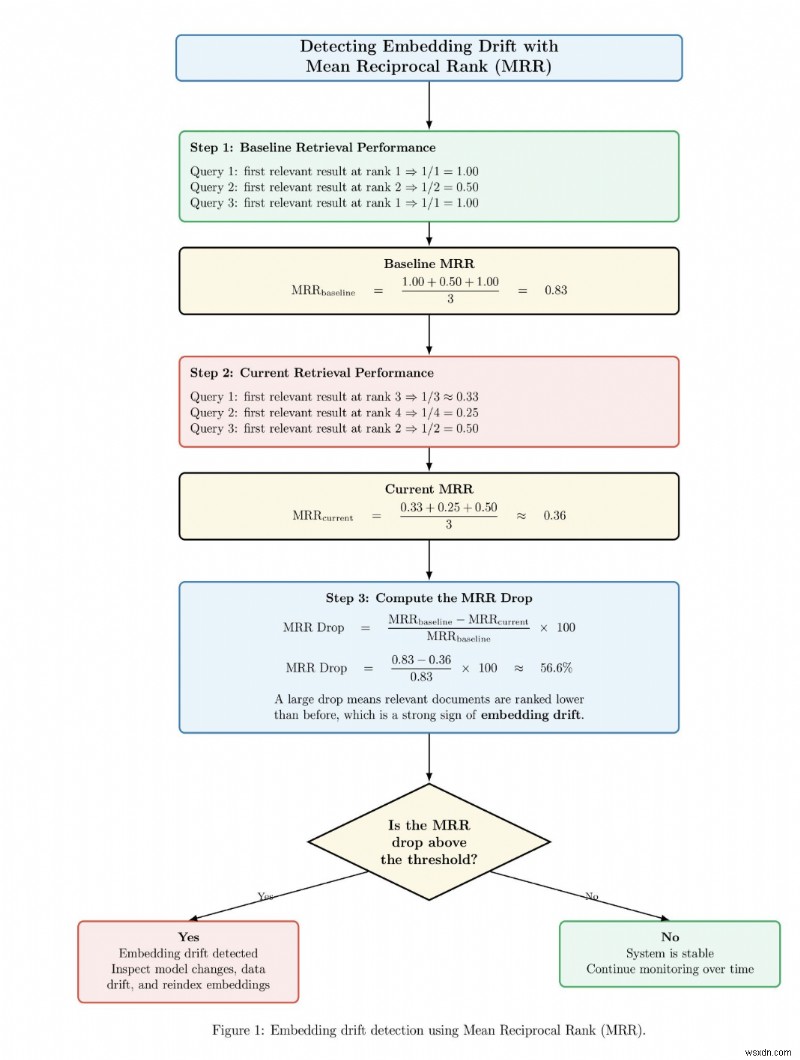
इस कारण से, उत्पादन RAG सिस्टम को स्पष्ट रूप से वर्जन किया हुआ और ऑब्जर्वेबल होने की आवश्यकता है। एम्बेडिंग को वर्जन किया जाना चाहिए। इंडेक्स बिल्ड ट्रेस करने योग्य होने चाहिए। चंकिंग नीति को प्रलेखित और पुनरुत्पादन योग्य होना चाहिए। यदि गुणवत्ता खराब होने लगती है, तो आपको ऐसे सवालों का जवाब देने में सक्षम होना चाहिए: किस एम्बेडिंग मॉडल ने इस इंडेक्स को उत्पन्न किया? इस सामग्री के चंक को बनाने वाले चंकिंग नियम क्या थे? इस दस्तावेज़ को सिस्टम में अंतिम बार कब पुनः इंजेस्ट किया गया था? इस अनुरोध को कौन सा रिट्रीवर और रीरैंकर सेवा दे रहा था?
यदि आपके पास पाइपलाइन में दृश्यता नहीं है, तो ड्रिफ्ट यादृच्छिक लगेगा। इसके साथ, यह निदान योग्य हो जाता है।
मूल्यांकन अंतराल के कारण विफलता: वास्तविक बॉटलनेक को छुपाता है
कमजोर मूल्यांकन टीमों के RAG सिस्टम को उत्पादन में तैनात करने में विफल होने का चौथा सबसे आम कारण है। हम केवल अंतिम उत्तर का मूल्यांकन करते हैं। यह पर्याप्त नहीं है।
उत्पादन-ग्रेड RAG एक पाइपलाइन है। किसी भी संख्या में लेयर पर, खराब इनपुट खराब अंतिम आउटपुट का कारण बन सकते हैं। रिट्रीवर सही दस्तावेज़ प्राप्त करने में विफल हो सकता है। रैंकर सर्वोत्तम साक्ष्य को बहुत नीचे रैंक कर सकता है। संदर्भ असेंबलर में बहुत अधिक शोर शामिल हो सकता है। जेनरेटर सबसे मजबूत पैसेज को अनदेखा कर सकता है। उत्तर एक व्यापक स्तर पर सही हो सकता है जबकि अभी भी प्राप्त साक्ष्य के प्रति पूरी तरह से अविश्वसनीय हो। यदि आप केवल अंतिम आउटपुट टेक्स्ट को स्कोर करते हैं तो आप कमजोर चरणों की पहचान नहीं कर सकते।
रिट्रीवल मेट्रिक्स का अलग से मूल्यांकन किया जाना चाहिए
इस कारण से, RAG मूल्यांकन में जेनरेशन मेट्रिक्स से अलग रिट्रीवल मेट्रिक्स शामिल होने चाहिए। रिट्रीवल मेट्रिक्स में संदर्भ सटीकता और संदर्भ रिकॉल शामिल होना चाहिए।
- संदर्भ रिकॉल: संदर्भ रिकॉल जांचता है कि प्राप्त पैसेज में प्रश्न का उत्तर देने के लिए आवश्यक जानकारी है या नहीं।
- संदर्भ सटीकता: संदर्भ सटीकता मापती है कि प्राप्त सेट ज्यादातर प्रासंगिक है या शोर से प्रदूषित है।
- रैंकिंग गुणवत्ता: रैंकिंग गुणवत्ता भी मायने रखती है, क्योंकि रैंक 1 पर एक प्रासंगिक पैसेज रैंक 10 पर उसी प्रासंगिक पैसेज से अधिक उपयोगी है।
जेनरेशन मेट्रिक्स उतना ही मायने रखते हैं
एक बार रिट्रीवल मापा जाने के बाद, जेनरेशन लेयर का मूल्यांकन अपनी शर्तों पर किया जाना चाहिए। दो प्रमुख मेट्रिक्स ग्राउंडेडनेस और वफादारी हैं।
- ग्राउंडेडनेस: ग्राउंडेडनेस पूछता है कि क्या उत्तर प्राप्त संदर्भ में प्रदान की गई जानकारी को दर्शाता है।
- वफादारी: वफादारी पूछती है कि क्या मॉडल उस संदर्भ को सटीक रूप से दर्शाता है। यह मेट्रिक मायने रखती है क्योंकि एक सिस्टम प्रशंसनीय लग सकता है जबकि अभी भी स्रोत सामग्री को गलत तरीके से प्रस्तुत कर रहा है।
अवास्तविक टेस्ट डेटा वास्तविक विफलताओं को छुपाता है
अवास्तविक टेस्ट डेटा एक और प्रमुख मुद्दा है। कई टीमें आंतरिक टीमों द्वारा सावधानीपूर्वक क्यूरेट किए गए साफ, सिंथेटिक प्रश्नों या प्रॉम्प्ट पर मूल्यांकन करती हैं। यह मौलिक रूप से वास्तविक विफलता सतह को छुपाता है। उत्पादन में मूल्यांकन स्थितियों में अस्पष्ट प्रश्न, विरोधाभासी दस्तावेज़, आंशिक उपयोगकर्ता इनपुट, पुरानी सामग्री, और ऐसी स्थितियां शामिल होनी चाहिए जहां सही उत्तर बिल्कुल भी उत्तर न देना हो। यदि डेटासेट वास्तविक उपयोगकर्ता व्यवहार को प्रतिबिंबित नहीं करता है, तो मूल्यांकन एक आराम तंत्र के बजाय एक नैदानिक उपकरण बन जाता है।
मूल्यांकन तैनाती के बाद भी जारी रहना चाहिए
मूल्यांकन प्रारंभिक रन पूरा करने के बाद नहीं रुकना चाहिए। उत्पादन RAG बदलते हैं। दस्तावेज़ बदलते हैं। एम्बेडिंग स्वैप हो जाते हैं। रैंकिंग तर्क विकसित होता है। प्रॉम्प्ट टेम्पलेट शिफ्ट होते हैं। तैनाती के बाद CI/CD और उत्पादन ट्रेसिंग के हिस्से के रूप में मूल्यांकन के बिना, आप असंतुष्ट उपयोगकर्ताओं से प्रतिगमन के बारे में जानेंगे न कि अपनी निगरानी से।
उत्पादन RAG क्यों विफल होता है जब बेंचमार्क अच्छे लगते हैं
यह वह जगह है जहां कई टीमें भ्रमित हो जाती हैं। बेंचमार्क सुधरते हैं, फिर भी लाइव सिस्टम अभी भी निराश करता है।
उत्पादन विफलताएं आमतौर पर प्रोत्साहन गलत संरेखण के कारण होती हैं। टीमें लेटेंसी बजट में फैक्टर किए बिना रिट्रीवल रिकॉल के लिए अनुकूलन करने की कोशिश करती हैं या रिट्रीवल सटीकता को ट्रैक किए बिना उच्च LLM स्कोर के लिए अनुकूलन करती हैं। रिट्रीवल की कीमत पर जेनरेशन गुणवत्ता के लिए ओवर-ट्यून किया जा सकता है, जिससे शोर आ जाता है। जेनरेशन को रिट्रीवल सुधारों के संबंध के बिना ओवर-ट्यून किया जा सकता है। रिट्रीवल और जेनरेशन सटीकता के बीच उचित अनुपात एप्लिकेशन पर निर्भर करता है। अनुपालन, कानूनी, और अन्य उच्च-दांव उपयोग के मामलों में यथासंभव अधिक वफादारी और संदर्भ सटीकता की आवश्यकता होती है। रचनात्मक उपयोग के मामले गति के बदले शोर की अनुमति दे सकते हैं।
उत्पादन एक ही मेट्रिक पर अनुकूलित नहीं है। रिट्रीवल गुणवत्ता, लेटेंसी, ताजगी, ग्राउंडेडनेस, और परिचालन सरलता के बीच ट्रेडऑफ हैं। यही कारण है कि डेमो सफलता इतनी भ्रामक हो सकती है। डेमो उन सिस्टम को पुरस्कृत करते हैं जो "सही लगते हैं"। उत्पादन विश्वसनीयता को पुरस्कृत करता है।
उत्पादन RAG सिस्टम को कैसे ठीक करें
आगे का रास्ता RAG को छोड़ना नहीं है। यह इसे एक अनुशासित रिट्रीवल सिस्टम के रूप में मानना है।
| फोकस क्षेत्र | क्या करें | यह क्यों मायने रखता है |
|---|---|---|
| रिट्रीवल गुणवत्ता | डिफ़ॉल्ट फिक्स्ड विंडो के बजाय डोमेन-अवेयर चंकिंग का उपयोग करें। जहां यह मायने रखता है दस्तावेज़ संरचना को संरक्षित करें। डेंस और लेक्सिकल रिट्रीवल को मिलाएं। रीरैंकिंग जोड़ें। मेटाडेटा का बुद्धिमानी से उपयोग करें। | कवरेज और प्रासंगिकता में सुधार करता है, और सिस्टम को ग्राउंडेड उत्तरों के लिए अधिक उपयोगी संदर्भ प्राप्त करने में मदद करता है। |
| लेटेंसी नियंत्रण | हर चरण को मापें। उन चरणों को हटाएं जो सार्थक लाभ नहीं देते। पाइपलाइन को उतना ही सरल रखें जितना उपयोग केस अनुमति देता है। वास्तविक इंटरैक्शन पैटर्न के लिए निर्माण करें। | अनावश्यक ओवरहेड को कम करता है और वास्तविक उत्पादन सेटिंग्स में सिस्टम को उत्तरदायी रखता है। |
| ड्रिफ्ट प्रबंधन | एम्बेडिंग, इंडेक्स, चंकिंग रणनीतियों, और इंजेस्टन नीतियों को वर्जन दें। जब दस्तावेज़ बदलते हैं या मॉडल स्वैप किए जाते हैं तो पुनर्मूल्यांकन करें। ताजगी को स्पष्ट रूप से इंजीनियर करें। | सामग्री, मॉडल, और क्वेरी पैटर्न के विकसित होने पर साइलेंट गुणवत्ता क्षय को रोकता है। |
| मूल्यांकन | वास्तविक क्वेरी पर आधारित गोल्डन डेटासेट बनाए रखें। रिट्रीवल मेट्रिक्स को जेनरेशन मेट्रिक्स से अलग करें। संदर्भ सटीकता, रिकॉल, ग्राउंडेडनेस, और वफादारी मापें। | केवल अंतिम उत्तर गुणवत्ता पर भरोसा करने के बजाय वास्तविक विफलता बिंदु की पहचान करने में मदद करता है। |
| निगरानी और ट्रेसिंग | तैनाती से पहले मूल्यांकन चलाएं और लॉन्च के बाद निगरानी करें। रिट्रीवल और जेनरेशन लेयर्स में ट्रेसिंग जोड़ें। | प्रतिगमन को दृश्यमान बनाता है और टीमों को उत्पादन में विफलताओं का अधिक सटीक निदान करने में मदद करता है। |
| परहेज व्यवहार | सिस्टम को यह कहने दें जब साक्ष्य गायब, पुराना, या विरोधाभासी हो। | आत्मविश्वासपूर्ण लेकिन कमजोर उत्तरों पर अनुशासित ग्राउंडिंग को पसंद करके भरोसा सुधारता है। |
FAQ अनुभाग
RAG में रिट्रीवल गुणवत्ता को कैसे मापते हैं?
हम रिट्रीवल मेट्रिक्स जैसे संदर्भ सटीकता, संदर्भ रिकॉल, और रैंकिंग गुणवत्ता का उपयोग करते हैं, और यह भी जांचते हैं कि क्या प्राप्त साक्ष्य वास्तव में उत्तर जेनरेशन का समर्थन करता है।
उत्पादन में RAG सिस्टम के विफल होने का क्या कारण है?
उत्पादन विफलताएं सबसे अधिक रिट्रीवल गुणवत्ता में गिरावट, लेटेंसी रेंगना, एम्बेडिंग/कॉर्पस ड्रिफ्ट, और खराब मूल्यांकन प्रथाओं के कारण होती हैं जो छुपाती हैं कि समस्याएं कहां शुरू होती हैं।
RAG पाइपलाइन में एम्बेडिंग ड्रिफ्ट क्या है?
एम्बेडिंग ड्रिफ्ट तब होता है जब एम्बेडिंग मॉडल, कॉर्पस, या लाइव क्वेरी व्यवहार में अपडेट धीरे-धीरे रिट्रीवल व्यवहार को बदलते हैं (प्रासंगिकता को खराब करते हैं), बिना किसी स्पष्ट रूप से टूटी हुई सिस्टम व्यवहार के।
स्केल पर RAG लेटेंसी क्यों बढ़ती है?
लेटेंसी बढ़ती है क्योंकि उत्पादन सिस्टम अक्सर क्वेरी रीराइटिंग, कई रिट्रीवल पास, रीरैंकिंग, अतिरिक्त मॉडल कॉल, और बड़े कॉर्पस जोड़ते हैं, जिनमें से सभी प्रसंस्करण समय और परिचालन जटिलता बढ़ाते हैं।
RAG में ग्राउंडेडनेस और वफादारी का मूल्यांकन कैसे करें?
आप उत्पन्न उत्तर की तुलना प्राप्त साक्ष्य से करते हैं, जांचते हैं कि क्या दावे स्रोतों द्वारा समर्थित हैं और क्या शब्दांकन आविष्कार या विरूपण के बिना उन स्रोतों को सटीक रूप से दर्शाता है।
निष्कर्ष
अधिकांश RAG सिस्टम में उत्पादन विफलता एकल विफलता बिंदु का परिणाम नहीं है। इसके बजाय, जिम्मेदार इंजीनियर देखेंगे कि अधिकांश ब्रेकडाउन एक जुड़ी हुई श्रृंखला में एक कमजोर लिंक से शुरू होते हैं। रिट्रीवल गुणवत्ता लगभग हमेशा पहली विफल होती है। इंजीनियर "इस समस्या को हल करते हैं" अधिक रिट्रीवल, अधिक संदर्भ, और अधिक ऑर्केस्ट्रेशन लेयर का लाभ उठाकर। ऐसा करने से लेटेंसी बढ़ती है। जैसे-जैसे एम्बेडिंग, कॉर्पस, और उपयोगकर्ता व्यवहार समय के साथ ड्रिफ्ट करते हैं, कमजोर मूल्यांकन मेट्रिक्स छुपाते हैं कि सिस्टम वास्तव में कहां विफल हो रहा है। उपयोगकर्ता नोटिस करना शुरू करते हैं और प्रबंधकों को समस्या का एहसास होने से पहले भरोसा खो देते हैं। तब तक, पैटर्न का टूटना रहस्यमय लगता है। हालांकि, समस्याएं शुरू से ही स्पष्ट थीं।
RAG स्केल पर इसलिए विफल नहीं होता क्योंकि पैटर्न गलत है, बल्कि इसलिए क्योंकि उत्पादन RAG सिस्टम बनाने के लिए मजबूत रिट्रीवल इंजीनियरिंग, लेटेंसी प्रबंधन, ड्रिफ्ट शमन, और निरंतर मूल्यांकन की आवश्यकता होती है। उन्हें बेहतर रैंकिंग, बेहतर चंकिंग, बेहतर ऑब्जर्वेबिलिटी, और ग्राउंडेडनेस और वफादारी के माप की मांग होती है। सबसे महत्वपूर्ण बात, टीमों को RAG को एक सेट-इट-एंड-फॉरगेट-इट डेमो आर्किटेक्चर के बजाय एक जीवित सिस्टम के रूप में देखना होगा।
संदर्भ
- उत्पादन में RAG सिस्टम: यह क्यों विफल होता है और कैसे ठीक करें
- 2026 में RAG (और LLMs) के लिए सर्वश्रेष्ठ चंकिंग रणनीतियाँ
- RAG मूल्यांकन क्या है? रिट्रीवल गुणवत्ता और उत्तर ग्राउंडेडनेस मापना
- रिट्रीवल-ऑगमेंटेड जेनरेशन मॉडल इन्फ्रेंस में सिस्टम ट्रेड-ऑफ को समझने की दिशा में
- RAGPerf: रिट्रीवल-ऑगमेंटेड जेनरेशन सिस्टम के लिए एंड-टू-एंड बेंचमार्किंग फ्रेमवर्क
- रीरैंकर्स और टू-स्टेज रिट्रीवल
- RAG से संदर्भ तक - 2025 वर्ष के अंत में RAG की समीक्षा
 यह कार्य क्रिएटिव कॉमन्स एट्रिब्यूशन-नॉनकमर्शियल-शेयरअलाइक 4.0 इंटरनेशनल लाइसेंस के तहत लाइसेंस प्राप्त है।