इस पोस्ट में, मैं बताता हूं कि कैसे मैंने Upstash Vector, Upstash Redis, Hugging Face Inference API, Replicate LLAMA-2-70B चैट मॉडल, और Vercel के साथ एक ओपन-सोर्स कस्टम कंटेंट RAG चैटबॉट बनाया। Upstash Vector ने मुझे वेक्टर डालने और क्वेरी करने में मदद की, प्रत्येक उपयोगकर्ता संदेश के लिए प्रासंगिक कॉन्टेक्स्ट को गतिशील रूप से बनाना या अपडेट करना, और Upstash Redis ने मुझे चैटबॉट वार्तालाप संग्रहीत करने में मदद की।
पूर्वापेक्षाएँ
आपको निम्नलिखित की आवश्यकता होगी:
- Node.js 18 या बाद का संस्करण
- एक Upstash खाता
- एक Hugging Face खाता
- एक Replicate खाता
- एक Vercel खाता
टेक स्टैक
| तकनीक | विवरण |
|---|---|
| Upstash | सर्वरलेस डेटाबेस प्लेटफॉर्म। हम वैक्टर और वार्तालापों को क्रमशः संग्रहीत करने के लिए Upstash Vector और Upstash Redis दोनों का उपयोग कर रहे हैं। |
| Next.js | वेब के लिए React फ्रेमवर्क। हम तेजी से प्रोटोटाइपिंग के लिए shadcn/ui का उपयोग कर रहे हैं। |
| Replicate | ओपन-सोर्स मॉडल चलाएं और फाइन-ट्यून करें। हम LLAMA-2-70B चैट मॉडल का उपयोग कर रहे हैं। |
| Hugging Face | वह प्लेटफॉर्म जहां मशीन लर्निंग समुदाय मॉडल, डेटासेट और एप्लिकेशन पर सहयोग करता है। हम एम्बेडिंग बनाने के लिए Hugging Face Inference API का उपयोग कर रहे हैं। |
| LangChain | भाषा मॉडल द्वारा संचालित एप्लिकेशन विकसित करने के लिए फ्रेमवर्क। |
| TailwindCSS | कस्टम डिजाइन बनाने के लिए CSS फ्रेमवर्क। |
| Vercel | वेब एप्लिकेशन को तैनात और स्केल करने के लिए क्लाउड प्लेटफॉर्म। |
Upstash Redis सेटअप करना
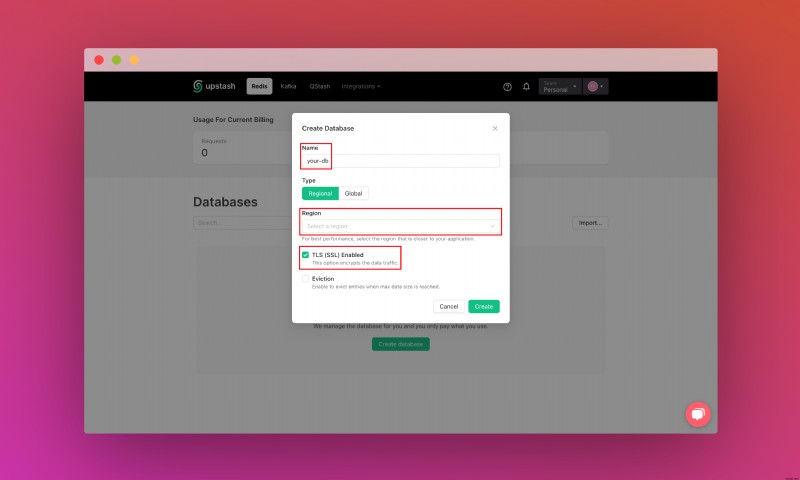
एक बार जब आप Upstash खाता बना लेते हैं और लॉग इन हो जाते हैं, तो Redis टैब पर जाएं और एक डेटाबेस बनाएं।
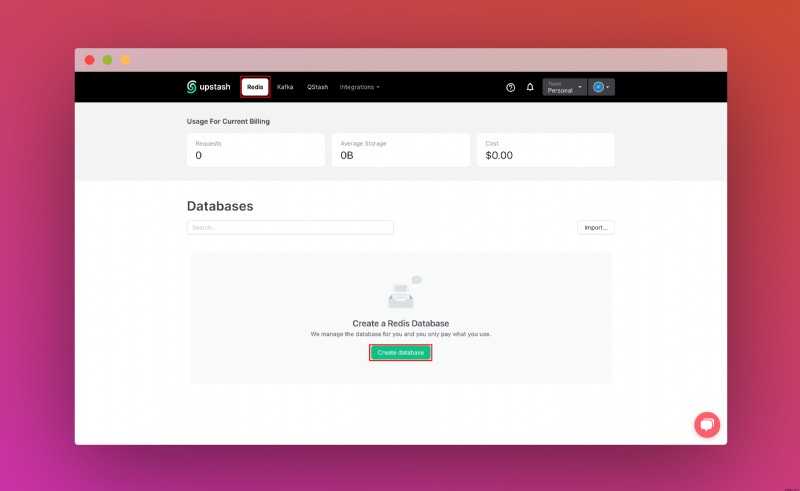
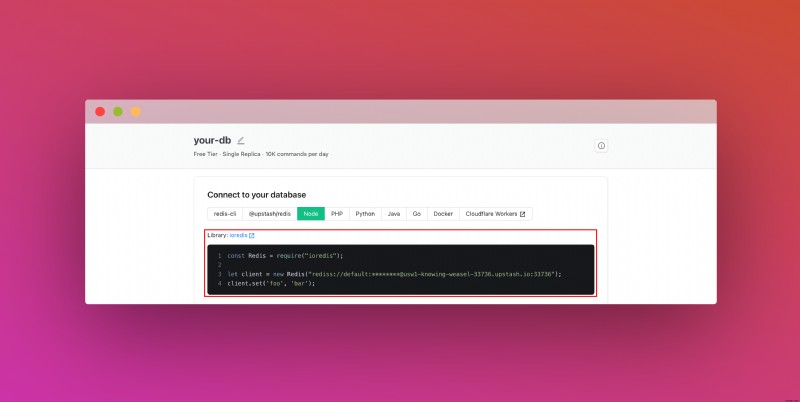
अपना डेटाबेस बनाने के बाद, आप फिर Details टैब पर जाएंगे। नीचे स्क्रॉल करें जब तक आपको Connect your database सेक्शन न मिल जाए। सामग्री को कॉपी करें और इसे कहीं सुरक्षित रखें।
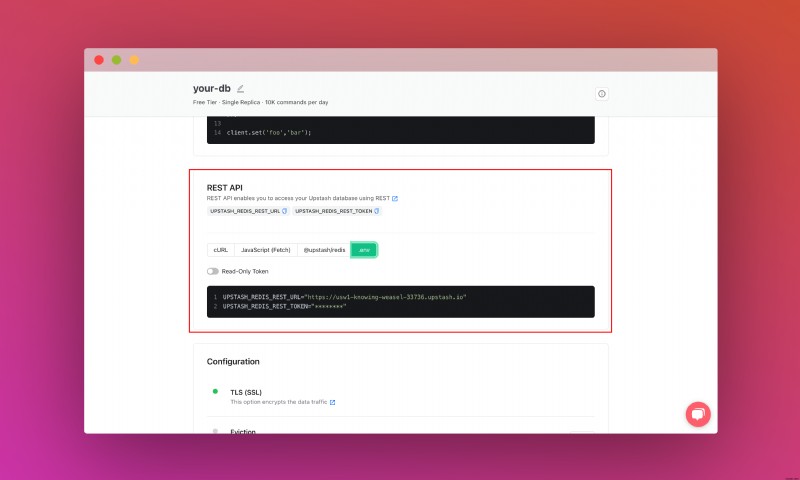
साथ ही, नीचे स्क्रॉल करें जब तक आपको REST API सेक्शन न मिल जाए और .env बटन चुनें। सामग्री को कॉपी करें और इसे कहीं सुरक्षित रखें।
Upstash Vector सेटअप करना
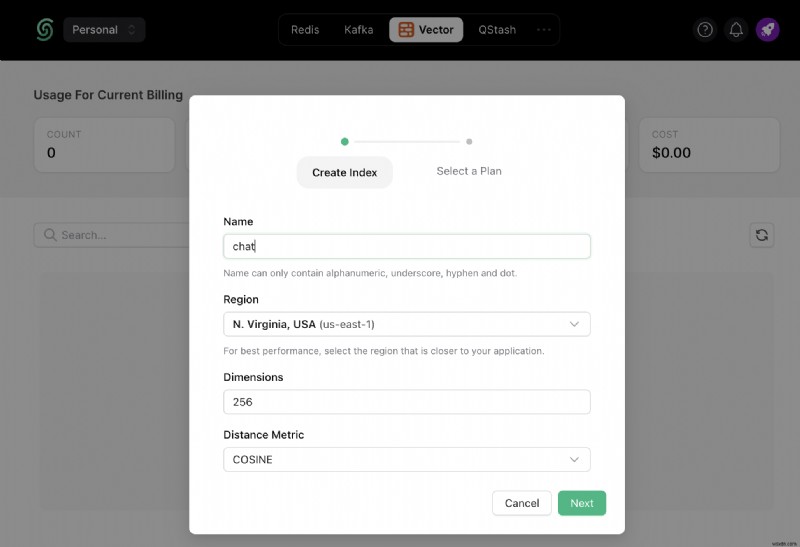
एक बार जब आप Upstash खाता बना लेते हैं और लॉग इन हो जाते हैं, तो Vector टैब पर जाएं और एक इंडेक्स बनाएं।
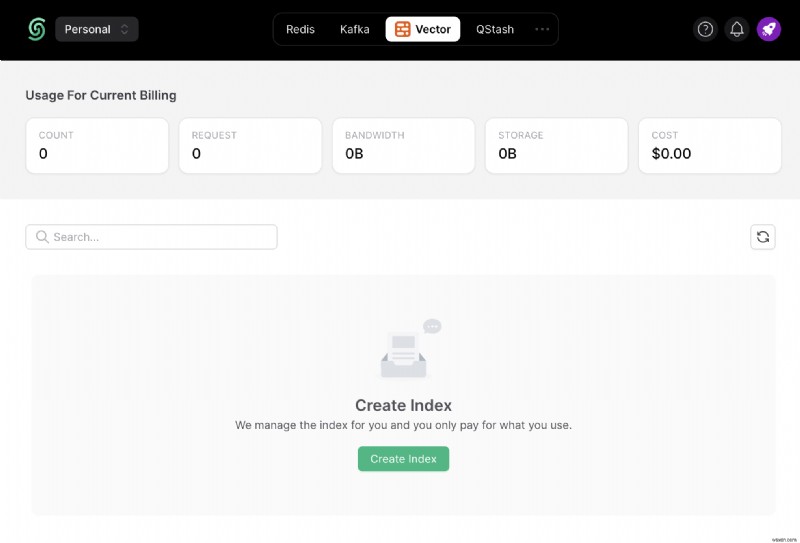
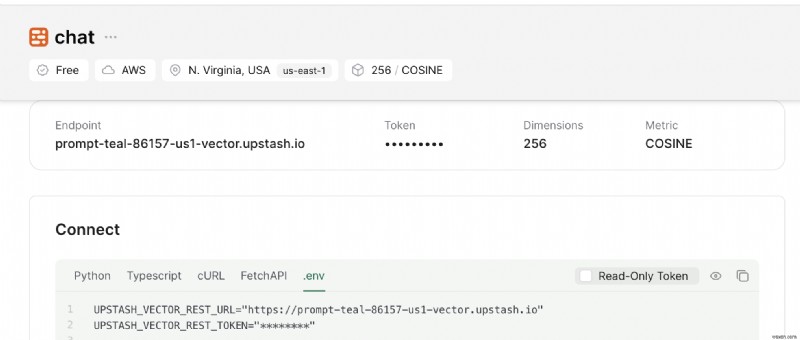
साथ ही, नीचे स्क्रॉल करें जब तक आपको Connect सेक्शन न मिल जाए और .env बटन चुनें। सामग्री को कॉपी करें और इसे कहीं सुरक्षित रखें।
प्रोजेक्ट सेटअप करना
सेटअप करने के लिए, बस ऐप रेपो क्लोन करें और इस ट्यूटोरियल का पालन करके उसमें मौजूद हर चीज को सीखें। प्रोजेक्ट को फोर्क करने के लिए, चलाएं:
git clone https://github.com/rishi-raj-jain/custom-rag-chatbot-upstash-vector
cd custom-rag-chatbot-upstash-vector
pnpm install
एक बार जब आप रेपो क्लोन कर लेते हैं, तो आप एक .env फाइल बनाने जा रहे हैं। आप ऊपर के अनुभागों से सहेजे गए आइटम जोड़ने जा रहे हैं।
यह कुछ इस तरह दिखना चाहिए:
# .env
# ऊपर के चरणों से प्राप्त
# Upstash Redis URL और Token
UPSTASH_REDIS_REST_URL="https://....upstash.io"
UPSTASH_REDIS_REST_TOKEN="..."
# Upstash Vector URL और Token
UPSTASH_VECTOR_REST_URL="https://...-vector.upstash.io"
UPSTASH_VECTOR_REST_TOKEN="..."
# Replicate API Key
REPLICATE_API_TOKEN="r8_..."
# Hugging Face Inference API Key
HUGGINGFACEHUB_API_KEY="hf_..."
इन चरणों के बाद, आप निम्न कमांड का उपयोग करके स्थानीय वातावरण शुरू करने में सक्षम होना चाहिए:
pnpm devरिपॉजिटरी संरचना
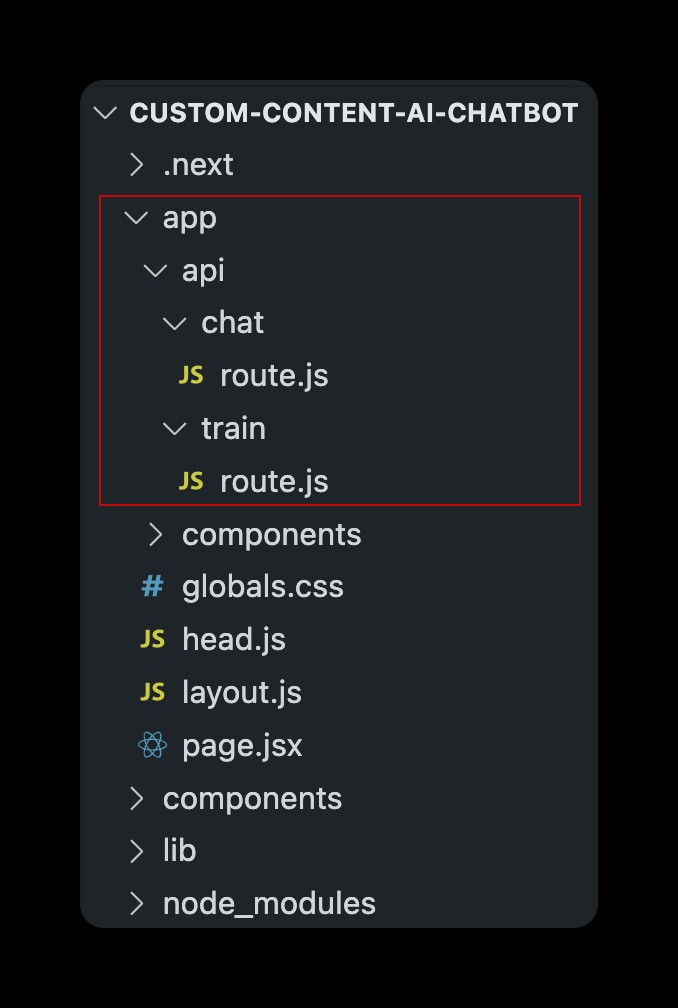
यह प्रोजेक्ट के लिए मुख्य फोल्डर संरचना है। मैंने उन फाइलों को लाल रंग में चिह्नित किया है जिन पर इस पोस्ट में आगे चर्चा की जाएगी जो AI के साथ चैट करने के लिए API रूट बनाने से संबंधित है जो आपके कस्टम कॉन्टेक्स्ट पर प्रशिक्षित है, और वैक्टर को मौजूदा इंडेक्स में upsert करके कॉन्टेक्स्ट अपडेट करना।
Next.js App Router में चैट रूट सेटअप करें
इस खंड में, हम बात करते हैं कि हमने रूट: app/api/chat/route.js को कैसे सेटअप किया है ताकि हमारी सर्वरलेस डेटाबेस में बातचीत को सिंक किया जा सके, स्ट्रिंग्स के एम्बेडिंग को गतिशील रूप से बनाया जा सके, दिए गए इंडेक्स से प्रासंगिक वैक्टर क्वेरी करके कॉन्टेक्स्ट बनाया जा सके, और LLAMA-2-70B चैट मॉडल का उपयोग करके प्रासंगिक भविष्यवाणियों का अनुरोध किया जा सके। चीजों को सरल बनाने के लिए, हम इसे और भागों में विभाजित करेंगे:
वार्तालाप संग्रहीत करना
Upstash Redis के साथ बातचीत को कैश करने के लिए, हम Redis Lists का उपयोग करेंगे। जैसे ही कोई संदेश प्रतिक्रिया देने के लिए उपयोगकर्ता से आता है, हम चैटबॉट से प्रतिक्रिया (पहले की) को सूची में सशर्त रूप से पुश करते हैं। फिर, हम उपयोगकर्ता से नवीनतम संदेश को सूची में पुश करके भी सहेजते हैं, और उस पर प्रतिक्रिया देने के लिए आगे बढ़ते हैं।
// File: app/api/chat/route.js
import { Redis } from '@upstash/redis'
// Upstash Redis इंस्टेंटिएट करें
const upstashRedis = new Redis({
  url: process.env.UPSTASH_REDIS_REST_URL,
  token: process.env.UPSTASH_REDIS_REST_TOKEN,
})
export async function POST(req) {
  try {
    // संदेशों की सरणी के रूप में पूरी चैट
    const { messages } = await req.json()
    // मान लें उपयोगकर्ता - सहायक चैट
    // चैट इतिहास में सहायक की प्रतिक्रिया जोड़ें
    if (messages.length > 1) {
      await upstashRedis.lpush('unique_conversation_id', JSON.stringify(messages[messages.length - 2]))
    }
    // उपयोगकर्ता के अनुरोध को चैट इतिहास में जोड़ें
    await upstashRedis.lpush('unique_conversation_id', JSON.stringify(messages[messages.length - 1]))
    // प्रतिक्रिया बनाने के लिए आगे बढ़ें
  }
नवीनतम संदेश का एम्बेडिंग बनाएं
दिए गए सभी कॉन्टेक्स्ट (यानी उपयोगकर्ता द्वारा प्रदान की गई कस्टम कंटेंट) में उपयोगकर्ता के नवीनतम संदेश का प्रभावी ढंग से जवाब देने के लिए, हम एक एम्बेडिंग बनाने जा रहे हैं जो हमें मौजूदा इंडेक्स से प्रासंगिक कॉन्टेक्स्ट (उर्फ समान वैक्टर) प्राप्त करने में मदद करेगा। हम Hugging Face Inference API का उपयोग LangChain के साथ एज पर सिर्फ एक API कॉल के साथ एम्बेडिंग बनाने के लिए करेंगे और प्राप्त वैक्टर को उस लंबाई तक काटेंगे जिसे हमने Upstash Vector इंडेक्स को स्पिन करते समय कॉन्फ़िगर किया था (यहां, 256)।
// File: app/api/chat/route.js
import { HuggingFaceInferenceEmbeddings } from '@langchain/community/embeddings/hf'
// Hugging Face Inference API इंस्टेंटिएट करें
const embeddings = new HuggingFaceInferenceEmbeddings()
export async function POST(req) {
  try {
    // ...
    // चैट सरणी के अंतिम संदेश में संग्रहीत नवीनतम प्रश्न प्राप्त करें
    const userMessages = messages.filter((i) => i.role === 'user')
    const lastMessage = userMessages[userMessages.length - 1].content
    // नवीनतम प्रश्न के एम्बेडिंग उत्पन्न करें
    const queryVector = (await embeddings.embedQuery(lastMessage)).slice(0, 256)
    // प्रतिक्रिया बनाने के लिए आगे बढ़ें
  }
नवीनतम संदेश के आधार पर प्रासंगिक कॉन्टेक्स्ट वैक्टर पुनर्प्राप्त करें
उपयोगकर्ता द्वारा प्रदान किए गए पूरे कॉन्टेक्स्ट को प्रति संदेश गतिशील रूप से प्राप्त करना एक महंगा ऑपरेशन है। हम केवल उपयोगकर्ता के नवीनतम संदेश के लिए प्रासंगिक कॉन्टेक्स्ट का उपयोग करना चाहते हैं, और इसे LLAMA-2-70B चैट मॉडल को सिस्टम प्रॉम्प्ट के रूप में पास करना चाहते हैं। केवल प्रासंगिक कॉन्टेक्स्ट प्राप्त करने के लिए, हम मौजूदा वैक्टर के सेट को क्वेरी करते हैं ताकि उनके मेटाडेटा सहित 2 सबसे प्रासंगिक वैक्टर प्राप्त कर सकें और उन परिणामों को फ़िल्टर कर सकें जहां कॉन्फिडेंस स्कोर 70% से अधिक हैं।
// File: app/api/chat/route.js
import { Index } from '@upstash/vector'
// Upstash Vector इंडेक्स इंस्टेंटिएट करें
const upstashVectorIndex = new Index()
export async function POST(req) {
  try {
    // ...
    // एम्बेडिंग वैक्टर से प्रासंगिक वैक्टर क्वेरी करें
    const queryResult = await upstashVectorIndex.query({
      vector: queryVector,
      // शीर्ष 2 प्रासंगिक परिणाम प्राप्त करें
      topK: 2,
      // प्रतिक्रिया में वैक्टर का पूरा सेट शामिल न करें
      includeVectors: false,
      // मेटाडेटा शामिल करें ताकि हम इंडेक्स से विवरण प्राप्त कर सकें
      includeMetadata: true,
    })
    // console.log('The query result came in', queryResult.length)
    // प्रासंगिक वैक्टर के परिणामी सेट का उपयोग करके
    // उनको फ़िल्टर करें जिनका स्कोर 70% से अधिक मेल का है
    // और प्रशिक्षण के दौरान हमारे द्वारा संग्रहीत विवरण प्राप्त करें
    const queryPrompt = queryResult
      .filter((match) => match.score && match.score > 0.7)
      .map((match) => match.metadata.description)
      .join('\n')
    // console.log('The query prompt is', queryPrompt)
    // प्रतिक्रिया बनाने के लिए आगे बढ़ें
  }
कॉन्टेक्स्ट के साथ LLAMA-2-70B चैट मॉडल को प्रॉम्प्ट करें भविष्यवाणियों के लिए
अब जब हमने प्रासंगिक कॉन्टेक्स्ट को एक स्ट्रिंग के रूप में प्राप्त कर लिया है, तो अंतिम चरण उपयोगकर्ता के नवीनतम संदेश का जवाब देने के लिए llama-2-70B चैट मॉडल को प्रॉम्प्ट करना है। हम Vercel AI SDK के experimental_buildLlama2Prompt मेथड का उपयोग करते हैं जो llama-2-70B चैट मॉडल के लिए उपयुक्त प्रॉम्प्ट फॉर्मेट बनाने का ख्याल रखता है।
// File: app/api/chat/route.js
import Replicate from 'replicate'
import { experimental_buildLlama2Prompt } from 'ai/prompts'
import { ReplicateStream, StreamingTextResponse } from 'ai'
// Replicate API इंस्टेंटिएट करें
const replicate = new Replicate({
  auth: process.env.REPLICATE_API_TOKEN,
})
export async function POST(req) {
  try {
    // ...
    const response = await replicate.predictions.create({
      // आपको स्ट्रीमिंग सक्षम करना होगा।
      stream: true,
      // मॉडल को स्ट्रीमिंग का समर्थन करना होगा। देखें https://replicate.com/docs/streaming
      // यह Llama 2 70b Chat के लिए मॉडल ID है
      version: '2c1608e18606fad2812020dc541930f2d0495ce32eee50074220b87300bc16e1',
      // संदेश सूची को Llama 2 द्वारा अपेक्षित फॉर्मेट में फॉर्मेट करें
      // @see https://github.com/vercel/ai/blob/99cf16edf0a09405d15d3867f997c96a8da869c6/packages/core/prompts/huggingface.ts#L53C1-L78C2
      input: {
        prompt: experimental_buildLlama2Prompt([
          {
            // सिस्टम कंटेंट संदेश बनाएं जिसे जोड़ा जाए
            // llama2prompt जनरेटर इसे API के साथ कॉन्टेक्स्ट के रूप में आपूर्ति करेगा
            role: 'system',
            content: queryPrompt.substring(0, Math.min(queryPrompt.length, 2000)),
          },
          // पूरी बातचीत भी पास करें!
          ...messages,
        ]),
      },
    })
    // परिणाम को फ्रंटएंड पर स्ट्रीम करें
    const stream = await ReplicateStream(response)
    return new StreamingTextResponse(stream)
  }
Next.js App Router में ट्रेन रूट सेटअप करें
इस खंड में, हम बात करते हैं कि हमने रूट: app/api/train/route.js को कैसे सेटअप किया है ताकि अनुरोध ऑब्जेक्ट में पास की गई स्ट्रिंग्स के एम्बेडिंग को गतिशील रूप से बनाया जा सके, और उन्हें Upstash Vector इंडेक्स में जोड़ा जा सके। चीजों को सरल बनाने के लिए, हम इसे और भागों में विभाजित करेंगे:
स्ट्रिंग्स के एम्बेडिंग बनाएं
हम उन स्ट्रिंग्स के एम्बेडिंग बनाने जा रहे हैं जो हमें मौजूदा इंडेक्स को सेट या अपडेट करने में मदद करेंगे। ऐसा करने से हमें चैटबॉट की भविष्य की प्रतिक्रियाओं के लिए कॉन्टेक्स्ट को अद्यतन रखने की अनुमति मिलती है। हम Hugging Face Inference API का उपयोग LangChain के साथ एज पर सिर्फ एक API कॉल के साथ एम्बेडिंग बनाने के लिए करेंगे।
// File: app/api/train/route.js
import { HuggingFaceInferenceEmbeddings } from '@langchain/community/embeddings/hf'
// Hugging Face Inference API इंस्टेंटिएट करें
const embeddings = new HuggingFaceInferenceEmbeddings()
export async function POST(req) {
  try {
    // वेक्टर एम्बेडिंग बनाने के लिए डिफ़ॉल्ट संदेशों का सेट
    let messagesToVectorize = [
      'Rishi is pretty much active on Twitter nowadays.',
      'Rishi loves writing for Upstash',
      "Rishi's recent article on building chatbot using Upstash went viral",
      'Rishi is enjoying building launchfa.st.',
    ]
    // यदि POST अनुरोध application/json प्रकार का है
    if (req.headers.get('Content-Type') === 'application/json') {
      // और यदि अनुरोध में प्रशिक्षण के लिए संदेशों की सरणी है
      const { messages } = await req.json()
      if (typeof messages !== 'string' && messages.length > 0) {
        messagesToVectorize = messages
      }
    }
    // Hugging Face Inference API को कॉल करके संदेशों पर एम्बेडिंग प्राप्त करें
    const generatedEmbeddings = await Promise.all(messagesToVectorize.map((i) => embeddings.embedQuery(i)))
    // ...
  }
प्रासंगिकता खोज के लिए वैक्टर संग्रहीत करें
जनरेटेड एम्बेडिंग को वेक्टर इंडेक्स में जोड़ने के लिए, हम प्राप्त वैक्टर को उस लंबाई तक काटते हैं जिसे हमने Upstash Vector इंडेक्स को स्पिन करते समय कॉन्फ़िगर किया था (यहां, 256) और एम्बेडिंग को मेटाडेटा के साथ सम्मिलित करने के लिए upsert मेथड का उपयोग करते हैं, यानी स्ट्रिंग्स स्वयं। यह हमें स्ट्रिंग्स को पुनर्प्राप्त करने की अनुमति देता है जब समान वैक्टर खोजे जाते हैं और इसलिए, जब हम LLAMA-2-70B चैट मॉडल को प्रतिक्रिया उत्पन्न करने के लिए कॉल करते हैं तो बातचीत के नॉलेज बेस को सेट करते हैं।
// File: app/api/train/route.js
import { Index } from '@upstash/vector'
// Upstash Vector इंडेक्स इंस्टेंटिएट करें
const upstashVectorIndex = new Index()
export async function POST(req) {
  try {
    // ...
    // वैक्टर को 256 तक की लंबाई में काटें
    await Promise.all(
      generatedEmbeddings
        .map((i) => i.slice(0, 256))
        .map((vector, index) =>
          // आने वाले प्रश्नों के लिए कॉन्टेक्स्ट के रूप में आगे विवरण के साथ वैक्टर को अपसर्ट करें
          upstashVectorIndex.upsert({
            vector,
            id: index.toString(),
            metadata: { description: messagesToVectorize[index] },
          }),
        ),
    )
    // एक बार हो जाने पर, सफल 200 प्रतिक्रिया के साथ वापस आएं
    return new Response(JSON.stringify({ code: 1 }), {
      status: 200,
      headers: { 'Content-Type': 'application/json' }
    })
  }
यह बहुत सीखने वाला था! अब आप पूरा कर चुके हैं ✨
Vercel पर तैनात करें
रिपॉजिटरी अब Vercel पर तैनात करने के लिए तैयार है। तैनात करने के लिए नीचे दिए गए चरणों का उपयोग करें 👇🏻
- अपने ऐप के कोड वाला एक GitHub रिपॉजिटरी बनाकर शुरू करें।
- फिर, Vercel डैशबोर्ड पर जाएं और एक नया प्रोजेक्ट बनाएं।
- नए प्रोजेक्ट को आपके द्वारा अभी बनाए गए GitHub रिपॉजिटरी से लिंक करें।
- सेटिंग्स में, अपने स्थानीय
.envफाइल में उनसे मेल खाने के लिएपर्यावरण चरअपडेट करें। - तैनात करें! 🚀
अधिक जानकारी
इस पोस्ट में उद्धृत संदर्भों का पता लगाकर अधिक विस्तृत जानकारी प्राप्त करें।
निष्कर्ष
अंत में, इस प्रोजेक्ट ने एम्बेडिंग बनाने, मौजूदा वैक्टर के सेट से क्वेरी करने, और LLAMA-2-70B चैट मॉडल का उपयोग करके प्रासंगिक भविष्यवाणियां बनाने के लिए कॉन्टेक्स्ट का उपयोग करने का तरीका सीखने में मूल्यवान अनुभव प्रदान किया है, जबकि एक ऐसी सेवा का उपयोग किया जाता है जो आपकी आवश्यकता के साथ स्केल होती है, यानी Upstash।