हम अगले 1-2 हफ्तों में Upstash Redis Search लॉन्च कर रहे हैं, लेकिन मैं इस बारे में कुछ शुरुआती विचार साझा करना चाहता था कि हम क्या बना रहे हैं और मैं इसके बारे में क्यों उत्साहित हूं।
हम इसे क्यों बना रहे हैं
हम 2024 से खोज क्षेत्र में हैं, Upstash Vector से शुरू करके। Vector ने लोगों को सिमेंटिक खोज लागू करने की अनुमति दी, और फिर बाद में हमने Upstash Search के साथ इस उत्पाद क्षेत्र में दोगुना निवेश किया।
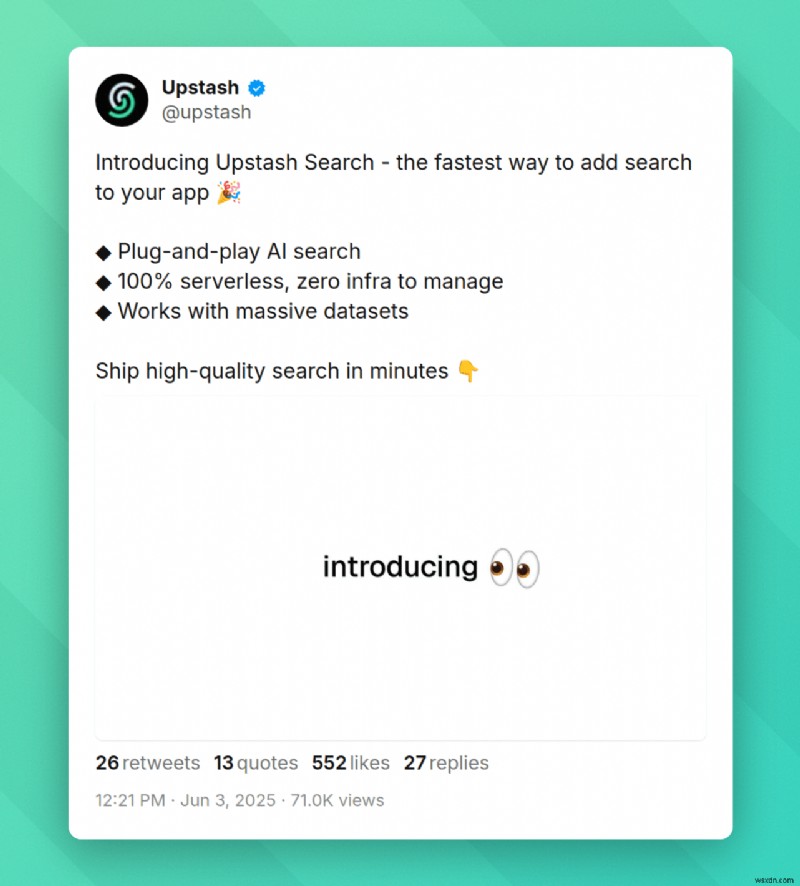
उदाहरण के लिए, यह 2025 से हमारा लॉन्च ट्वीट है जो Upstash Search, हमारे वेक्टर-आधारित सिमेंटिक खोज समाधान की घोषणा करता है 👇
और मुझे लगता है कि हम और भी बेहतर कर सकते हैं और Search से अपने सीखों पर निर्माण कर सकते हैं।
हम अधिकांश मौजूदा खोज प्रदाताओं से काफी नाखुश हैं। व्यक्तिगत रूप से मेरे लिए, उनमें से कोई भी सर्वरलेस स्पेस में अच्छी तरह फिट नहीं होता। इतना कि मैंने 2023 में AWS Cloudsearch पर अपना खुद का खोज ऐप भी बनाया था 💀
हम कुछ ऐसा चाहते थे जो:
- Redis में रहता है क्योंकि Redis तेज़ है
- Upstash Redis SDK के साथ काम करता है
- 100% टाइप-सेफ है
- रियल-टाइम सर्च-एज-यू-टाइप के लिए पर्याप्त तेज़ है
तो हम इसे बना रहे हैं।
Redis API से परे हमारा पहला विस्तार
यह हमारे लिए एक बड़ी बात है। अब तक, @upstash/redis Redis कमांड्स का लगभग 1:1 मैपिंग रहा है। Search उससे परे हमारा पहला विस्तार है।
हम हुड के तहत Tantivy का उपयोग कर रहे हैं, Apache Lucene से प्रेरित एक रस्ट में लिखा गया फुल-टेक्स्ट सर्च इंजन। यह तेज़ है। वास्तव में तेज़। और यह हमें टोकनाइजेशन, स्टेमिंग, फजी मैचिंग, फ्रेज क्वेरी, और BM25 स्कोरिंग जैसे सभी प्रिमिटिव्स देता है जिनकी हमें आवश्यकता है।
लक्ष्य इसे SDK और Upstash Redis के लिए मूल महसूस कराना है। यदि आप आज @upstash/redis का उपयोग कर रहे हैं, तो खोज जोड़ना एक अलग उत्पाद की तरह नहीं बल्कि एक प्राकृतिक विस्तार की तरह महसूस होना चाहिए।
टाइप-सेफ स्कीमा बिल्डर
एक चीज जिससे मैं वास्तव में खुश हूं वह है नया स्कीमा बिल्डर। हम एक zod-जैसे API के साथ अपने खोज योग्य फील्ड्स को परिभाषित करते हैं:
import { Redis, s } from "@upstash/redis";
const redis = Redis.fromEnv();
const schema = s.object({
  name: s.string(),
  description: s.string(),
  sku: s.string().noTokenize(),
  brand: s.string().noStem(),
  price: s.number(),
  inStock: s.boolean(),
});
const products = await redis.search.createIndex({
  name: "products",
  dataType: "json",
  prefix: "product:",
  schema,
});
.noTokenize() और .noStem() मेथड्स हमें नियंत्रित करने देते हैं कि टेक्स्ट कैसे प्रोसेस होता है:
- टोकनाइजेशन टेक्स्ट को खोज योग्य शब्दों में विभाजित करता है। प्राकृतिक भाषा के लिए बढ़िया, लेकिन SKUs जैसी चीजों को तोड़ देता है (
SKU-12345-BLKबन जाता है["SKU", "12345", "BLK"])। कोड, ईमेल, और UUIDs के लिए इसे अक्षम करें। - स्टेमिंग शब्दों को उनके मूल रूप में कम करता है ताकि "running" "run" से मेल खाए। ब्रांड नामों और उचित संज्ञाओं के लिए इसे अक्षम करें जहां हम सटीक मिलान चाहते हैं।
स्कीमा हमें क्वेरी पर पूर्ण प्रकार अनुमान देता है। यदि हम किसी ऐसे फील्ड को क्वेरी करने का प्रयास करते हैं जो मौजूद नहीं है, तो TypeScript इसे पकड़ लेगा। हम स्कीमा सिंटैक्स को zod सिंटैक्स के बहुत करीब रख रहे हैं ताकि इसका उपयोग परिचित लगे।
क्वेरी प्रिमिटिव्स
हम पांच मुख्य ऑपरेटर्स के साथ लॉन्च कर रहे हैं जो हमें लगता है कि अधिकांश खोज उपयोग के मामलों को कवर करते हैं:
$smart स्मार्ट मिलान के लिए
$smart ऑपरेटर के साथ हम स्वचालित रूप से स्मार्ट मिलान लागू करते हैं। यह ऑपरेटर बस काम करना चाहिए™ और शुरुआत करने वालों के लिए शुरू करने का सबसे अच्छा तरीका होना चाहिए।
await products.query({
  filter: {
    name: { $smart: "wirless headphones" },
  },
});
हुड के तहत, यह चलाता है:
- सटीक फ्रेज मिलान (उच्चतम बूस्ट) - "wireless headphones" आसन्न और क्रम में वाले दस्तावेज़
- स्लॉप के साथ फ्रेज (मध्यम बूस्ट) - दस्तावेज़ जहां शब्द क्रम में दिखाई देते हैं लेकिन आसन्न नहीं (जैसे wireless bose headphones)
- टर्म्स मिलान (मध्यम बूस्ट) - दस्तावेज़ जिनमें सभी टर्म्स हैं, किसी भी क्रम में
- फजी मिलान (कोई बूस्ट नहीं) - टाइपो वाले दस्तावेज़ जैसे "wireles headphone"
- अंतिम शब्द पर फजी प्रीफिक्स (कोई बूस्ट नहीं) - सर्च-एज-यू-टाइप परिदृश्यों के लिए
स्कोर को सबसे प्रासंगिक परिणाम प्राप्त करने के लिए जोड़ा जाता है। अधिकांश खोज बॉक्स के लिए, यह सचमुच वह सब है जिसकी आपको आवश्यकता है। बेशक आप इस ऑपरेटर को स्वयं लागू कर सकते हैं और सेटिंग्स के साथ खेल सकते हैं, क्योंकि यह नीचे दिए गए अन्य प्रिमिटिव ऑपरेटर्स पर बनाया गया है।
$eq सटीक समानता के लिए
उन फील्ड्स के लिए जहां हम सटीक मिलान चाहते हैं:
await products.query({
  filter: {
    name: { $eq: "wireless headphones" },
    price: { $eq: 200 },
  },
});
$phrase फ्रेज मिलान के लिए
जब हमें शब्दों को आसन्न और क्रम में प्रकट होने की आवश्यकता होती है:
await products.query({
  filter: {
    description: { $phrase: "noise cancelling" },
  },
});
हम slop भी जोड़ सकते हैं ताकि बीच में शब्दों की अनुमति हो:
await products.query({
  filter: {
    description: { $phrase: { value: "wireless headphones", slop: 2 } },
  },
});
$fuzzy टाइपो सहनशीलता के लिए
कॉन्फ़िगरेबल टाइपो सहनशीलता (जैसे 2 टाइपो) के साथ फजी मिलान के लिए:
await products.query({
  filter: {
    name: { $fuzzy: "headphonse", distance: 2 },
  },
});
$regex पैटर्न मिलान के लिए
जब हमें नियमित अभिव्यक्ति पैटर्न की आवश्यकता होती है:
await products.query({
  filter: {
    sku: { $regex: "SKU-[0-9]{5}-.*" },
  },
});
एक बात ध्यान दें: regex .noStem() वाले फील्ड्स पर सबसे अच्छा काम करता है क्योंकि स्टेम्ड टेक्स्ट अपेक्षित पैटर्न से मेल नहीं खाएगा।
विशिष्ट फील्ड्स को बूस्ट करना
हम कुछ मिलानों को अधिक वजन देने के लिए बूस्ट लागू कर सकते हैं:
await products.query({
  filter: {
    $and: [
      { name: { $smart: "wireless", $boost: 2 } },
      { description: { $smart: "wireless" } },
    ],
  },
});
यह नाम मिलानों को विवरण मिलानों से दोगुना मूल्यवान बनाता है। यह उपयोगी है जब हम चाहते हैं कि शीर्षक मिलान बॉडी मिलानों से ऊपर रैंक करें।
आगे क्या है
इस लेख में मैंने जो कुछ भी डाला है वह अभी भी बदलाव के लिए खुला है। हम अभी भी किनारों को पॉलिश कर रहे हैं और डॉक्स लिख रहे हैं। आधिकारिक लॉन्च 1-2 हफ्तों में है।
लेकिन मुझे लगता है कि यह वास्तव में अच्छा है कि हम एक साथ पहली नज़र डाल सकते हैं 👀
लॉन्च के बाद हम कुछ चीजों का पता लगा सकते हैं:
- वेक्टर खोज एकीकरण (सिमेंटिक + कीवर्ड हाइब्रिड खोज)
- ऑटोकंप्लीट और सुझाव
यदि आप जल्दी पहुंच चाहते हैं या आपके प्रश्न हैं, तो मुझे @joshtriedcoding पर संपर्क करें।
पढ़ने के लिए धन्यवाद 🙌