Codex या Claude Code जैसे AI एजेंट स्वाभाविक रूप से बाश कमांड चलाने में अत्यधिक अच्छे हैं। फाइलसिस्टम के माध्यम से खोजना, ग्रेपिंग, शेल के माध्यम से संदर्भ प्राप्त करना।
तो मैं कोशिश करना चाहता था: क्या होगा अगर एक AI एजेंट जिस फाइलसिस्टम पर काम करता है वह डिस्क के बजाय Redis में रहता है? क्या होगा अगर, AI एजेंट को, ऐसा लगता है कि यह किसी अन्य फाइलसिस्टम का उपयोग कर रहा है, लेकिन वास्तव में यह एक बहुत तेज़ इन-मेमोरी स्टोर है?
यहां बताया गया है कि मैं इसे कैसे काम करना चाहता था 👇
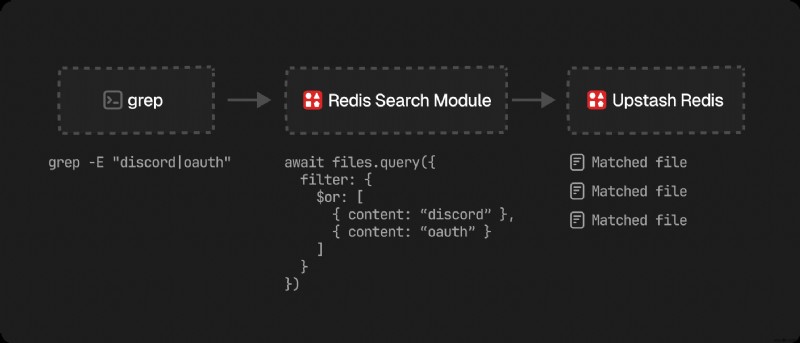
जब एजेंट एक ग्रेप कमांड चलाता है (जिसमें वे सभी असाधारण हैं), तो हम Vercel के just-bash लाइब्रेरी का उपयोग करके इसे इंटरसेप्ट करते हैं और इसे Redis Search क्वेरी में अनुवाद करते हैं।
इस तरह, हमें रीड-ओनली एक्सेस के लिए किसी सैंडबॉक्स की आवश्यकता नहीं होगी और (सिद्धांत रूप में) यह बहुत तेज़ होना चाहिए। और पता चला कि Mintlify ने पहले से ही ऐसा कुछ किया है।
विचार
यह देखने के लिए कि क्या यह काम कर सकता है, मैंने तर्क को तीन भागों में विभाजित किया
- प्रत्येक फाइल एक Redis JSON दस्तावेज़ है। हम पथ, सामग्री, आकार, टाइमस्टैम्प्स, सभी को एक कुंजी के तहत एक साथ स्टोर करते हैं।
- एक मैनिफेस्ट डायरेक्टरी ट्री को ट्रैक करता है। एक Redis कुंजी संपूर्ण फ़ोल्डर संरचना को रखती है ताकि
lsऔरtreeको कभी स्कैन न करना पड़े। - ग्रेपिंग के लिए Redis Search। इस तरह
grepको मैच खोजने के लिए हर फाइल को पढ़ने की आवश्यकता नहीं है।
और बस! इन बहुत कम चीजों के साथ, हम एक नियमित (रीड-ओनली) फाइलसिस्टम के बहुत करीब पूर्ण समानता प्राप्त कर सकते हैं, लेकिन बहुत तेज़। मैंने अभी के लिए लिखने को लागू न करने का फैसला किया।
सबसे बड़ी चुनौती: ग्रेपिंग
cat या ls जैसे कमांड बहुत सीधे हैं। हम या तो एक फाइल को पूरी तरह से पढ़ते हैं या हम एक डायरेक्टरी संरचना सूचीबद्ध करते हैं, दोनों ही Redis के साथ करना आसान है। sed -n '1,240p' जैसे कमांड थोड़े अधिक जटिल हैं, लेकिन हम Sorted Sets का उपयोग करके उन्हें पूरी तरह से काम कर सकते हैं।
ग्रेपिंग थोड़ा अलग है। एक सामान्य grep -R "oauth" /workspace को उस डायरेक्टरी के तहत हर फाइल को पढ़ना पड़ता है। एक वर्चुअल फाइलसिस्टम में इसका मतलब है कि यह जांचने के लिए कि क्या इसमें वह शब्द है, Redis से हर दस्तावेज़ को खींचना। यह वास्तव में धीमा और महंगा है।
लेकिन हमने हाल ही में Upstash Redis Search पेश किया, एक रस्ट-आधारित, अत्यंत तेज़ और कुशल तरीका Redis डेटा के माध्यम से खोज करने का। Redis Search के साथ, हम grep को चलने से पहले इंटरसेप्ट कर सकते हैं, इसे एक क्वेरी में अनुवाद कर सकते हैं, और फाइलें लाए बिना तेज़ परिणाम प्राप्त कर सकते हैं।
एक खोज क्वेरी कुछ इस तरह दिखती है:
import { Redis } from "@upstash/redis";
const redis = new Redis.fromEnv();
const index = redis.search.index({ name: "vfs" });
const matches = await index.query({
  filter: {
    $must: [
      { workspaceId: "demo" },
      { kind: "file" },
      { content: { $phrase: "oauth" } },
    ],
  },
  select: { path: true },
});
एजेंट अभी भी वही आउटपुट देखता है जो उसे एक सामान्य शेल से मिलेगा।
एक एजेंट को शेल देना
अंतिम टुकड़ा इसे just-bash से जोड़ रहा है ताकि एक एजेंट इसके खिलाफ कमांड चला सके। Mintlify ने अपने असिस्टेंट के फाइलसिस्टम को कैसे बनाया, इससे प्रेरित होकर, हम एक Redis-बैक्ड fs एडाप्टर को MountableFs पर /workspace पर माउंट करते हैं:
import { InMemoryFs, MountableFs } from "just-bash";
const mountableFs = new MountableFs({ base: new InMemoryFs() });
mountableFs.mount("/workspace", redisFs); // redisFs Upstash से बात करता है
const bash = new Bash({ fs: mountableFs, cwd: "/workspace" });
जब एजेंट cat /workspace/src/index.ts चलाता है, तो वह readFile कॉल सीधे Redis पर जाती है। grep इंटरसेप्ट हो जाता है और Redis Search पर रीडायरेक्ट हो जाता है।
एजेंट के दृष्टिकोण से यह सिर्फ एक शेल है। ls, cat, grep, find, यह सब काम करता है। जब हम इसे Vercel AI SDK में bash टूल के रूप में डालते हैं, तो हमारे पास एक एजेंट होता है जो पूरी तरह से Redis में रहने वाले कोडबेस का पता लगा सकता है।
मुझे यह विचार कैसे मिला
एक, ऊपर लिंक किए गए Mintlify के शानदार लेख के लिए। और दूसरा, अधिकांश एजेंट सैंडबॉक्स भारी हैं। हम एक कंटेनर बूट करते हैं, एक डिस्क माउंट करते हैं, और उस सब की कीमत चुकाते हैं चाहे एजेंट एक फाइल को छूए या हजार।
Redis के साथ एक वर्चुअल फाइलसिस्टम हमेशा चालू रहता है, विश्व स्तर पर रेप्लिकेटेड, टिकाऊ, और सबसे महंगा ऑपरेशन (फाइलों में खोज) वही है जिसमें Redis Search महान है।
Cheers 🙌 Josh