डेटा रेप्लिकेशन क्या है?
डेटा रेप्लिकेशन सभी डेटा संसाधनों के बीच वास्तविक समय में सभी जानकारी को समान रखने के लिए डेटा को कॉपी करने की एक विधि है। डेटाबेस रेप्लिकेशन को उस जाल के रूप में सोचें जो आपकी जानकारी को पकड़ता है और इसे दरारों से गिरने और खो जाने से बचाता है। डेटा शायद ही कभी स्थिर रहता है। यह हमेशा बदलता रहता है। यह एक सतत प्रक्रिया है जो सुनिश्चित करती है कि प्राथमिक डेटाबेस से डेटा एक रेप्लिका में दर्पण हो, भले ही वह ग्रह के दूसरी तरफ स्थित हो।
इन दिनों, "तात्कालिक" काफी तेज़ नहीं है। लेटेंसी को सब-मिलीसेकंड अंतराल तक कम करना सार्वभौमिक उद्देश्य है। हम सभी ने इस स्थिति को पहले देखा है - एक वेबसाइट पर रिफ्रेश बटन दबाना, अपनी जानकारी अपडेट देखने के लिए अनंत काल (सेकंड) जैसा महसूस होने तक इंतजार करना। लेटेंसी उपयोगकर्ता के लिए उत्पादकता घटाती है। नियर-रियल-टाइम प्राप्त करना लक्ष्य है। शून्य समय अंतराल नया आदर्श है, किसी भी उपयोग के मामले के लिए।
डेटा रेप्लिकेशन कैसे काम करता है?
डेटा रेप्लिकेशन एक होस्ट से दूसरे होस्ट में डेटा कॉपी कर रहा है, जैसे कि दो ऑन-प्रेम के बीच, या एक ऑन-प्रेम से क्लाउड में, और इसी तरह। बात यह है कि सभी उपयोगकर्ताओं के लिए डेटा के साथ रियल-टाइम स्थिरता प्राप्त करना, चाहे वे कहीं से भी डेटा एक्सेस कर रहे हों। डेटा-ड्रिवन बिजनेस मॉडल (DDBMs), जैसे गेमिंग उद्योग, रियल-टाइम डेटा के माध्यम से प्राप्त एनालिटिक्स पर बहुत अधिक भरोसा करते हैं। यह समझने के लिए कि DDBM के लिए रियल-टाइम पहुंच कितनी आवश्यक है, नीचे दिया गया वीडियो देखें:
डेटा रेप्लिकेशन के लाभ क्या हैं?
बेहतर विश्वसनीयता / आपदा पुनर्प्राप्ति
आपात स्थिति के मामले में, क्या आपका प्राथमिक इंस्टेंस समझौता किया जाना चाहिए, मिशन-महत्वपूर्ण एप्लिकेशन को एक रेप्लिका के साथ सुरक्षित रखना महत्वपूर्ण है जिसे इसके स्थान पर स्वैप किया जा सकता है। डिजास्टर रिकवरी रेप्लिकेशन विधियां बैकअप जनरेटर के समान काम करती हैं; एक महत्वपूर्ण फ्यूज उड़ाने या आपका पावर ग्रिड अंधेरा होने की कल्पना करें - आपको चिंता करने की ज़रूरत नहीं होगी क्योंकि आपके पास एक बैकअप जनरेटर है जो एक विकल्प के रूप में कूदता है और आपकी लाइट्स को चालू रखता है।
क्योंकि रेप्लिका इंस्टेंस प्राथमिक इंस्टेंस की सटीक प्रतियां हैं, आप गारंटी दे सकते हैं कि प्रदर्शन लड़खड़ाएगा नहीं, चाहे आपके प्राथमिक के साथ कुछ भी हो। यहां तक कि अगर प्राथमिक और रेप्लिका के बीच का लिंक टूट जाता है, तो प्रदर्शन अभी भी सुनिश्चित है क्योंकि प्राथमिक एक आंशिक पुनर्सिंक्रनाइज़ेशन लागू करेगा, उन कमांड को इकट्ठा करेगा जो डिस्कनेक्शन के दौरान रेप्लिका को वितरित नहीं किए गए थे। यदि संभव नहीं है, तो एक पूर्ण पुनर्सिंक्रनाइज़ेशन शुरू किया जाएगा, एक स्नैपशॉट का उपयोग करके।
ऐप प्रदर्शन में वृद्धि
डेटा को कई इंस्टेंस में फैलाकर, आप रीड प्रदर्शन को अनुकूलित करने में मदद कर रहे हैं। अपने डेटा को कई स्थानों पर पहुंच योग्य बनाकर प्रदर्शन भी अनुकूलित होता है, इस प्रकार किसी भी लेटेंसी मुद्दे को कम करता है। इसके अलावा, जब रेप्लिकास को आपके अधिकांश रीड्स को प्रोसेस करने के लिए निर्देशित किया जाता है, तो यह आपके प्राथमिक के लिए राइट्स के अधिकांश भारी उठाने से निपटने के लिए जगह खोलता है।
अधिक कुशल IT टीमें
डेटा को मैन्युअल रूप से रेप्लिकेट करने के लिए IT श्रम में कमी।
पूर्ण डेटा रेप्लिकेशन बनाम आंशिक रेप्लिकेशन को समझना
पूर्ण डेटाबेस रेप्लिकेशन तब होता है जब एक संपूर्ण प्राथमिक डेटाबेस हर उपलब्ध रेप्लिका इंस्टेंस के भीतर रेप्लिकेट होता है। यह एक समग्र दृष्टिकोण है जो पूर्व-मौजूदा, नए, और अपडेटेड डेटा को सभी गंतव्यों तक दर्शाता है। हालांकि यह दृष्टिकोण बहुत व्यापक है, यह प्रोसेसिंग पावर की एक बड़ी मात्रा की मांग करता है और कॉपी किए जा रहे डेटा के बड़े आकार के कारण नेटवर्क लोड को बढ़ाता है।
पूर्ण रेप्लिकेशन के विपरीत, आंशिक रेप्लिकेशन केवल डेटा के कुछ हिस्सों को दर्शाता है, आमतौर पर हाल ही में अपडेट किया गया डेटा। आंशिक रेप्लिकेशन किसी विशिष्ट स्थान पर डेटा के महत्व के बाद डेटा के विशेष बिट्स को अलग करता है। उदाहरण के लिए, लंदन में मुख्यालय वाली एक बड़ी वित्तीय फर्म के दुनिया भर में कई सैटेलाइट कार्यालय हो सकते हैं, जिसमें बोस्टन में एक कार्यालय, दूसरा कुआलालंपुर में, और इसी तरह।
आंशिक रेप्लिकेशन लंदन में विश्लेषकों को केवल यूके-प्रासंगिक डेटा रखने और केवल उस डेटा को उनकी आवश्यकताओं के लिए लगातार रेप्लिकेट करने की अनुमति देता है। संयुक्त राज्य अमेरिका और मलेशिया में अन्य सैटेलाइट कार्यालय, क्रमशः, वही कर सकते हैं और किसी एक सिस्टम को धीमा नहीं करते, जिससे प्रदर्शन में सुधार होता है और नेटवर्क ट्रैफ़िक कम होता है।
डेटा रेप्लिकेशन के उदाहरण
ट्रांजेक्शनल रेप्लिकेशन
डेटाबेस रेप्लिकेशन का यह रूप प्राथमिक डेटाबेस से डेटा को रियल-टाइम में एक रेप्लिका इंस्टेंस में रेप्लिकेट करता है, इन परिवर्तनों को उस क्रम में दर्शाता है जिसमें वे प्राथमिक डेटाबेस में किए गए थे। यह स्थिरता को अनुकूलित करता है। रेप्लिकेशन प्राथमिक में डेटा का एक "स्नैपशॉट" लेता है और उस स्नैपशॉट का उपयोग इस ब्लूप्रिंट के रूप में करता है कि क्या रेप्लिकेट करने की आवश्यकता है। ट्रांजेक्शनल रेप्लिकेशन के साथ, आप आवश्यकतानुसार परिवर्तनों को ट्रैक और वितरित कर सकते हैं। ट्रांजेक्शनल रेप्लिकेशन के साथ, आप आवश्यकतानुसार परिवर्तनों को ट्रैक और वितरित कर सकते हैं।
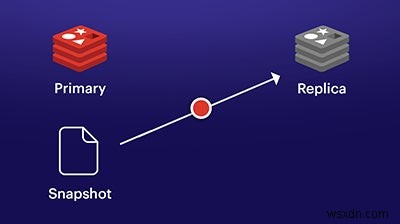
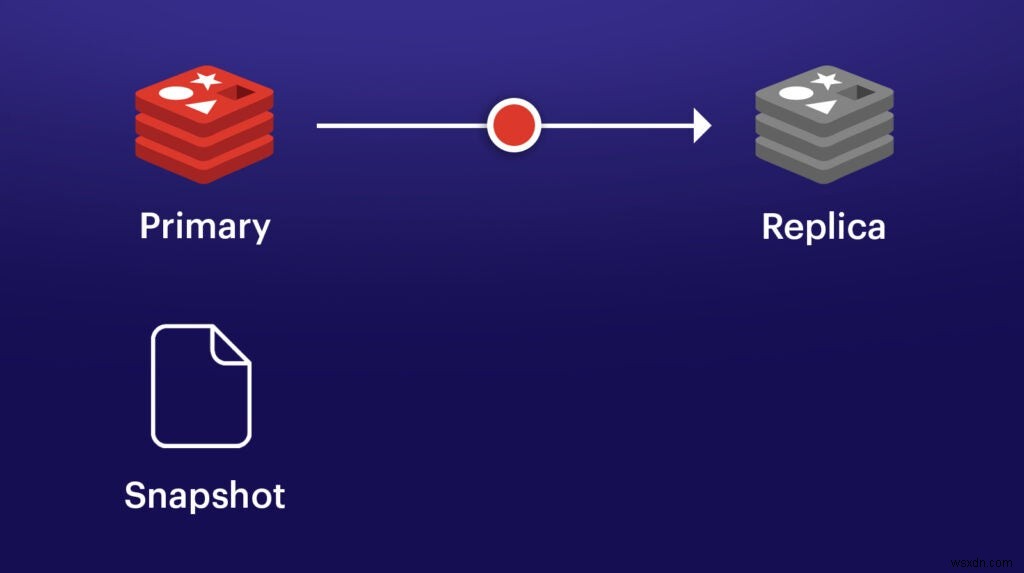
इस प्रक्रिया की वृद्धिशील प्रकृति को देखते हुए, ट्रांजेक्शनल रेप्लिकेशन बैकअप डेटाबेस विकल्प की तलाश करते समय इष्टतम विकल्प नहीं है। ट्रांजेक्शनल रेप्लिकेशन उन स्थितियों में एक उपयोगी विकल्प है जहां आपको सभी डेटा स्थानों पर रियल-टाइम स्थिरता की आवश्यकता होती है, जहां प्रत्येक छोटे परिवर्तन का हिसाब रखने की आवश्यकता होती है, न कि केवल परिवर्तनों के समग्र प्रभाव का, और यदि डेटा एक विशिष्ट स्थान से नियमित रूप से बदल रहा है।
स्नैपशॉट रेप्लिकेशन
जैसा कि इसके नाम से पता चलता है, स्नैपशॉट रेप्लिकेशन प्राथमिक से डेटा का एक "स्नैपशॉट" लेता है जैसा कि यह एक विशिष्ट क्षण में दिखाई देता है और इसे रेप्लिका के साथ आगे बढ़ाता है। एक तस्वीर की तरह, स्नैपशॉट रेप्लिकेशन डेटा को एक समय बिंदु पर कैप्चर करता है, जैसा कि यह दिखता है जब यह प्राथमिक से रेप्लिका में जाता है, लेकिन यह हिसाब नहीं रखता कि इसे बाद में कैसे अपडेट किया गया है। इस प्रकार, बैकअप बनाने के लिए स्नैपशॉट रेप्लिकेशन का उपयोग न करें।
स्टोरेज विफलता की स्थिति में, स्नैपशॉट रेप्लिकेशन के पास अद्यतन जानकारी का कोई रास्ता नहीं होगा। अपनी जानकारी को सुसंगत रखने के लिए, आप एक स्नैपशॉट से शुरू कर सकते हैं, लेकिन फिर सुनिश्चित करें कि प्राथमिक पर किए गए सभी परिवर्तनों को फिर हर रेप्लिका को पारित किया जाता है।
दूसरी ओर, यह विधि आकस्मिक विलोपन की स्थिति में पुनर्प्राप्ति के लिए काफी उपयोगी है। इसे अपने Google डॉक्स पर संस्करण इतिहास की तरह समझें। काश आप अपनी प्रस्तुति पर चार घंटे पहले की तरह काम कर सकते? अगर Google डॉक्स प्रति घंटे अंतराल पर आपके काम का स्नैपशॉट लेता है, तो आप चार घंटे पहले उस संस्करण, या "स्नैपशॉट" पर वापस क्लिक कर सकते हैं और देख सकते हैं कि आपकी जानकारी तब कैसी दिखती थी।
मर्ज रेप्लिकेशन
यह विधि आमतौर पर डेटा के एक स्नैपशॉट के साथ शुरू होती है और उस डेटा को अपने रेप्लिकास में वितरित करती है और पूरे सिस्टम के बीच डेटा की सिंक्रनाइज़ेशन को बनाए रखती है। जो मर्ज रेप्लिकेशन को अलग बनाता है वह यह है कि यह प्रत्येक नोड को डेटा में स्वतंत्र रूप से परिवर्तन करने की अनुमति देता है, लेकिन उन सभी अपडेट को एक एकीकृत पूरे में विलय कर देता है।
मर्ज रेप्लिकेशन प्रत्येक नोड पर किए गए प्रत्येक परिवर्तन का भी हिसाब रखता है। हमारे पिछले Google डॉक्स उदाहरण पर वापस जाने के लिए, यदि आपने कभी किसी दस्तावेज़ को सहकर्मियों के साथ साझा किया है जो तब आपके दस्तावेज़ पर टिप्पणियां और संपादन छोड़ते हैं, तो आप देखेंगे कि किसने क्या परिवर्तन किए और किस समय। मर्ज रेप्लिकेशन बहुत समान तरीके से कार्य करता है।
कुंजी-आधारित रेप्लिकेशन
इसे कुंजी-आधारित वृद्धिशील डेटा रेप्लिकेशन के रूप में भी जाना जाता है, यह विधि एक रेप्लिकेशन कुंजी का उपयोग करती है ताकि अंतिम अपडेट के बाद से बदले गए विशिष्ट डेटा की पहचान, पता लगा सके और बदल सके। उस जानकारी को अलग करके, यह बैकअप प्रक्रिया को सुविधाजनक बनाता है, केवल उतने ही लोड के साथ काम करता है जितना इसे करना होता है। हालांकि कुंजी-आधारित रेप्लिकेशन नए डेटा को ताज़ा करने की एक तेज़ विधि बनाता है, यह हटाए गए डेटा को रेप्लिकेट करने में विफल होने के नुकसान के साथ आता है।
एक्टिव-एक्टिव जियो-डिस्ट्रीब्यूशन
एक्टिव-एक्टिव जियो-डिस्ट्रीब्यूशन, जिसे पीयर-टू-पीयर रेप्लिकेशन के रूप में भी जाना जाता है, कुछ हद तक ट्रांजेक्शनल रेप्लिकेशन की तरह काम करता है, क्योंकि यह नोड्स के माध्यम से निरंतर ट्रांजेक्शनल डेटा पर निर्भर करता है। एक्टिव-एक्टिव के साथ, एक ही नेटवर्क में सभी नोड्स डेटाबेस को सभी संबंधित नोड्स के साथ सिंक करके एक-दूसरे को लगातार डेटा भेजते हैं। सभी नोड्स लिखने योग्य भी हैं, जिसका अर्थ है कि कोई भी डेटा को बदल सकता है, दुनिया में कहीं भी, और यह अन्य सभी नोड्स में परिलक्षित होगा। यह रियल-टाइम स्थिरता की गारंटी देता है, चाहे दुनिया में कहीं भी परिवर्तन हो।
कॉन्फ्लिक्ट-फ्री रेप्लिकेटेड डेटा टाइप्स (CRDTs) परिभाषित करते हैं कि यह डेटा कैसे रेप्लिकेट होता है। नेटवर्क विफलता की स्थिति में रेप्लिकास, या नोड्स में से एक के साथ, अन्य रेप्लिकास के पास उस नोड के ऑनलाइन वापस आने पर रेप्लिकेट करने के लिए सभी आवश्यक डेटा तैयार होंगे। यह उन उद्यमों के लिए एक ठोस समाधान है जिन्हें दुनिया भर में कई डेटा केंद्रों की आवश्यकता होती है। एक्टिव-एक्टिव जियो-डिस्ट्रीब्यूशन उपयोग के मामलों के उदाहरणों के लिए नीचे दिया गया वीडियो देखें।
सिंक्रोनस / असिंक्रोनस रेप्लिकेशन
सिंक्रोनस रेप्लिकेशन के साथ, डेटा प्राथमिक और रेप्लिका दोनों में एक ही समय में लिखा जाता है, इसलिए नाम। दूसरी ओर, असिंक्रोनस रेप्लिकेशन, प्राथमिक में राइट्स हो जाने के बाद ही डेटा को रेप्लिका में कॉपी करता है। असिंक्रोनस रेप्लिकेशन रियल-टाइम में नहीं होता है, हालांकि यह संभव है। अनुसूचित राइट ऑपरेशंस के कारण जो असिंक्रोनस के साथ बैचों में होते हैं, कभी-कभी डेटा खो जाता है, ज्यादातर मामलों में जब एक फेल-ओवर घटना होती है। फिर भी, असिंक्रोनस एक उपयुक्त समाधान है जब लंबी दूरी पर डेटा रेप्लिकेट करना होता है, क्योंकि रियल-टाइम घटक मिशन-महत्वपूर्ण कारक नहीं है।
डेटा रेप्लिकेशन कार्यान्वयन की सामान्य चुनौतियां क्या हैं?
कई इंस्टेंस में डेटा बनाए रखने के लिए संसाधनों के एक सुसंगत सेट की आवश्यकता होती है। कई रेप्लिका इंस्टेंस के साथ एक प्राथमिक होने की लागत कई उदाहरणों में काफी अधिक हो सकती है। इन संचालन को बनाए रखने और यह सुनिश्चित करने के लिए कि कोई सिस्टम विफलता न हो, विशेषज्ञों की एक समर्पित टीम की आवश्यकता होती है। और आर्किटेक्चर के आधार पर, नेटवर्क बैंडविड्थ नई प्रक्रियाओं के लागू होने पर ओवरलोड हो सकता है, जो लेटेंसी, रीड्स, और राइट्स को प्रभावित कर सकता है।
Redis डेटा रेप्लिकेशन को शीघ्र, लागत-प्रभावी, और लागू करने में सरल बनाता है। क्या आप Redis Enterprise उपचार के लिए तैयार हैं?