एन्यूमरेटर उस चीज़ के केंद्र में हैं जो Ruby को इतनी शक्तिशाली, डायनामिक भाषा बनाती है। और लेज़ी एन्यूमरेटर इसे एक कदम आगे ले जाते हैं जिससे आप अत्यधिक बड़े संग्रह के साथ कुशलतापूर्वक काम कर सकते हैं।
फाइलें - यह पता चला है - लाइनों या कैरेक्टर्स के बड़े संग्रह हैं। इसलिए लेज़ी एन्यूमरेटर उनके साथ कुछ बहुत दिलचस्प और शक्तिशाली चीजें करना संभव बनाते हैं।
एन्यूमरेटर आखिर क्या है?
हर बार जब आप `each` जैसे मेथड का उपयोग करते हैं, तो आप एक एन्यूमरेटर बनाते हैं। यही कारण है कि आप `each` जैसे मेथड को एक साथ चेन कर सकते हैं `[1,2,3].map { ... }.reduce { ... }`। आप नीचे दिए गए उदाहरण में मेरा मतलब देख सकते हैं। `each` कॉल करने से एक एन्यूमरेटर लौटता है, जिसका उपयोग मैं अन्य पुनरावृत्ति ऑपरेशन करने के लिए कर सकता हूँ।
# मैंने यह कोड Ruby के दस्तावेज़ीकरण से लिया https://ruby-doc.org/core-2.2.0/Enumerator.html enumerator = %w(one two three).each puts enumerator.class # => Enumerator enumerator.each_with_object("foo") do |item, obj| puts "#{obj}: #{item}" end # foo: one # foo: two # foo: three लेज़ी एन्यूमरेटर बड़े संग्रह के लिए हैं
सामान्य एन्यूमरेटर को बड़े संग्रह के साथ समस्याएं होती हैं। कारण यह है कि आपके द्वारा कॉल किया गया प्रत्येक मेथड पूरे संग्रह पर पुनरावृति करना चाहता है। आप इसे स्वयं देखने के लिए निम्नलिखित कोड चला सकते हैं:
# यह कोड "हैंग" होगा और आपको बाहर निकलने के लिए ctrl-c करना होगा (1..Float::INFINITY).reject { |i| i.odd? }.map { |i| i*i }.first(5) `reject` मेथड हमेशा के लिए चलता है, क्योंकि यह अनंत संग्रह पर पुनरावृति करना कभी समाप्त नहीं कर सकता।
लेकिन एक छोटे से जोड़ के साथ, कोड पूरी तरह से चलता है। यदि मैं बस `lazy` मेथड को कॉल करता हूँ, तो Ruby स्मार्ट चीज़ करता है और गणना के लिए केवल उतनी ही पुनरावृत्तियाँ करता है जितनी आवश्यक हैं। इस मामले में केवल 10 पंक्तियाँ, जो अनंत से काफी छोटी हैं।
(1..Float::INFINITY).lazy.reject { |i| i.odd? }.map { |i| i*i }.first(5) #=> [4, 16, 36, 64, 100] मोबी डिक की छह हजार प्रतियां
इन फ़ाइल ट्रिक्स को टेस्ट करने के लिए, हमें एक बड़ी फ़ाइल की आवश्यकता होगी। इतनी बड़ी कि "लेज़ी न होने की विफलता" स्पष्ट होगी।
मैंने प्रोजेक्ट गुटेनबर्ग से मोबी डिक डाउनलोड किया, और फिर 100 प्रतियों वाली एक टेक्स्ट फ़ाइल बनाई। वह काफी बड़ी नहीं थी, हालांकि। तो मैंने इसे लगभग 6,000 तक बढ़ा दिया। इसका मतलब है कि अभी मैं शायद दुनिया का अकेला आदमी हूँ जिसके पास मोबी डिक की 6,000 प्रतियों वाली एक टेक्स्ट फ़ाइल है। यह कुछ हद तक विनम्र है। लेकिन मैं विषयांतर करता हूँ।
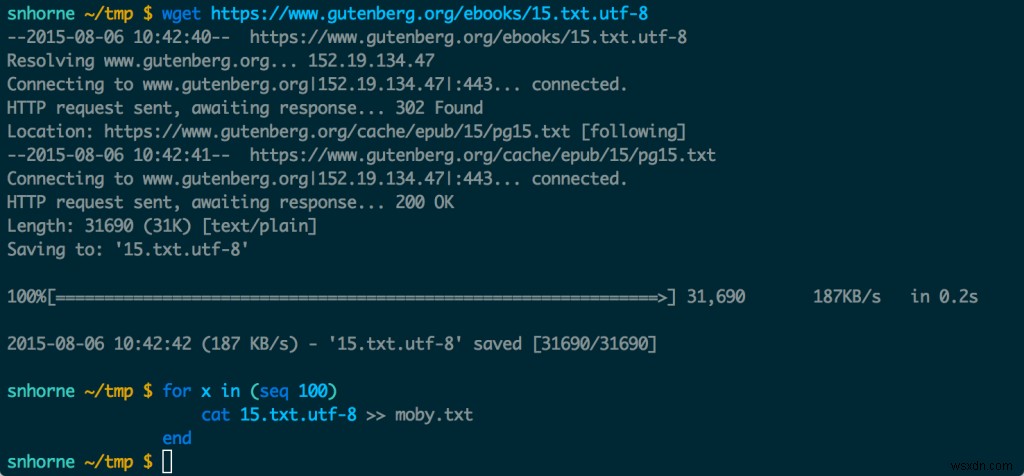 मैंने मोबी डिक डाउनलोड किया और इसे कई हजार बार डुप्लिकेट किया ताकि खेलने के लिए एक बड़ी फ़ाइल मिल सके। सिंटैक्स बैश नहीं है। यह फिश शेल है। मुझे लगता है कि मैं इसे उपयोग करने वाला अंतिम व्यक्ति हूँ।
फ़ाइल के लिए एन्यूमरेटर कैसे प्राप्त करें
यहाँ एक कूल Ruby ट्रिक है जिसका आपने शायद उपयोग किया है, भले ही आप नहीं जानते थे कि आप इसका उपयोग कर रहे हैं। Ruby में लगभग कोई भी मेथड जो एक संग्रह पर पुनरावृति करता है, यदि आप इसे ब्लॉक पास किए बिना कॉल करते हैं तो आपको एक Enumerator ऑब्जेक्ट लौटाएगा। इसका क्या मतलब है?
इस उदाहरण पर विचार करें। मैं एक फ़ाइल खोल सकता हूँ, और प्रत्येक लाइन को प्रिंट करने के लिए each_line का उपयोग कर सकता हूँ। लेकिन यदि मैं इसे ब्लॉक के बिना कॉल करता हूँ, तो मुझे एक एन्यूमरेटर मिलता है। रुचि के मेथड्स `each_line`, `each_char` और `each_codepoint` हैं।
File.open("moby.txt") do |f| # फ़ाइल में प्रत्येक लाइन प्रिंट करें f.each_line do |l| puts l end # फ़ाइल में प्रत्येक लाइन भी प्रिंट करता है। लेकिन यह `each_line` द्वारा लौटाए गए Enumerator पर `each` कॉल करके करता है f.each_line.each do |l| puts l end end ये दो उदाहरण लगभग समान दिखते हैं, लेकिन दूसरा **अद्भुत शक्तियों** को अनलॉक करने की कुंजी रखता है।
फ़ाइल के एन्यूमरेटर का उपयोग करना
एक बार जब आपके पास एक एन्यूमरेटर होता है जो फ़ाइल में सभी लाइनों को "समाहित" करता है, तो आप उन लाइनों को किसी भी Ruby सरणी की तरह स्लाइस और डाइस कर सकते हैं। यहाँ केवल कुछ उदाहरण हैं।
file.each_line.each_with_index.map { |line, i| "Line #{ i }: #{ line }" }[3, 10] file.each_line.select { |line| line.size == 9 }.first(10) file.each_line.reject { |line| line.match /whale/i } यह वास्तव में कूल है, लेकिन इन सभी उदाहरणों में एक बड़ी समस्या है। वे सभी पुनरावृति करने से पहले पूरी फ़ाइल को मेमोरी में लोड करते हैं। मोबी डिक की 6,000 प्रतियों वाली फ़ाइल के लिए, लैग ध्यान देने योग्य है।
फ़ाइल की लाइनों को लेज़ी-लोड करना
यदि हम किसी बड़े टेक्स्ट फ़ाइल को "व्हेल" शब्द के पहले 10 उदाहरणों के लिए स्कैन कर रहे हैं तो 10वें घटना के बाद देखने की वास्तव में कोई आवश्यकता नहीं है। सौभाग्य से Ruby के एन्यूमरेटर्स को ऐसा करने के लिए कहना बेहद आसान है। आप बस "lazy" कीवर्ड का उपयोग करते हैं।
नीचे दिए गए उदाहरणों में, हम कुछ बहुत परिष्कृत चीजें करने के लिए लेज़ी लोडिंग का लाभ उठाते हैं।
File.open("moby.txt") do |f| # "व्हेल" शब्द वाली पहली 3 लाइनें प्राप्त करें f.each_line.lazy.select { |line| line.match(/whale/i) }.first(3) # फ़ाइल की शुरुआत पर वापस जाएं। f.rewind # पहले तीन लाइनों को लाइन नंबर से प्रीपेंड करें f.each_line.lazy.each_with_index.map do |line, i| "LINE #{ i }: #{ line }" end.first(3) f.rewind # "व्हेल" वाली पहली तीन लाइनें उनके लाइन नंबरों के साथ प्राप्त करें f.each_line.lazy.each_with_index.map { |line, i| "LINE #{ i }: #{ line }" }.select { |line| line.match(/whale/i) }.first(3) end यह सिर्फ फ़ाइलों के लिए नहीं है
सॉकेट्स, पाइप्स, सीरियल पोर्ट्स - वे Ruby में IO क्लास का उपयोग करके दर्शाए जाते हैं। इसका मतलब है कि उन सभी के पास `each_line`, `each_char` और `each_codepoint` मेथड्स हैं। तो आप इस ट्रिक का उपयोग उन सभी के लिए कर सकते हैं। बहुत साफ!
यह जादू नहीं है
दुर्भाग्य से, लेज़ी एन्यूमरेटर केवल चीजों को गति देते हैं यदि आप जो कार्य पूरा करने की कोशिश कर रहे हैं, उसके लिए पूरी फ़ाइल पढ़ने की आवश्यकता नहीं है। यदि आप किसी ऐसे शब्द को खोज रहे हैं जो किताब के अंतिम पृष्ठ पर ही होता है, तो आपको उसे खोजने के लिए पूरी किताब पढ़नी होगी। लेकिन उस मामले में यह दृष्टिकोण नॉन-एन्यूमरेटर दृष्टिकोण से धीमा नहीं होना चाहिए।