इसमें हम MNIST डेटासेट का उपयोग करके हस्तलिखित अंक वर्गीकरण को पहचानने के लिए एक CNN को प्रशिक्षित करने के लिए PyTorch का उपयोग करने जा रहे हैं।
MNIST हस्तलिखित वर्गीकरण कार्य के लिए व्यापक रूप से उपयोग किया जाने वाला डेटासेट है जिसमें 70k से अधिक लेबल वाले 28*28 पिक्सेल ग्रेस्केल छवियां शामिल हैं। डेटासेट में लगभग 60k प्रशिक्षण छवियां और 10k परीक्षण छवियां हैं। हमारा काम 60k प्रशिक्षण छवियों का उपयोग करके एक मॉडल प्रशिक्षित करना और बाद में 10k परीक्षण छवियों पर इसकी वर्गीकरण सटीकता का परीक्षण करना है।
इंस्टॉलेशन
पहले हमें MXNet का नवीनतम संस्करण चाहिए, इसके लिए बस अपने टर्मिनल पर निम्नलिखित चलाएं:
$pip install mxnet
और आपको कुछ ऐसा मिलेगा,
Collecting mxnet
Downloading https://files.pythonhosted.org/packages/60/6f/071f9ef51467f9f6cd35d1ad87156a29314033bbf78ad862a338b9eaf2e6/mxnet-1.2.0-py2.py3-none-win32.whl (12.8MB)
100% |████████████████████████████████| 12.8MB 131kB/s
Requirement already satisfied: numpy in c:\python\python361\lib\site-packages (from mxnet) (1.16.0)
Collecting graphviz (from mxnet)
Downloading https://files.pythonhosted.org/packages/1f/e2/ef2581b5b86625657afd32030f90cf2717456c1d2b711ba074bf007c0f1a/graphviz-0.10.1-py2.py3-none-any.whl
….
….
Installing collected packages: graphviz, mxnet
Successfully installed graphviz-0.10.1 mxnet-1.2.0
दूसरा, हमें torch और torchvision लाइब्रेरी चाहिए - यदि यह नहीं है तो आप इसे pip का उपयोग करके इंस्टॉल कर सकते हैं।
लाइब्रेरी आयात करें
import torch
import torchvision
MNIST डेटासेट लोड करें
इससे पहले कि हम अपने प्रोग्राम पर काम करना शुरू करें, हमें MNIST डेटासेट चाहिए। तो आइए छवियों और लेबल को मेमोरी में लोड करें और उन हाइपरपैरामीटर्स को परिभाषित करें जिनका हम इस प्रयोग के लिए उपयोग करने जा रहे हैं।
# n_epochs वे संख्या हैं जितनी बार हम पूरे प्रशिक्षण डेटासेट पर लूप करेंगे
n_epochs = 3
batch_size_train = 64
batch_size_test = 1000
# लर्निंग_रेट और मोमेंटम ऑप्टिमाइज़र के लिए हैं
learning_rate = 0.01
momentum = 0.5
log_interval = 10
random_seed = 1
torch.backends.cudnn.enabled = False
torch.manual_seed(random_seed)
<torch._C.Generator at 0x2048010c690>
अब हम TorchVision का उपयोग करके MNIST डेटासेट लोड करने जा रहे हैं। हम इस डेटासेट पर प्रशिक्षण के लिए 64 के बैच_आकार और परीक्षण के लिए आकार 1000 का उपयोग कर रहे हैं। सामान्यीकरण के लिए, हम MNIST डेटासेट के 0.1307 के माध्य मान और 0.3081 के मानक विचलन का उपयोग करेंगे।
train_loader = torch.utils.data.DataLoader(
    torchvision.datasets.MNIST('/files/', train=True, download=True,
        transform=torchvision.transforms.Compose([
            torchvision.transforms.ToTensor(),
            torchvision.transforms.Normalize(
                (0.1307,), (0.3081,))
        ])
    ),
    batch_size=batch_size_train, shuffle=True)

test_loader = torch.utils.data.DataLoader(
    torchvision.datasets.MNIST('/files/', train=False, download=True,
        transform=torchvision.transforms.Compose([
            torchvision.transforms.ToTensor(),
            torchvision.transforms.Normalize(
                (0.1307,), (0.3081,))
        ])
    ),
    batch_size=batch_size_test, shuffle=True)
आउटपुट
Downloading https://yann.lecun.com/exdb/mnist/train-images-idx3-ubyte.gz
Downloading https://yann.lecun.com/exdb/mnist/train-labels-idx1-ubyte.gz
Downloading https://yann.lecun.com/exdb/mnist/t10k-images-idx3-ubyte.gz
Downloading https://yann.lecun.com/exdb/mnist/t10k-labels-idx1-ubyte.gz
Processing... Done!
परीक्षण डेटा लोड करने के लिए test_loader का उपयोग करें
examples = enumerate(test_loader)
batch_idx, (example_data, example_targets) = next(examples)
example_data.shape
आउटपुट
torch.Size([1000, 1, 28, 28])
आउटपुट से हम देख सकते हैं कि हमारे पास एक टेस्ट डेटा बैच 1000, 1, 28, 28 के आकार का टेंसर है जिसका अर्थ है - 1000 उदाहरण 28*28 पिक्सेल ग्रेस्केल में।
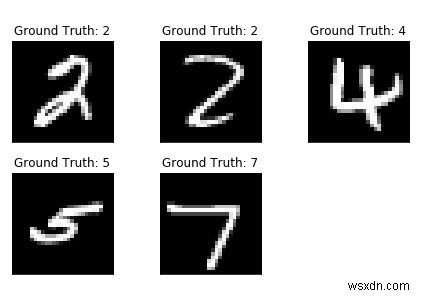
आइए matplotlib का उपयोग करके डेटासेट के कुछ प्लॉट करें।
import matplotlib.pyplot as plt
fig = plt.figure()
for i in range(5):
    plt.subplot(2,3,i+1)
    plt.tight_layout()
    plt.imshow(example_data[i][0], cmap='gray', interpolation='none')
    plt.title("Ground Truth: {}".format(example_targets[i]))
    plt.xticks([])
    plt.yticks([])
print(fig)
आउटपुट
नेटवर्क बनाना
अब हम दो पूरी तरह से जुड़ी हुई परतों के बाद 2-D कन्वोल्यूशनल परतों का उपयोग करके अपना नेटवर्क बनाने जा रहे हैं। हम उस नेटवर्क के लिए एक नई क्लास बनाने जा रहे हैं जिसे हम बनाना चाहते हैं लेकिन उससे पहले आइए कुछ मॉड्यूल आयात करें।
import torch.nn as nn
import torch.nn.functional as F
import torch.optim as optim

class Net(nn.Module):
    def __init__(self):
        super(Net, self).__init__()
        self.conv1 = nn.Conv2d(1, 10, kernel_size=5)
        self.conv2 = nn.Conv2d(10, 20, kernel_size=5)
        self.conv2_drop = nn.Dropout2d()
        self.fc1 = nn.Linear(320, 50)
        self.fc2 = nn.Linear(50, 10)
    def forward(self, x):
        x = F.relu(F.max_pool2d(self.conv1(x), 2))
        x = F.relu(F.max_pool2d(self.conv2_drop(self.conv2(x)), 2))
        x = x.view(-1, 320)
        x = F.relu(self.fc1(x))
        x = F.dropout(x, training=self.training)
        x = self.fc2(x)
        return F.log_softmax(x)
नेटवर्क और ऑप्टिमाइज़र इनिशियलाइज़ करें:
network = Net()
optimizer = optim.SGD(network.parameters(), lr=learning_rate, momentum=momentum)
मॉडल प्रशिक्षण
आइए अपना प्रशिक्षण मॉडल बनाएं। तो पहले जांचें कि हमारा नेटवर्क प्रशिक्षण मोड में है और फिर प्रति युग एक बार समग्र प्रशिक्षण डेटा पर पुनरावृति करें। डेटालोडर व्यक्तिगत बैच लोड करेगा। हम optimizer.zero_grad() का उपयोग करके ग्रेडिएंट को शून्य पर सेट करते हैं।
train_losses = []
train_counter = []
test_losses = []
test_counter = [i*len(train_loader.dataset) for i in range(n_epochs + 1)]
एक अच्छा प्रशिक्षण वक्र बनाने के लिए, हम प्रशिक्षण और परीक्षण हानि को सहेजने के लिए दो सूचियां बनाते हैं। x-अक्ष पर हम देखे गए प्रशिक्षण उदाहरणों की संख्या प्रदर्शित करना चाहते हैं।
backward() कॉल जिसे हम अब एक नया ग्रेडिएंट सेट एकत्र करते हैं जिसे हम optimizer.step() का उपयोग करके नेटवर्क के प्रत्येक पैरामीटर में वापस प्रसारित करते हैं।
def train(epoch):
    network.train()
    for batch_idx, (data, target) in enumerate(train_loader):
        optimizer.zero_grad()
        output = network(data)
        loss = F.nll_loss(output, target)
        loss.backward()
        optimizer.step()
        if batch_idx % log_interval == 0:
            print('Train Epoch: {} [{}/{} ({:.0f}%)]\tLoss: {:.6f}'.format(
                epoch, batch_idx * len(data), len(train_loader.dataset),
                100. * batch_idx / len(train_loader), loss.item()))
            train_losses.append(loss.item())
            train_counter.append(
                (batch_idx*64) + ((epoch-1)*len(train_loader.dataset)))
            torch.save(network.state_dict(), '/results/model.pth')
            torch.save(optimizer.state_dict(), '/results/optimizer.pth')
न्यूरल नेटवर्क मॉड्यूल, साथ ही ऑप्टिमाइज़र, .state_dict() का उपयोग करके अपने आंतरिक स्थिति को सहेजने और लोड करने की क्षमता रखते हैं।
अब हमारे टेस्ट लूप के लिए, हम टेस्ट लॉस को जोड़ते हैं और नेटवर्क की सटीकता की गणना करने के लिए सही ढंग से वर्गीकृत अंकों का ट्रैक रखते हैं।
def test():
    network.eval()
    test_loss = 0
    correct = 0
    with torch.no_grad():
        for data, target in test_loader:
            output = network(data)
            test_loss += F.nll_loss(output, target, size_average=False).item()
            pred = output.data.max(1, keepdim=True)[1]
            correct += pred.eq(target.data.view_as(pred)).sum()
    test_loss /= len(test_loader.dataset)
    test_losses.append(test_loss)
    print('\nTest set: Avg. loss: {:.4f}, Accuracy: {}/{} ({:.0f}%)\n'.format(
        test_loss, correct, len(test_loader.dataset),
        100. * correct / len(test_loader.dataset)))
प्रशिक्षण चलाने के लिए, हम n_epochs पर लूप करने से पहले test() कॉल जोड़ते हैं ताकि यादृच्छिक रूप से प्रारंभ किए गए पैरामीटर के साथ हमारे मॉडल का मूल्यांकन किया जा सके।
test()
for epoch in range(1, n_epochs + 1):
    train(epoch)
    test()
आउटपुट
Test set: Avg. loss: 2.3048, Accuracy: 1063/10000 (10%)
Train Epoch: 1 [0/60000 (0%)]Loss: 2.294911
Train Epoch: 1 [640/60000 (1%)]Loss: 2.314225
...
Train Epoch: 3 [59520/60000 (99%)]Loss: 0.318569
Test set: Avg. loss: 0.0912, Accuracy: 9716/10000 (97%)
मॉडल के प्रदर्शन का मूल्यांकन
तो केवल 3 युगों के प्रशिक्षण के साथ हम परीक्षण सेट पर 97% सटीकता प्राप्त करने में कामयाब रहे। यादृच्छिक रूप से प्रारंभ किए गए पैरामीटर के साथ, हमने प्रशिक्षण शुरू करने से पहले परीक्षण सेट पर 10% सटीकता के साथ शुरुआत की।
आइए अपना प्रशिक्षण वक्र प्लॉट करें:
fig = plt.figure()
plt.plot(train_counter, train_losses, color='blue')
plt.scatter(test_counter, test_losses, color='red')
plt.legend(['Train Loss', 'Test Loss'], loc='upper right')
plt.xlabel('number of training examples seen')
plt.ylabel('negative log likelihood loss')
fig
आउटपुट
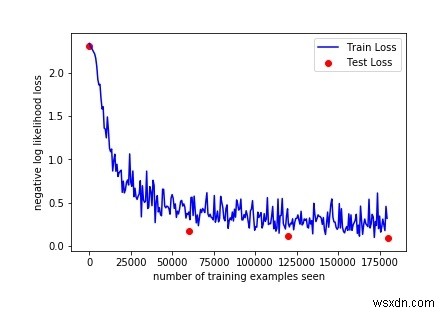
उपरोक्त आउटपुट की जांच करके, हम कुछ और परिणाम देखने के लिए युगों की संख्या बढ़ा सकते हैं, क्योंकि 3 युगों की जांच करके सटीकता बढ़ी है।
लेकिन उससे पहले, कुछ और उदाहरण चलाएं और मॉडल के आउटपुट की तुलना करें:
with torch.no_grad():
    output = network(example_data)
fig = plt.figure()
for i in range(6):
    plt.subplot(2,3,i+1)
    plt.tight_layout()
    plt.imshow(example_data[i][0], cmap='gray', interpolation='none')
    plt.title("Prediction: {}".format(output.data.max(1, keepdim=True)[1][i].item()))
    plt.xticks([])
    plt.yticks([])
fig
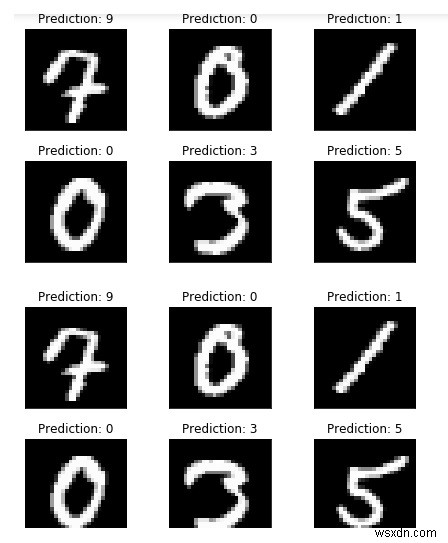
जैसा कि हम अपने मॉडल के पूर्वानुमान देख सकते हैं, यह उन उदाहरणों के लिए बिंदु पर दिखता है।