लॉजिस्टिक रिग्रेशन बाइनरी परिणाम की भविष्यवाणी करने की एक सांख्यिकीय तकनीक है। यह कोई नई चीज नहीं है क्योंकि यह वर्तमान में वित्त से लेकर चिकित्सा, अपराध विज्ञान और अन्य सामाजिक विज्ञानों तक के क्षेत्रों में लागू की जा रही है।
इस सेक्शन में हम पायथन का उपयोग करके लॉजिस्टिक रिग्रेशन विकसित करने जा रहे हैं, हालांकि आप इसे R जैसी अन्य भाषाओं का उपयोग करके भी इम्प्लीमेंट कर सकते हैं।
इंस्टॉलेशन
हम अपने उदाहरण प्रोग्राम में नीचे दी गई लाइब्रेरीज़ का उपयोग करने जा रहे हैं:
- NumPy: न्यूमेरिकल ऐरे और मैट्रिक्स को परिभाषित करने के लिए
- Pandas: डेटा को हैंडल और ऑपरेट करने के लिए
- Statsmodels: पैरामीटर एस्टीमेशन और स्टैटिस्टिकल टेस्टिंग के लिए
- Pylab: प्लॉट्स जनरेट करने के लिए
आप CLI में नीचे दी गई कमांड चलाकर उपरोक्त लाइब्रेरीज़ को pip का उपयोग करके इंस्टॉल कर सकते हैं।
>pip install numpy pandas statsmodels
लॉजिस्टिक रिग्रेशन के लिए उदाहरण उपयोग का मामला
पायथन में अपने लॉजिस्टिक रिग्रेशन का परीक्षण करने के लिए, हम UCLA (इंस्टीट्यूट फॉर डिजिटल रिसर्च एंड एजुकेशन) द्वारा प्रदान किए गए लॉजिट रिग्रेशन डेटा का उपयोग करने जा रहे हैं। आप नीचे दिए गए लिंक से CSV फॉर्मेट में डेटा एक्सेस कर सकते हैं: https://stats.idre.ucla.edu/stat/data/binary.csv
मैंने इस CSV फाइल को अपनी स्थानीय मशीन में सेव किया है और वहीं से डेटा पढ़ूंगा, आप चाहें तो सीधे लिंक से भी पढ़ सकते हैं। इस CSV फाइल के साथ हम उन विभिन्न कारकों की पहचान करने जा रहे हैं जो ग्रेजुएट स्कूल में प्रवेश को प्रभावित कर सकते हैं।
आवश्यक लाइब्रेरीज़ इम्पोर्ट करें और डेटासेट लोड करें
import pandas as pd
import statsmodels.api as sm
import pylab as pl
import numpy as np

df = pd.read_csv('binary.csv')
# हम डेटा को सीधे लिंक से भी पढ़ सकते हैं
# df = pd.read_csv('https://stats.idre.ucla.edu/stat/data/binary.csv')
print(df.head())
आउटपुट
   admit  gre  gpa  rank
0      0  380 3.61     3
1      1  660 3.67     3
2      1  800 4.00     1
3      1  640 3.19     4
4      0  520 2.93     4
जैसा कि हम उपरोक्त आउटपुट से देख सकते हैं, एक कॉलम का नाम 'rank' है, यह समस्या पैदा कर सकता है क्योंकि 'rank' पैंडास डेटाफ्रेम में मेथड का नाम भी है। किसी भी टकराव से बचने के लिए, मैं rank कॉलम का नाम 'prestige' में बदल रहा हूं। तो आइए डेटासेट कॉलम का नाम बदलें:
df.columns = ["admit", "gre", "gpa", "prestige"]
print(df.columns)
आउटपुट
Index(['admit', 'gre', 'gpa', 'prestige'], dtype='object')
डेटा सारांशित करें
पैंडास फंक्शन describe का उपयोग करके हमें हर चीज का सारांश दृश्य मिलेगा।
print(df.describe())
आउटपुट
           admit         gre         gpa    prestige
count  400.000000  400.000000  400.000000  400.00000
mean     0.317500  587.700000   3.389900   2.48500
std      0.466087  115.516536   0.380567   0.94446
min      0.000000  220.000000   2.260000   1.00000
25%      0.000000  520.000000   3.130000   2.00000
50%      0.000000  580.000000   3.395000   2.00000
75%      1.000000  660.000000   3.670000   3.00000
max      1.000000  800.000000   4.000000   4.00000
हम अपने डेटा के प्रत्येक कॉलम का स्टैंडर्ड डेविएशन और प्रेस्टीज और किसी को प्रवेश मिला या नहीं, इसकी फ्रीक्वेंसी टेबल प्राप्त कर सकते हैं।
# प्रत्येक कॉलम का स्टैंडर्ड डेविएशन देखें
print(df.std())
आउटपुट
admit      0.466087
gre      115.516536
gpa        0.380567
prestige   0.944460
dtype: float64
# प्रेस्टीज और किसी को प्रवेश मिला या नहीं, इसकी फ्रीक्वेंसी टेबल
print(pd.crosstab(df['admit'], df['prestige'], rownames=['admit']))
आउटपुट
prestige   1   2   3   4
admit
0         28  97  93  55
1         33  54  28  12
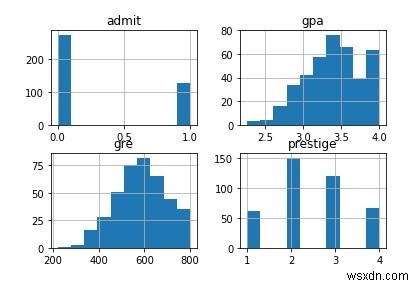
आइए डेटासेट के सभी कॉलम्स प्लॉट करें।
# डेटासेट के सभी कॉलम्स प्लॉट करें
df.hist()
pl.show()
आउटपुट
डमी वेरिएबल्स
पायथन पैंडास लाइब्रेरी इस बात में बहुत लचीलापन प्रदान करती है कि हम कैटेगोरिकल वेरिएबल्स को कैसे दर्शाते हैं।
# प्रेस्टीज को डमीफाई करें
dummy_ranks = pd.get_dummies(df['prestige'], prefix='prestige')
print(dummy_ranks.head())
आउटपुट
   prestige_1  prestige_2  prestige_3  prestige_4
0           0           0           1           0
1           0           0           1           0
2           1           0           0           0
3           0           0           0           1
4           0           0           0           1
# रिग्रेशन के लिए एक साफ डेटा फ्रेम बनाएं
cols_to_keep = ['admit', 'gre', 'gpa']
data = df[cols_to_keep].join(dummy_ranks.iloc[:, 'prestige_2':])
आउटपुट
   admit  gre   gpa  prestige_2  prestige_3  prestige_4
0      0  380  3.61           0           1           0
1      1  660  3.67           0           1           0
2      1  800  4.00           0           0           0
3      1  640  3.19           0           0           1
4      0  520  2.93           0           0           1
रिग्रेशन करना
अब हम लॉजिस्टिक रिग्रेशन करने जा रहे हैं, जो काफी सरल है। हम बस उस कॉलम को निर्दिष्ट करते हैं जिसमें वह वेरिएबल होता है जिसे हम भविष्यवाणी करने की कोशिश कर रहे हैं, उसके बाद वे कॉलम जिनका उपयोग मॉडल को भविष्यवाणी करने के लिए करना चाहिए।
अब हम admit कॉलम की भविष्यवाणी gre, gpa और प्रेस्टीज डमी वेरिएबल्स prestige_2, prestige_3 और prestige_4 के आधार पर कर रहे हैं।
train_cols = data.columns[1:]  # Index([gre, gpa, prestige_2, prestige_3, prestige_4], dtype=object)
logit = sm.Logit(data['admit'], data[train_cols])
# मॉडल फिट करें
result = logit.fit()
आउटपुट
Optimization terminated successfully.
Current function value: 0.573147
Iterations 6
परिणाम की व्याख्या
आइए statsmodels का उपयोग करके सारांश आउटपुट जनरेट करें।
print(result.summary2())
आउटपुट
Results: Logit
===============================================================
Model:              Logit              No. Iterations: 6.0000
Dependent Variable: admit              Pseudo R-squared: 0.083
Date:               2019-03-03 14:16   AIC: 470.5175
No. Observations:   400                BIC: 494.4663
Df Model:           5                  Log-Likelihood: -229.26
Df Residuals:       394                LL-Null: -249.99
Converged:          1.0000             Scale: 1.0000
----------------------------------------------------------------
            Coef.  Std.Err.    z    P>|z|    [0.025   0.975]
----------------------------------------------------------------
gre         0.0023  0.0011   2.0699  0.0385   0.0001   0.0044
gpa         0.8040  0.3318   2.4231  0.0154   0.1537   1.4544
prestige_2 -0.6754  0.3165  -2.1342  0.0328  -1.2958  -0.0551
prestige_3 -1.3402  0.3453  -3.8812  0.0001  -2.0170  -0.6634
prestige_4 -1.5515  0.4178  -3.7131  0.0002  -2.3704  -0.7325
intercept  -3.9900  1.1400  -3.5001  0.0005  -6.2242  -1.7557
============================================================
उपरोक्त रिजल्ट ऑब्जेक्ट हमें मॉडल आउटपुट के भागों को अलग करने और निरीक्षण करने की भी अनुमति देता है।
# प्रत्येक कोएफिशिएंट के कॉन्फिडेंस इंटरवल को देखें
print(result.conf_int())
आउटपुट
                    0         1
gre           0.000120   0.004409
gpa           0.153684   1.454391
prestige_2   -1.295751  -0.055135
prestige_3   -2.016992  -0.663416
prestige_4   -2.370399  -0.732529
intercept    -6.224242  -1.755716
उपरोक्त आउटपुट से, हम देख सकते हैं कि उम्मीदवार के अंडरग्रेजुएट स्कूल की प्रतिष्ठा और प्रवेश की संभावना के बीच एक व्युत्क्रम संबंध है।
तो एक उम्मीदवार के ग्रेजुएट प्रोग्राम में स्वीकार किए जाने की संभावना उन छात्रों के लिए अधिक है जिन्होंने टॉप-रैंक्ड अंडरग्रेजुएट कॉलेज (prestige_1 = True) में पढ़ाई की है, बजाय लोअर-रैंक्ड स्कूल (prestige_3 या prestige_4) के।