इस लेख में, हम दिए गए प्रॉब्लम स्टेटमेंट को हल करने के समाधान और दृष्टिकोण के बारे में सीखेंगे।
प्रॉब्लम स्टेटमेंट
एक स्ट्रिंग इनपुट दिए जाने पर, हमें दी गई स्ट्रिंग्स में अपरकेस और लोअरकेस कैरेक्टर्स की संख्या ढूंढने की आवश्यकता है।
यहां हम बिल्ट-इन ord() फंक्शन की मदद से प्रत्येक कैरेक्टर के ASCII वैल्यू की जांच करेंगे।
हमने दो काउंटर्स को 0 असाइन किया है और हम इनपुट स्ट्रिंग को ट्रैवर्स कर रहे हैं और उनके ASCII वैल्यूज़ की जांच कर रहे हैं और उनके काउंटर को क्रमशः बढ़ा रहे हैं।
आइए नीचे कार्यान्वयन देखें:
उदाहरण
def upperlower(string):
    upper = 0
    lower = 0
    for i in range(len(string)):
        # लोअरकेस के लिए
        if (ord(string[i]) >= 97 and ord(string[i]) <= 122):
            lower += 1
        # अपरकेस के लिए
        elif (ord(string[i]) >= 65 and ord(string[i]) <= 90):
            upper += 1
    print('Lower case characters = %s' % lower, 'Upper case characters = %s' % upper)

# ड्राइवर कोड
string = 'Tutorialspoint'
upperlower(string)
आउटपुट
Lower case characters = 13
Upper case characters = 1
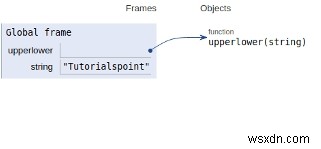
सभी वेरिएबल्स और फंक्शन्स ग्लोबल स्कोप में घोषित हैं जैसा कि नीचे दी गई आकृति में दिखाया गया है।
निष्कर्ष
इस लेख में, हमने इनबिल्ट फंक्शन्स का उपयोग किए बिना अपरकेस और लोअरकेस कैरेक्टर्स की गिनती करने के दृष्टिकोण के बारे में सीखा।