इस लेख में, हम नीचे दिए गए समस्या कथन के समाधान के बारे में जानेंगे।
समस्या कथन - हमें एक स्ट्रिंग दी गई है, हमें स्ट्रिंग में मौजूद अपरकेस और लोअरकेस वर्णों की संख्या गिनने की आवश्यकता है बिना बिल्ट-इन फ़ंक्शन का उपयोग किए।
इसे Python में उपलब्ध islower() और isupper() फ़ंक्शन का उपयोग करके आसानी से हल किया जा सकता है। लेकिन यहां बिल्ट-इन फ़ंक्शन का उपयोग न करने की बाधा है। इसलिए यहां हम वर्णों के ASCII मान की मदद लेते हैं।
ord() फ़ंक्शन का उपयोग करके हम स्ट्रिंग में मौजूद प्रत्येक वर्ण का ASCII मान निकालते हैं और फिर अपरकेस और लोअरकेस की जांच के लिए तुलना करते हैं जैसा कि नीचे दिखाया गया है।
उदाहरण
def upperlower(string):
    upper = 0
    lower = 0
    for i in range(len(string)):
        # लोअरकेस के लिए
        if (ord(string[i]) >= 97 and ord(string[i]) <= 122):
            lower += 1
        # अपरकेस के लिए
        elif (ord(string[i]) >= 65 and ord(string[i]) <= 90):
            upper += 1
    print('Lower case characters = ' + str(lower))
    print('Upper case characters = ' + str(upper))

# ड्राइवर कोड
string = 'TutorialsPoint'
upperlower(string)
आउटपुट
Lower case characters = 12
Upper case characters = 2
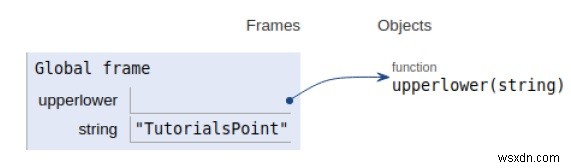
सभी चर स्थानीय स्कोप में घोषित किए गए हैं और उनके संदर्भ ऊपर दिए गए चित्र में देखे गए हैं।
निष्कर्ष
इस लेख में, हमने सीखा है कि दी गई स्ट्रिंग में मौजूद अपरकेस और लोअरकेस वर्णों को कैसे गिनें।