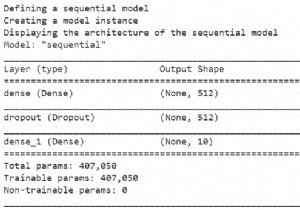
फूल डेटासेट को बफर प्रीफेच, शफ़ल विधि और कैश विधि की मदद से प्रदर्शन के लिए कॉन्फ़िगर किया जा सकता है। बफर्ड प्रीफेचिंग का उपयोग यह सुनिश्चित करने के लिए किया जा सकता है कि डेटा को डिस्क से बिना I/O ब्लॉकिंग बने लिया जा सके। Dataset.cache() छवियों को मेमोरी में रखता है जब वे पहले युग के दौरान डिस्क से लोड हो चुके होते हैं। Dataset.prefetch() प्रशिक्षण के दौरान डेटा प्रीप्रोसेसिंग और मॉडल निष्पादन को ओवरलैप करेगा।
और पढ़ें: TensorFlow क्या है और केरस TensorFlow के साथ न्यूरल नेटवर्क बनाने के लिए कैसे काम करता है?
केरस Sequential API का उपयोग किया जाता है, जो एक सादे स्टैक के साथ काम करने के लिए एक अनुक्रमिक मॉडल बनाने में मददगार है, जहां प्रत्येक परत में ठीक एक इनपुट टेंसर और एक आउटपुट टेंसर होता है।
हम नीचे दिए गए कोड को चलाने के लिए Google Colaboratory का उपयोग कर रहे हैं। Google Colab या Colaboratory ब्राउज़र पर पायथन कोड चलाने में मदद करता है और इसके लिए शून्य कॉन्फ़िगरेशन और GPU (ग्राफिकल प्रोसेसिंग यूनिट्स) तक मुफ्त पहुंच की आवश्यकता होती है। Colaboratory को Jupyter Notebook के शीर्ष पर बनाया गया है।
print("Configuring the dataset for better performance")
AUTOTUNE = tf.data.AUTOTUNE
train_ds = train_ds.cache().shuffle(1000).prefetch(buffer_size=AUTOTUNE)
val_ds = val_ds.cache().prefetch(buffer_size=AUTOTUNE)
कोड क्रेडिट: https://www.tensorflow.org/tutorials/images/classification
आउटपुट
Configuring the dataset for better performance
व्याख्या
- बफर्ड प्रीफेचिंग की अवधारणा का उपयोग किया जा सकता है ताकि डेटा को डिस्क से बिना I/O ब्लॉकिंग बने लिया जा सके।
- डेटा लोड करते समय दो महत्वपूर्ण विधियों का उपयोग किया जा सकता है:
- cache() छवियों को मेमोरी में रखता है जब वे पहले युग के दौरान डिस्क से लोड हो चुके होते हैं।
- यह सुनिश्चित करेगा कि मॉडल प्रशिक्षित होने पर डेटासेट बॉटलनेक न बने।
- यदि डेटासेट मेमोरी में फिट होने के लिए बहुत बड़ा है, तो इस विधि का उपयोग ऑन-डिस्क कैश बनाने के लिए किया जा सकता है।
- prefetch() प्रशिक्षण के दौरान डेटा प्रीप्रोसेसिंग और मॉडल निष्पादन को ओवरलैप करेगा।