पायथन अपने विशाल पैकेज लाइब्रेरी के लिए जाना जाता है। लाइब्रेरी की मदद से, हम देखेंगे कि PDF को CSV फ़ाइल में कैसे कन्वर्ट करें। CSV फ़ाइल कुछ भी नहीं है बल्कि डेटा का संग्रह है, जिसे रो और कॉलम के सेट के साथ फ्रेम किया गया है। पायथन लाइब्रेरी में PDF को CSV में कन्वर्ट करने के लिए विभिन्न पैकेज उपलब्ध हैं, लेकिन हम Tabula-py मॉड्यूल का उपयोग करेंगे। tabula-py का प्रमुख भाग जावा में लिखा गया है जो पहले PDF डॉक्यूमेंट पढ़ता है और पायथन DataFrame को JSON ऑब्जेक्ट में कन्वर्ट करता है।
Tabula-py के साथ काम करने के लिए, हमारे सिस्टम में जावा प्रीइंस्टॉल्ड होना चाहिए। PDF फ़ाइल को CSV में कन्वर्ट करने के लिए, हम इन चरणों का पालन करेंगे:
कमांड शेल में pip install tabula-py टाइप करके आवश्यक पैकेज इंस्टॉल करें।
अब, read_pdf("file location", pages=number) फंक्शन का उपयोग करके फ़ाइल पढ़ें। यह DataFrame लौटाएगा।
tabula.convert_into('pdf-filename', 'name_this_file.csv', output_format="csv", pages="all") का उपयोग करके DataFrame को एक्सेल फ़ाइल में कन्वर्ट करें। यह आमतौर पर PDF फ़ाइल को एक्सेल फ़ाइल में एक्सपोर्ट करता है।
उदाहरण
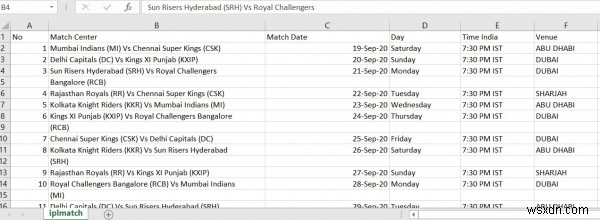
इस उदाहरण में, हमने IPL मैच शेड्यूल डॉक्यूमेंट का उपयोग इसे एक्सेल फ़ाइल में कन्वर्ट करने के लिए किया है।
# आवश्यक मॉड्यूल इम्पोर्ट करें
import tabula

# PDF फ़ाइल पढ़ें
df = tabula.read_pdf("IPLmatch.pdf", pages='all')[0]

# PDF को CSV में कन्वर्ट करें
tabula.convert_into("IPLmatch.pdf", "iplmatch.csv", output_format="csv", pages='all')
print(df)
आउटपुट
उपरोक्त कोड चलाने से PDF फ़ाइल एक्सेल (CSV) फ़ाइल में कन्वर्ट हो जाएगी।