वैश्विक विशेषज्ञों ने भविष्यवाणी की है कि IIoT बाजार सभी की अपेक्षाओं से आगे बढ़ेगा। रिपोर्ट के अनुसार, यह 2030 तक वैश्विक अर्थव्यवस्था में लगभग $14.2 ट्रिलियन जोड़ देगा (Accenture के शोध के अनुसार)। लेकिन तब से, यह बाधाओं का सामना कर रहा है क्योंकि पारंपरिक विधियां विसंगतियों का पता लगाने और भविष्यवाणी करने में सक्षम नहीं हैं। हाल ही में, संज्ञानात्मक विसंगति पहचान तस्वीर में आई है, लेकिन क्या यह उम्मीद के मुताबिक प्रदर्शन कर पाएगी? खैर, इसके बारे में जानने के लिए, आपको IIoT और संज्ञानात्मक विसंगति पहचान के बारे में जानना चाहिए। तो, आइए शुरू करें!
IIoT क्या है?
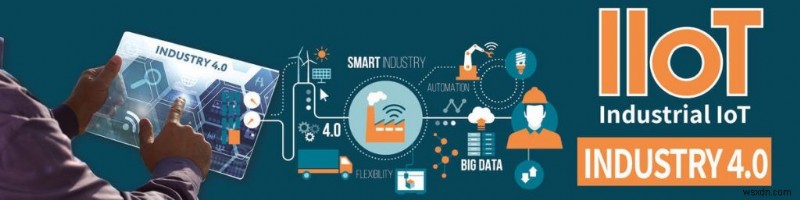
IIoT शब्द 2012 के अंत में GE द्वारा गढ़ा गया था। IIoT या इंडस्ट्रियल इंटरनेट ऑफ थिंग्स इंटरनेट ऑफ थिंग्स के रूप में जानी जाने वाली अवधारणा की बड़ी तस्वीर है। IIoT ML और बिग डेटा तकनीक की क्षमता को खेल में लाता है। इसके साथ, ऑटोमेशन तकनीकों को स्व-निहित प्रदर्शन के अगले स्तर पर अपग्रेड करना अब पहाड़ी कार्य नहीं रहेगा। दुनिया भर के सेंसर या इंटरनेट ऑफ थिंग्स द्वारा एकत्र किए जा रहे डेटा की मात्रा पर विचार करें, उचित एनालिटिक्स के बिना इनका उपयोग समाप्त हो जाएगा और हम अंततः उन्हें हटा देंगे। यह डेटा संग्रह की प्रक्रिया को बेकार छोड़ देगा। लेकिन IIoT के साथ, डेटा को अन्य प्रणालियों के साथ जोड़ा जा सकता है और बहुत आसान तरीके से संसाधित किया जा सकता है। लेकिन संज्ञानात्मक विसंगति क्या है?
संज्ञानात्मक विसंगति पहचान क्या है?
CA पहचान एक प्रक्रिया है जो अनसुपरवाइज्ड लर्निंग और पैटर्न रिकग्निशन की मदद से IIoT डेटा (बड़े हिस्से जो पहले बेकार थे) में विसंगतियों की पहचान करती है। इनके साथ, झूठे अलार्म की उपस्थिति को काफी हद तक कम किया जा सकता है। साथ ही, सही समय पर दोषों और विफलताओं का पता लगाने से हम समय और संसाधनों को महत्वपूर्ण रूप से बचा सकते हैं।
संज्ञानात्मक विसंगति पहचान का IIoT पर प्रभाव...
यदि आंकड़ों पर भरोसा किया जाए, तो A350 विमान पर लगभग 6k सेंसर हैं जो प्रति उड़ान 2.5 पेटाबाइट डेटा उत्पन्न करने में सक्षम हैं। कार निर्माता, बिजली संयंत्र, तेल रिग, असेंबली लाइन आदि जैसे क्षेत्र भी पीछे नहीं हैं। हजारों सेंसर लगातार संचालित होने के साथ, वे दैनिक आधार पर भारी मात्रा में डेटा उत्पन्न कर रहे हैं। हालांकि, IIoT कंपनियां उत्पादित डेटा के 20% से अधिक का उपयोग नहीं कर सकतीं। फिर भी, हम इन सभी एकत्र किए गए डेटा के उपयोग को खोजने का प्रयास कर रहे हैं क्योंकि हम उन पैटर्न की पहचान नहीं कर पा रहे हैं जो मायने रखते हैं। हमें उपकरणों के उपयोग दर को बढ़ाने और आवश्यक ईंधन को कम करने के लिए बड़े पैमाने पर विसंगति ढूंढने की आवश्यकता है।
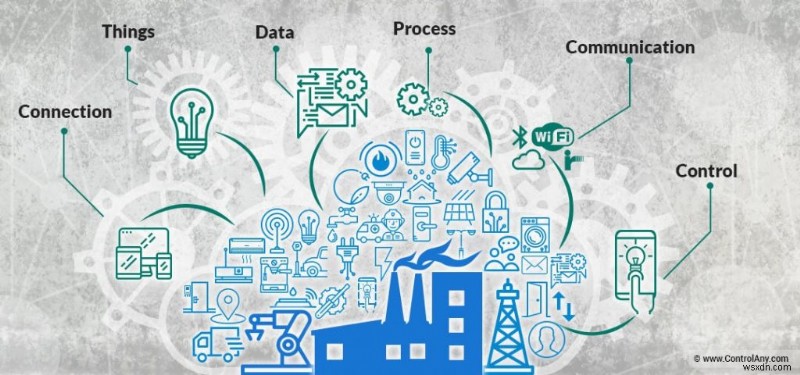
इसके अलावा, कई अन्य विसंगतियां हैं जैसे विलंबता समस्या जो सीधे वास्तविक समय डेटा को प्रभावित करती है, छोटे भागों के जीवनकाल की भविष्यवाणी करने में विफलता, जनशक्ति नियोजित करने में शामिल खर्च, और कई अन्य।
ऊपर उल्लेखित अनुसार, संज्ञानात्मक विसंगति मशीन लर्निंग और डेटा एनालिटिक्स द्वारा संचालित है जो IIoT को समाधान खोजने और उन समस्याओं को दूर करने में मदद करती है जिन्हें पारंपरिक विधियां भविष्यवाणी या हल करने में विफल रहती हैं। हालांकि, केवल विसंगतियों को ढूंढना पर्याप्त नहीं है। चूंकि कई प्रकार की विसंगतियां हैं, अच्छे और बुरे को अलग करना एक कठिन काम बन जाता है। तो, अगर हम भविष्यवाणी करने के लिए कनेक्ट और सहसंबंधित कर सकते हैं तो हम बड़ी मात्रा में समय और संपत्ति बचा सकते हैं।
इस पर, डेटा साइंटिस्ट ताज डारा ने बताया है कि जब ML को संज्ञानात्मक IoT फ्रेमवर्क के साथ बढ़ाया जाता है, तो यह IIoT व्यवसायों को सेंसर डेटा के प्रारंभिक ग्रहण से आउटपुट भविष्यवाणियों तक विसंगतियों का पता लगाने और यह निर्धारित करने में सक्षम बनाता है कि क्या कुछ केवल 2 दिनों में विसंगति है या नहीं। यह काफी प्रभावशाली है क्योंकि अब सभी सेंसर को समानांतर में मापा जा सकता है।
संज्ञानात्मक विसंगति पहचान चरणों में की जाती है और उन्हें दी गई सटीक क्रम में किया जाता है। कनेक्ट, डिटेक्ट, वैलिडेट, प्रेडिक्ट, और एक्ट। पहले, हम डेटा स्रोतों को संरचित करने के लिए कनेक्ट करते हैं और फिर हम पता लगाते हैं कि पाई गई संस्थाओं को विसंगति माना जा सकता है या नहीं। प्रक्रिया सत्यापन प्रक्रिया में जारी रहती है और फिर भविष्यवाणियां की जाती हैं। जैसे ही यह प्रक्रिया पूरी होती है, आप अपने सिस्टम के API से जुड़कर कार्य कर सकते हैं। इस दृष्टिकोण को अपनाकर आप लगभग 75% भागों के टूटने की भविष्यवाणी कर सकते हैं इससे पहले कि वे असामान्य व्यवहार करना शुरू करें।
इसलिए, हम कह सकते हैं कि इन दोनों को मिलाने से हमें अपनी प्रथाओं को अपग्रेड करने में मदद मिलेगी। हम इससे इनकार नहीं कर सकते कि भारी मात्रा में डेटा अनावश्यक रूप से जगह लेता है क्योंकि हमारे पास प्रभावी प्रथाओं की कमी है, पारंपरिक विधियों को नई विधियों से बदलना निश्चित रूप से हमारे उद्देश्य की पूर्ति करेगा। साथ ही, अगर हम दैनिक उत्पन्न होने वाले भारी डेटा पर नियंत्रण हासिल कर लेते हैं, तो हम संपत्ति विफलता प्रबंधन को बढ़ाने, अनियोजित डाउनटाइम को कम करने, विफलता भविष्यवाणी में सुधार, रखरखाव लागत को कम करने, संसाधन उपयोग को अनुकूलित करने, गुणवत्ता मुद्दों और वारंटी दावों को कम करने, और संपत्ति जीवन को बढ़ाने में सक्षम होंगे।
अपग्रेड करने का समय आ गया है! हम आशा करते हैं कि यह काम करेगा जैसा कि डेटा विशेषज्ञों ने वादा किया है ताकि हमारे पास एक बेहतर कल हो! इस पर आपके क्या विचार हैं, नीचे टिप्पणी अनुभाग में हमें बताएं!