SQL सर्वर 2017 आधिकारिक तौर पर अक्टूबर 2017 में जारी किया गया। SQL सर्वर 2017 के पहले भाग 2016 के अंत से जारी किए गए हैं, 2017 के अंत तक इसके 10 रिलीज़ हो चुके हैं।
SQL सर्वर 2017 संस्करण मुख्य रूप से लिनक्स से जुड़ा है, लिनक्स पर SQL की शक्ति लाता है। संक्षेप में, आप SQL सर्वर 2017 को लिनक्स पर इंस्टॉल कर सकते हैं, लिनक्स-आधारित डॉकर कंटेनर्स पर SQL सर्वर 2017 का उपयोग कर सकते हैं। SQL सर्वर 2017 आपको डेवलपमेंट भाषाएं चुनने, इसे ऑन-प्रिमाइसेस या क्लाउड-आधारित विकसित करने की अनुमति भी देता है।
इस संस्करण में, SQL सर्वर 2017 डेटाबेस इंजन, इंटीग्रेशन सर्विसेज, मास्टर डेटा सर्विसेज, एनालिसिस सर्विसेज आदि जैसे प्रत्येक भाग में प्रदर्शन, स्केलेबिलिटी और सुविधाओं में सुधार करता है। इस लेख में हम भाग दर भाग देखेंगे।
SQL सर्वर 2017 की नई सुविधा
- डेटाबेस इंजन में नई सुविधा
- identity_cache
- बेहतर अनुकूली क्वेरी प्रोसेसिंग
- स्वचालित ट्यूनिंग
- ग्राफ DB में नई सुविधा
- ग्राफ DB क्या है?
- हमेशा उपलब्ध (क्रॉस-डेटा एक्सेस)
- DTA पर सुधार
- नया स्ट्रिंग फंक्शन
- TRANSLATE
- CONCAT_WS
- TRIM
- STRING_AGG
- SQL 2017 के SSRS (रिपोर्टिंग सर्विसेज) में नया क्या है
- SQL 2017 में SSIS (इंटीग्रेटेड सर्विसेज) में नया क्या है
- SQL 2017 में एनालिसिस सर्विसेज (SSAS) में नया क्या है?
- मशीन लर्निंग
- लिनक्स समर्थन
डेटाबेस इंजन में नई सुविधा
identity_cache
यह विकल्प आपको ID कॉलम के मान में विचलन से बचने में मदद करता है, यदि सर्वर अचानक बंद हो जाता है या फेलओवर करता है, या यहां तक कि सेकेंडरी सर्वर पर स्विच करता है। इसका उपयोग ALTER DATABASE SCOPED CONFIGURATION कमांड के साथ किया जाता है, डेटाबेस कॉन्फ़िगरेशन सेटिंग्स को सक्षम करने के लिए। सिंटैक्स निम्नानुसार है:
ALTER DATABASE SCOPED CONFIGURATION { { [ FOR SECONDARY] SET } } | CLEAR PROCEDURE_CACHE | SET < set_options > [;] < set_options > ::= { MAXDOP = { | PRIMARY } | LEGACY_CARDINALITY_ESTIMATION = { ON | OFF | PRIMARY } | PARAMETER_SNIFFING = { ON | OFF | PRIMARY } | QUERY_OPTIMIZER_HOTFIXES = { ON | OFF | PRIMARY } | IDENTITY_CACHE = { ON | OFF } }
बेहतर अनुकूली क्वेरी प्रोसेसिंग
यदि आप क्वेरी प्रदर्शन में सुधार करना चाहते हैं, तो यह नई सुविधा महत्वपूर्ण रूप से मदद करेगी। यह SQL सर्वर और Azure SQL डेटाबेस में समर्थित है।
SQL क्वेरीज़ निष्पादित करते समय यह सामान्य ऑप्टिमाइज़ेशन प्रक्रिया है:
- सबसे पहले, क्वेरी ऑप्टिमाइज़र अभी बनाई गई क्वेरी के लिए सभी संभावित क्वेरी निष्पादन योजनाओं की गणना करेगा।
- अगला, यह सर्वोत्तम / सबसे तेज़ योजना दिखाएगा।
- अंत में, अनुमानित सर्वोत्तम योजना को क्वेरी निष्पादित करने के लिए चुना जाएगा और निष्पादन प्रक्रिया तब शुरू होगी।
उपरोक्त प्रक्रिया में निम्न नुकसान हैं:
- यदि गलत योजना का अनुमान सर्वोत्तम के रूप में लगाया जाता है, तो यह प्रदर्शन को प्रभावित करेगा।
- यदि इष्टतम योजना के निष्पादन के लिए अपर्याप्त मेमोरी आवंटित की जाती है, तो मेमोरी ओवरफ्लो एरर होगा।
यहां वे सुविधाएं हैं जो SQL सर्वर 2017 में इन नुकसानों को दूर करने के लिए शामिल की गई हैं:
Batch Mode Memory Grant Feedback (बैच मोड के लिए मेमोरी आवंटन पर फीडबैक): यह फीडबैक योजना को निष्पादित करने के लिए आवश्यक मेमोरी की पुनर्गणना करेगा और कैश से इसके लिए मेमोरी आवंटित करेगा।
Batch Mode Adaptive Joins (बैच मोड के अनुकूल जॉइन): जॉइन के 2 प्रकार हैं: Hash और नेस्टेड लूप। जब निष्पादन योजना एंट्री दर्ज की जाती है और पहली बार स्कैन की जाती है, तो यह निर्धारित करता है कि इष्टतम गति पर आउटपुट प्राप्त करने के लिए किस जॉइन प्रकार को लागू करना है।
Interleaved Execution: इष्टतम योजना के निष्पादन के दौरान, यह सुविधा मल्टी-स्टेटमेंट टेबल वैल्यूड फंक्शन्स का सामना करने पर "रोक" देगी ताकि केवल इस टेबल में सही तत्वों की गणना की जा सके, और फिर ऑप्टिमाइज़ करना जारी रखें।
स्वचालित ट्यूनिंग
यह सुविधा क्वेरी प्रदर्शन में समस्याओं की जांच करती है, उन्हें पहचानती है और प्रस्तावित समाधानों के साथ ठीक करती है। ये इस सुविधा में उपलब्ध स्वचालित ट्यूनिंग तकनीकें हैं:
स्वचालित सुधार (योजना): यह तकनीक SQL 2017 डेटाबेस में उपलब्ध है, यह दिए गए क्वेरी प्लान में प्रदर्शन समस्याओं को ढूंढेगी, फिर प्रस्तावित समाधानों के साथ उन्हें ठीक करेगी।
स्वचालित प्रबंधन (इंडेक्स): यह तकनीक SQL 2017 Azure DB में शामिल है, यह गैर-मानक इंडेक्स को हटाकर और सही इंडेक्स जोड़कर इंडेक्स के क्रम की पहचान और सुधार करेगी।
ग्राफ DB में नई सुविधा
ग्राफ DB क्या है?
मूल रूप से, ग्राफ DB नोड्स और एज का एक सेट है, एज नोड्स के बीच संबंध का प्रतिनिधित्व करता है, नोड्स एंटिटीज़ हैं, एक एज कई नोड्स से जुड़ा हो सकता है। ग्राफ DB रिलेशनल डेटाबेस की तरह काम करता है, और आप इसका उपयोग निम्न मामलों में कर सकते हैं:
- जब एक हायरार्किकल फॉर्मेट में डेटाबेस हो और एक नोड के लिए कई पैरेंट्स को सेव करना चाहते हों।
- जब आपको लिंक और डेटा संबंधों की जांच और विश्लेषण करने की आवश्यकता हो।
- जब कई संबंध (रिलेशनशिप) हों।
यहां, ग्राफ टेबल को क्वेरी करने और डेटा सॉर्ट करने के लिए MATCH कीवर्ड का उपयोग किया जाता है, एक सिंगल क्वेरी की मदद से, उपयोगकर्ता ग्राफ और रिलेशनल डेटा पर क्वेरी कर सकता है।
हमेशा उपलब्ध (क्रॉस-डेटा एक्सेस)
इस सुविधा की मदद से, अब अलग-अलग SQL इंस्टेंस के बीच डेटाबेस का क्रॉस-एक्सचेंज करना संभव है (एक SQL इंस्टेंस जो अन्य इंस्टेंस इंस्टेंस से कनेक्ट हो सकता है)। यह डिस्ट्रिब्यूटेड डेटाबेस के एक्सचेंज का भी समर्थन करता है। [SQL 2016 भी क्रॉस-डेटाबेस एक्सेस का समर्थन करता है लेकिन केवल एक ही SQL सर्वर के भीतर इंस्टेंस के बीच।]
DTA पर सुधार
SQL 2017 में, डेटाबेस ट्यूनिंग एडवाइजर (DTA) में प्रदर्शन में सुधार हुआ। विशेष रूप से, DTA के लिए विकल्प जोड़े गए हैं।
यदि आप नहीं जानते कि DTA क्या है, तो:
DTA एक डेटाबेस टूल है जो क्वेरी प्रोसेसिंग (प्रोसेस्ड) करता है और फिर आपको प्रदर्शन सुधारने के तरीके प्रदान करता है, संभवतः डेटाबेस संरचना को बदलकर (जैसे इंडेक्स, लॉक)। DTA का उपयोग निम्न दो तरीकों से किया जा सकता है:
- GUI (इंटरफेस) का उपयोग करके
- कमांड यूटिलिटी का उपयोग करके
नया स्ट्रिंग फंक्शन
SQL 2017 उपयोगकर्ताओं को TRANSLATE, CONCAT_WS, STRING_AGG, TRIM जैसे कुछ नए स्ट्रिंग फंक्शन्स देता है। आइए प्रत्येक फंक्शन को एक-एक करके एक्सप्लोर करें।
TRANSLATE
मूल रूप से यह फंक्शन एक कैरेक्टर स्ट्रिंग को इनपुट डेटा के रूप में लेता है और फिर इन कैरेक्टर्स को कुछ नए कैरेक्टर्स में परिवर्तित करता है, नीचे सिंटैक्स देखें:
TRANSLATE (inputString, characters, translations)
उपरोक्त सिंटैक्स में 'characters' की लंबाई 'translations' के समान होनी चाहिए, अन्यथा फंक्शन एरर मान लौटाएगा। उदाहरण के लिए:
TRANSLATE ( '6 * {10 + 10} / [6-4]' , '[] {}' , '() ()' )
उपरोक्त उदाहरण द्वारा लौटाया गया परिणाम 6 * (10 + 10) / (6-4). होगा। हम देख सकते हैं कि कर्ली ब्रेसेस और ब्रैकेट्स राउंड ब्रैकेट्स में परिवर्तित हो गए हैं।
इस फंक्शन का मैकेनिज्म REPLACE फंक्शन के समान है, लेकिन सरल उपयोग REPLACE फंक्शन को बदलने के लिए है। उदाहरण के लिए, यदि हम उपरोक्त परिणाम को वापस करना चाहते हैं लेकिन REPLACE फंक्शन का उपयोग करते हैं, तो हमें निम्न फंक्शन लिखना होगा, जिसे पहली नज़र में देखना आसान नहीं होगा:
SELECT REPLACE (REPLACE (REPLACE (REPLACE ( '6 * {10 + 10} / [6-4]' , '{' , '(' ), '}' , ')' ), '[' , '(' ), ']' , ')' );
CONCAT_WS
इस फंक्शन का कार्य बस सभी इनपुट आर्गुमेंट्स को निर्दिष्ट डिलीमीटर के साथ जोड़ना है। कृपया नीचे सिंटैक्स देखें:
CONCAT_WS (separator, argument1, argument1 [, argumentN] .)
यह फंक्शन सेपरेटर्स की मदद से सभी आर्गुमेंट्स को जोड़कर सिंगल स्ट्रिंग्स बनाता है, इसलिए इसे आउटपुट उत्पन्न करने के लिए कम से कम 2 आर्गुमेंट्स की आवश्यकता होती है, अन्यथा परिणाम एरर लौटाएगा। उदाहरण के लिए:
SELECT CONCAT_WS (',','Count numers','one','two','three','four') AS counter;
उपरोक्त कमांड द्वारा लौटाया गया परिणाम होगा:one, two, three, four
आप एन्क्रिप्टेड स्ट्रिंग्स के बजाय डेटाबेस कॉलम नामों का भी उपयोग कर सकते हैं।
TRIM
आखिरकार, यह फंक्शन SQL 2017 में भी दिखाई दिया। यह मूल रूप से C# के ट्रिम फंक्शन की तरह काम करता है, यानी स्ट्रिंग की शुरुआत और अंत में सभी अतिरिक्त स्पेस को हटाता है। सिंटैक्स निम्नानुसार है:
SELECT TRIM ( 'trim me' ) AS result;
उपरोक्त कमांड द्वारा लौटाया गया परिणाम होगा:trim me
यह फंक्शन स्ट्रिंग के बीच में स्पेस को नहीं हटाएगा।
STRING_AGG
यह फंक्शन सेपरेटर्स की मदद से स्ट्रिंग के मानों को जोड़ता है जबकि स्ट्रिंग के अंत में सेपरेटर्स नहीं जोड़ता। इनपुट डेटा VARCHAR, NVARCHAR हो सकता है, आप WITHIN GROUP क्लॉज का उपयोग करके परिणामों के डिस्प्ले ऑर्डर को वैकल्पिक रूप से निर्दिष्ट कर सकते हैं।
नीचे सिंटैक्स देखें:
 STRING_AGG (expression, separator) []

 :: =
 WITHIN GROUP ( ORDER BY [ ASC | DESC ])
कृपया निम्न उदाहरण देखें:
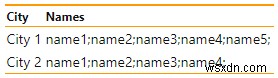
 SELECT city,
 STRING_AGG (name, ';' ) WITHIN GROUP ( ORDER BY name ASC ) AS names
 FROM Students GROUP BY city;
उपरोक्त उदाहरण में, सभी नामों को जोड़ा गया है और सेमीकोलन (;) से अलग किया गया है। WITHIN GROUP क्लॉज हमें क्रम में सॉर्ट करने में मदद करता है। लौटाया गया परिणाम निम्नानुसार प्रदर्शित होगा:
SQL 2017 के SSRS (रिपोर्टिंग सर्विसेज) में नया क्या है
- अब से, SSRS सेटअप SQL सर्वर सेटिंग्स पर उपलब्ध नहीं है, आपको इसे डाउनलोड स्टोर [यहां] से डाउनलोड करना होगा।
- अब से, क्वेरी डिज़ाइनर DAX का समर्थन करेगा। नेटिव DAX क्वेरीज़ SSAS (एनालिसिस सर्विसेज) को रोकने के लिए बनाई जा सकती हैं। यह सुविधा SQL टूल्स और रिपोर्ट बिल्डर्स के नवीनतम अपडेट पर दिखाई देगी।
- OpenAPI कमांड्स RESTful API द्वारा समर्थित हैं, और अब RESTful API SSRS द्वारा समर्थित है।
- अब से, आप अपनी टिप्पणियों में अधिक फ़ाइलें अटैच कर सकते हैं।
- आप रिपोर्ट्स में टिप्पणियां भी जोड़ सकते हैं।
- रिपोर्टिंग सर्विस पोर्टल को काफी अपग्रेड किया गया है (यह सुविधा SQL 2016 में उपलब्ध है)।
SQL 2017 में SSIS (इंटीग्रेटेड सर्विसेज) में नया क्या है
अब से आप Linux पर SSIS कर सकते हैं, वॉल्यूम बढ़ा सकते हैं, और Linux पर सीधे डेटा निकाल और परिवर्तित कर सकते हैं।
स्केलिंग सुविधा कई हाई-परफॉरमेंस मशीनों के साथ जटिल इंटीग्रेटेड सिस्टम्स की अनुमति देती है। स्केलिंग सुविधा Scale Out Master और Scale Out Workers की मदद से सभी ऑपरेशन्स कर सकती है।
SQL 2017 में एनालिसिस सर्विसेज (SSAS) में नया क्या है?
- Get Data का नया इंटरफेस SQL 2017 पर जारी किया गया है जो MS Excel, Power BI के समान है। इसके अलावा डेटा ट्रांसफॉर्मेशन और डेटा मैशअप फीचर्स भी दिखाई दिए हैं, आप क्वेरी जेनरेटर और M एक्सप्रेशन का उपयोग करके ऐसा कर सकते हैं।
- SSAS के लिए टेबुलर मोड - SQL 2012 में पेश किया गया एक साम्राज्य, अब SQL 2017 में काफी अपग्रेड किया गया है।
- SQL 2017 नए एन्कोडिंग हिंट्स प्रदान करता है, जिनका उपयोग बड़े मेमोरी में टेबल डेटा को ऑप्टिमाइज़ करने के लिए किया जाता है।
- PIVOT के लिए प्रदर्शन में सुधार।
मशीन लर्निंग
हम सभी जानते हैं कि SQL 2016 वर्तमान में R सर्विसेज का समर्थन करता है, और अब से, इस सर्विस का नाम बदलकर SQL सर्वर मशीन लर्निंग सर्विसेज कर दिया जाएगा। इस परिवर्तन का लाभ यह है कि आप SQL सर्वर पर R या Python कमांड्स के सिस्टम का आसानी से उपयोग कर सकते हैं।
इस नई सुविधा के साथ, Python स्टोर्ड प्रोसीजर्स में चल सकता है। आप SQL सर्वर के माध्यम से कमांड्स को दूरस्थ रूप से भी निष्पादित कर सकते हैं, जो Python डेवलपर्स के लिए वास्तव में उपयोगी है। हालांकि, यह सुविधा वर्तमान में Linux पर समर्थित नहीं है, कृपया अगले अपग्रेड की प्रतीक्षा करें।
मशीन लर्निंग को अधिक कुशल और इष्टतम तरीके से उपयोग करने के लिए, SQL निम्न समाधानों का उपयोग करता है:
- revoscalepy एक नए प्रकार की लाइब्रेरी है जो हाई-परफॉरमेंस एल्गोरिदम, गणना और दूरस्थ स्थितियों के लिए आधार के रूप में कार्य करती है। मूल रूप से revoscalepy है RevoScaleR प्लेटफॉर्म (एक R सर्विस पैक) पर आधारित।
- microsoftml एक Microsoft R सर्वर क्लस्टर है जो मशीन लैंग्वेज एल्गोरिदम का समर्थन करता है, Microsoft ने इस लाइब्रेरी को आंतरिक रूप से मशीन लर्निंग के लिए विकसित किया है। लेकिन वर्षों में, इसमें सुधार हुआ है और अब microsoftml फास्ट डेटा ट्रांसफर के साथ-साथ बड़े डॉक्यूमेंट्स के रूपांतरण आदि का समर्थन करता है।
लिनक्स समर्थन
मूल रूप से, नाम "SQL 2017 on Linux and Windows" से ही हम जान सकते हैं कि इस अपग्रेड का मुख्य उद्देश्य लिनक्स प्लेटफॉर्म पर उत्पाद की रिलीज़ का समर्थन करना है। "SQL on Linux" की कुछ प्रमुख विशेषताएं यहां दी गई हैं:
- कोर डेटाबेस स्टोर करने की क्षमता
- IPV6 समर्थन
- NFS समर्थन
- Linux पर AD सत्यापित करें
- एन्क्रिप्शन समर्थन
- Linux पर SSIS इंस्टॉल कर सकते हैं
- MSSQL-conf कमांड टूल उपलब्ध है
- इंस्टॉलेशन प्रक्रिया को सहज और उदार बनाएं
- Visual studio core के लिए SQL (VS core Linux पर उपलब्ध है)
- क्रॉस प्लेटफॉर्म स्क्रिप्ट जेनरेटर
सारांश
SQL सर्वर के बारे में कहने और सीखने के लिए बहुत कुछ होगा, हम अगले खंडों में इस यात्रा को जारी रखेंगे। टिप्पणियों और प्रश्नों के लिए संकोच न करें!
और देखें:
- Windows पर Linux सॉफ्टवेयर चलाने के 7 तरीके
- Windows और Linux के बीच 8 मुख्य अंतर
- MS SQL सर्वर पर डेटाबेस में लॉग इन करने के तरीके
- MS SQL सर्वर में सर्विसेज शुरू और बंद कैसे करें