शेयर्ड मेमोरी वह मेमोरी ब्लॉक है जिसे एक से अधिक प्रोग्राम द्वारा एक्सेस किया जा सकता है। शेयर्ड मेमोरी अवधारणा का उपयोग संचार का एक तरीका प्रदान करने और कम रिडंडेंट मेमोरी मैनेजमेंट प्रदान करने के लिए किया जाता है।
डिस्ट्रिब्यूटेड शेयर्ड मेमोरी जिसे DSM के रूप में संक्षिप्त किया जाता है, डिस्ट्रिब्यूटेड सिस्टम में शेयर्ड मेमोरी अवधारणा का कार्यान्वयन है। DSM सिस्टम ढीले ढंग से युग्मित सिस्टम में शेयर्ड मेमोरी मॉडल को लागू करता है जो सिस्टम में एक स्थानीय भौतिक शेयर्ड मेमोरी से वंचित हैं। इस प्रकार के सिस्टम में डिस्ट्रिब्यूटेड शेयर्ड मेमोरी एक वर्चुअल मेमोरी स्पेस प्रदान करता है जो डिस्ट्रिब्यूटेड पदानुक्रम के सभी सिस्टम (जिन्हें नोड्स भी कहा जाता है) द्वारा एक्सेस योग्य होता है।
DSM के कार्यान्वयन के दौरान ध्यान में रखी जाने वाली कुछ सामान्य चुनौतियाँ:
शेयर्ड मेमोरी में दूरस्थ रूप से संग्रहीत डेटा के मेमोरी एड्रेस (स्थान) को ट्रैक करना।
दूरस्थ डेटा के संदर्भों से जुड़े कम्युनिकेशन डिले और हाई ओवरहेड को कम करना।
DSM में शेयर्ड डेटा के समवर्ती एक्सेस को नियंत्रित करना।
इन चुनौतियों के आधार पर डिस्ट्रिब्यूटेड शेयर्ड मेमोरी को लागू करने के लिए एल्गोरिदम डिज़ाइन किए गए हैं। चार एल्गोरिदम हैं:
- सेंट्रल सर्वर एल्गोरिदम
- माइग्रेशन एल्गोरिदम
- रीड रेप्लिकेशन एल्गोरिदम
- फुल रेप्लिकेशन एल्गोरिदम
सेंट्रल सर्वर एल्गोरिदम
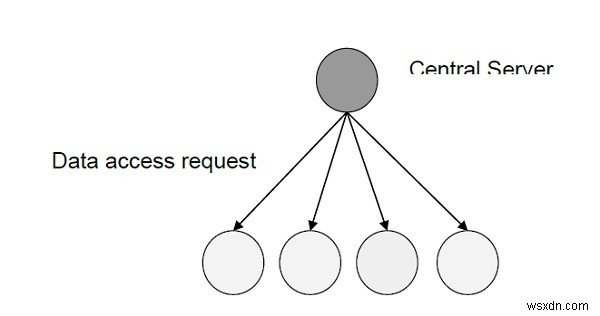
सभी शेयर्ड डेटा को सेंट्रल सर्वर द्वारा मेंटेन किया जाता है। डिस्ट्रिब्यूटेड सिस्टम के अन्य नोड्स डेटा पढ़ने और लिखने के लिए सर्वर से अनुरोध करते हैं जो अनुरोध को पूरा करता है और डेटा को अपडेट या एक्सेस प्रदान करता है साथ ही एकनॉलेजमेंट मैसेजेस के साथ।
ये एकनॉलेजमेंट मैसेजेस डेटा अनुरोध की स्थिति प्रदान करने के लिए उपयोग किए जाते हैं जिसे सर्वर द्वारा पूरा किया जाता है। जब डेटा कॉलिंग फ़ंक्शन को भेजा जाता है, तो यह एक नंबर को एकनॉलेज करता है जो डेटा के एक्सेस सीक्वेंस को दिखाता है ताकि समवर्तीता बनी रहे। और विफलता के मामले में टाइम-आउट वापस किया जाता है।
बड़े डिस्ट्रिब्यूटेड सिस्टम के लिए, एक से अधिक सर्वर हो सकते हैं। इस मामले में, सर्वर उनके एड्रेस या मैपिंग फ़ंक्शन का उपयोग करके स्थित होते हैं।
माइग्रेशन एल्गोरिदम
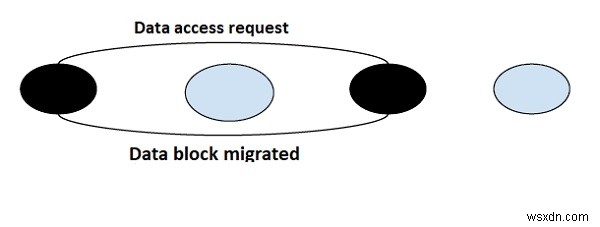
जैसा कि नाम से पता चलता है, माइग्रेशन एल्गोरिदम डेटा एलिमेंट्स के माइग्रेशन का कार्य करता है। प्रत्येक अनुरोध की सेवा करने वाले सेंट्रल सर्वर का उपयोग करने के बजाय, एक सिस्टम द्वारा अनुरोधित डेटा वाले ब्लॉक को आगे की एक्सेस और प्रोसेसिंग के लिए उसमें माइग्रेट किया जाता है। यह अनुरोध पर डेटा माइग्रेट करता है।
यह एल्गोरिदम हालांकि अच्छा है यदि जब एक सिस्टम एक ही ब्लॉक के डेटा को कई बार एक्सेस करता है और वर्चुअल मेमोरी अवधारणा को एकीकृत करने की क्षमता होती है, तो कुछ कमियां हैं जिन्हें संबोधित करने की आवश्यकता है।
एक समय में केवल एक नोड शेयर्ड डेटा एलिमेंट को एक्सेस करने में सक्षम होता है और पूरा ब्लॉक उस नोड पर माइग्रेट हो जाता है। इसके अलावा, नोड द्वारा अनुरोध पर डेटा आइटम्स के माइग्रेशन के कारण यह एल्गोरिदम थ्रैशिंग के प्रति अधिक संवेदनशील है।
रीड रेप्लिकेशन एल्गोरिदम
रीड रेप्लिकेशन एल्गोरिदम में, एक्सेस किए जाने वाले डेटा ब्लॉक को रेप्लिकेट किया जाता है और सभी कॉपियों में केवल पढ़ने की अनुमति होती है। यदि एक राइट ऑपरेशन किया जाना है, तो सभी रीड एक्सेस को तब तक रोक दिया जाता है जब तक सभी कॉपियां अपडेट नहीं हो जातीं।
समग्र सिस्टम प्रदर्शन में सुधार होता है क्योंकि समवर्ती एक्सेस की अनुमति होती है। लेकिन राइट ऑपरेशन महंगा होता है क्योंकि समवर्तीता बनाए रखने के लिए शेयर्ड सभी ब्लॉक्स को अपडेट करने की आवश्यकता होती है। डेटा एलिमेंट की सभी कॉपियों को स्थिरता बनाए रखने के लिए ट्रैक किया जाना चाहिए।
फुल रेप्लिकेशन एल्गोरिदम
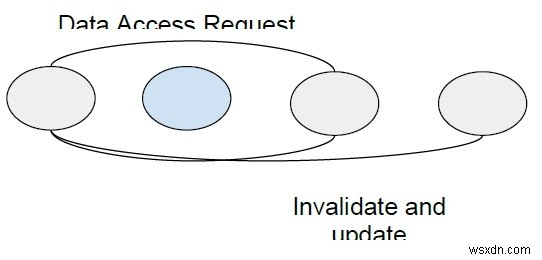
रीड रेप्लिकेशन एल्गोरिदम का एक विस्तार जो नोड्स को शेयर्ड ब्लॉक पर समवर्ती रूप से रीड और राइट दोनों ऑपरेशन करने की अनुमति देता है। लेकिन नोड्स की यह एक्सेस इसकी स्थिरता बनाए रखने के लिए नियंत्रित होती है।
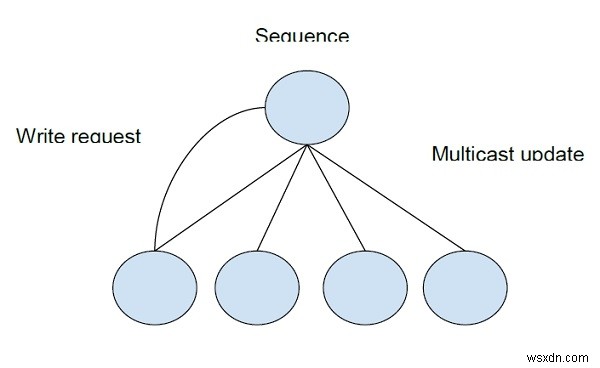
सभी नोड्स के समवर्ती एक्सेस पर डेटा की स्थिरता बनाए रखने के लिए सीक्वेंस बनाए रखा जाता है और डेटा में किए गए हर संशोधन के बाद एक मल्टीकास्ट संशोधनों के साथ सभी डेटा कॉपियों पर परिलक्षित होता है।