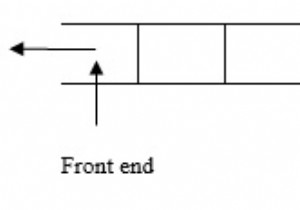
एक क्यू एक अमूर्त डेटा संरचना है जिसमें तत्वों का संग्रह होता है। क्यू FIFO तंत्र को लागू करता है यानी वह तत्व जो पहले डाला गया है वह पहले हटाया भी जाता है।
क्यू एक रैखिक डेटा संरचना हो सकती है। लेकिन यदि हम सरणी का उपयोग करके क्यू को लागू करते हैं तो यह कुछ समस्याएं पैदा कर सकती है। कभी-कभी लगातार सम्मिलन और विलोपन संक्रियाओं का उपयोग करके, फ्रंट और रियर की स्थिति बदल जाएगी। उस क्षण, ऐसा लगेगा कि क्यू में तत्व डालने के लिए कोई जगह नहीं है। भले ही कुछ खाली स्थान हों, कुछ तार्किक समस्याओं के कारण उनका उपयोग नहीं किया जाएगा। इस समस्या को दूर करने के लिए, हम सर्कुलर क्यू डेटा संरचना का उपयोग करेंगे।
एक सर्कुलर क्यू एक प्रकार की क्यू है जिसमें अंतिम स्थिति पहली स्थिति से जुड़ी होती है ताकि एक वृत्त बनाया जा सके।
उदाहरण
#include <iostream>
using namespace std;

int cqueue[5];
int front = -1, rear = -1, n = 5;

void insertCQ(int val) {
    if ((front == 0 && rear == n - 1) || (front == rear + 1)) {
        cout << "क्यू ओवरफ्लो \n";
        return;
    }
    if (front == -1) {
        front = 0;
        rear = 0;
    } else {
        if (rear == n - 1)
            rear = 0;
        else
            rear = rear + 1;
    }
    cqueue[rear] = val;
}

void deleteCQ() {
    if (front == -1) {
        cout << "क्यू अंडरफ्लो\n";
        return;
    }
    cout << "क्यू से हटाया गया तत्व है: " << cqueue[front] << endl;
    if (front == rear) {
        front = -1;
        rear = -1;
    } else {
        if (front == n - 1)
            front = 0;
        else
            front = front + 1;
    }
}

void displayCQ() {
    int f = front, r = rear;
    if (front == -1) {
        cout << "क्यू खाली है" << endl;
        return;
    }
    cout << "क्यू तत्व हैं:\n";
    if (f <= r) {
        while (f <= r) {
            cout << cqueue[f] << " ";
            f++;
        }
    } else {
        while (f <= n - 1) {
            cout << cqueue[f] << " ";
            f++;
        }
        f = 0;
        while (f <= r) {
            cout << cqueue[f] << " ";
            f++;
        }
    }
    cout << endl;
}

int main() {
    int ch, val;
    cout << "1) सम्मिलित करें\n";
    cout << "2) हटाएं\n";
    cout << "3) प्रदर्शित करें\n";
    cout << "4) बाहर निकलें\n";
    do {
        cout << "विकल्प दर्ज करें: " << endl;
        cin >> ch;
        switch (ch) {
            case 1:
                cout << "सम्मिलन के लिए इनपुट: " << endl;
                cin >> val;
                insertCQ(val);
                break;
            case 2:
                deleteCQ();
                break;
            case 3:
                displayCQ();
                break;
            case 4:
                cout << "बाहर निकलें\n";
                break;
            default:
                cout << "गलत!\n";
        }
    } while (ch != 4);
    return 0;
}
आउटपुट
1) सम्मिलित करें
2) हटाएं
3) प्रदर्शित करें
4) बाहर निकलें
विकल्प दर्ज करें:
1
सम्मिलन के लिए इनपुट:
10
विकल्प दर्ज करें:
1
सम्मिलन के लिए इनपुट:
20
विकल्प दर्ज करें:
1
सम्मिलन के लिए इनपुट:
30
विकल्प दर्ज करें:
1
सम्मिलन के लिए इनपुट:
40
विकल्प दर्ज करें:
1
सम्मिलन के लिए इनपुट:
50
विकल्प दर्ज करें:
3
क्यू तत्व हैं:
10 20 30 40 50
विकल्प दर्ज करें:
2
क्यू से हटाया गया तत्व है: 10
विकल्प दर्ज करें:
2
क्यू से हटाया गया तत्व है: 20
विकल्प दर्ज करें:
3
क्यू तत्व हैं:
30 40 50
विकल्प दर्ज करें:
4
बाहर निकलें