इस लेख में, मैं एक सामान्य वेब उपयोग केस के लिए तीन सर्वरलेस डेटाबेस DynamoDB, FaunaDB, Upstash (Redis) की लेटेंसी की तुलना करूंगा।
मैंने एक नमूना समाचार वेबसाइट बनाई और मैं वेबसाइट पर प्रत्येक अनुरोध के साथ डेटाबेस से संबंधित लेटेंसी रिकॉर्ड कर रहा हूँ। वेबसाइट देखें और सोर्स कोड देखें।
मैंने प्रत्येक डेटाबेस में 7,001 NY Times लेख डाले हैं। लेख न्यूयॉर्क टाइम्स आर्काइव API (जनवरी 2021 के सभी लेख) से एकत्र किए गए हैं। मैंने प्रत्येक लेख को यादृच्छिक रूप से स्कोर किया। प्रत्येक पेज अनुरोध पर, मैं प्रत्येक डेटाबेस से World सेक्शन के तहत शीर्ष 10 लेखों के लिए क्वेरी करता हूँ।
मैं प्रत्येक डेटाबेस से लेख लोड करने के लिए सर्वरलेस फ़ंक्शंस (AWS Lambda) का उपयोग करता हूँ। 10 लेख प्राप्त करने का प्रतिक्रिया समय लेटेंसी के रूप में लैम्ब्डा फ़ंक्शन के अंदर रिकॉर्ड किया जा रहा है। ध्यान दें कि रिकॉर्ड की गई लेटेंसी केवल लैम्ब्डा फ़ंक्शन और डेटाबेस के बीच है। यह आपके ब्राउज़र और सर्वर के बीच की लेटेंसी नहीं है।
प्रत्येक रीड अनुरोध के बाद, मैं डायनामिक डेटा का अनुकरण करने के लिए स्कोर को यादृच्छिक रूप से अपडेट करता हूँ। लेकिन मैं इस भाग को लेटेंसी गणना से बाहर रखता हूँ।
पहले हम एप्लिकेशन की जांच करेंगे, फिर परिणाम देखेंगे:
AWS Lambda सेटअप
- क्षेत्र: US-West-1
- मेमोरी: 1024Mb
- रनटाइम: nodejs14.x
DynamoDB सेटअप
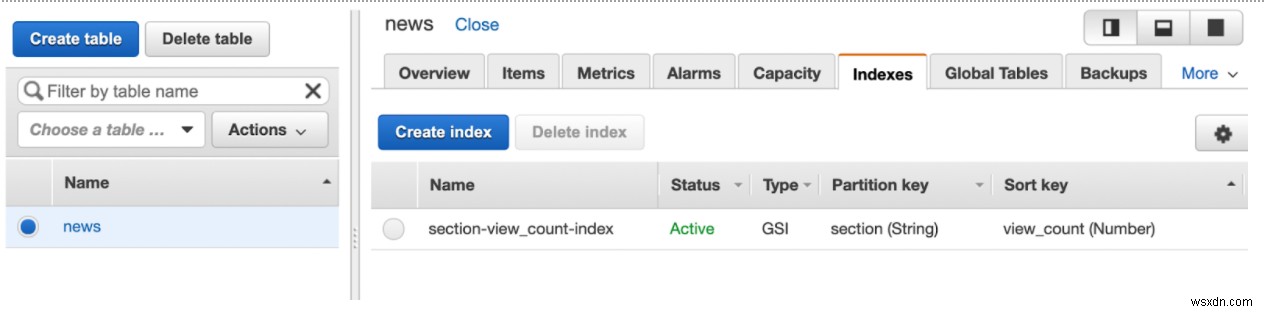
मैंने US-West-1 में 50 पढ़ने और लिखने की क्षमता के साथ एक DynamoDB टेबल बनाई (डिफ़ॉल्ट मान 5 था)।
मेरा इंडेक्स पार्टीशन कुंजी section (String) और सॉर्ट कुंजी view_count (Number) के साथ GSI है।
FaunaDB सेटअप
FaunaDB एक विश्व स्तर पर दोहराया गया डेटाबेस है, जहां तक मुझे पता है, क्षेत्र चुनने का कोई तरीका नहीं है। मैंने FQL का उपयोग किया, यह मानते हुए कि GraphQL API में कुछ ओवरहेड हो सकता है।
मैंने नीचे दिए अनुसार terms section और values ref के साथ एक इंडेक्स बनाया। मैंने इसे नॉन-सीरियलाइज़्ड बनाया ताकि प्रदर्शन में सुधार हो सके।
CreateIndex({
  name: "section_by_view_count",
  unique: false,
  serialized: false,
  source: Collection("news"),
  terms: [{ field: ["data", "section"] }],
  values: [
    { field: ["data", "view_count"], reverse: true },
    { field: ["ref"] }
  ]
})
Redis सेटअप
मैंने Upstash में US-West-1 क्षेत्र में एक स्टैंडर्ड टाइप डेटाबेस बनाया। मैंने प्रत्येक समाचार श्रेणी के लिए एक सॉर्टेड सेट का उपयोग किया। इसलिए सभी World समाचार लेख कुंजी World के साथ सॉर्टेड सेट में होंगे।
डेटाबेस इनिशियलाइज़ करें
मैंने NYTimes API साइट से 7,001 समाचार लेखों को JSON फ़ाइल के रूप में डाउनलोड किया, फिर प्रत्येक डेटाबेस के लिए एक NodeJS स्क्रिप्ट बनाई जो JSON पढ़ती है और समाचार रिकॉर्ड को डेटाबेस में डालती है। फ़ाइलें देखें: initDynamo.js, initFauna.js, initRedis.js
DynamoDB क्वेरी करें
मैंने DynamoDB से कनेक्ट करने के लिए AWS SDK का उपयोग किया। लेटेंसी को कम करने के लिए, मैं DynamoDB कनेक्शन को जीवित रख रहा हूँ। मैंने प्रतिक्रिया समय मापने के लिए perf_hooks लाइब्रेरी का उपयोग किया है। मैं DynamoDB से शीर्ष 10 लेखों के लिए क्वेरी करने से ठीक पहले वर्तमान समय रिकॉर्ड करता हूँ। जैसे ही मुझे DynamoDB से प्रतिक्रिया मिलती है, मैं लेटेंसी की गणना करता हूँ। फिर मैं लेखों को यादृच्छिक रूप से स्कोर करता हूँ और लेटेंसी नंबर को एक Redis सॉर्टेड सेट में डालता हूँ लेकिन ये भाग लेटेंसी गणना भाग के बाहर हैं। नीचे कोड देखें:
var AWS = require("aws-sdk");
AWS.config.update({ region: "us-west-1" });
const https = require("https");
const agent = new https.Agent({ keepAlive: true, maxSockets: Infinity });
AWS.config.update({ httpOptions: { agent } });
const Redis = require("ioredis");
const { performance } = require("perf_hooks");
const tableName = "news";
var params = {
  TableName: tableName,
  IndexName: "section-view_count-index",
  KeyConditionExpression: "#sect = :section",
  ExpressionAttributeNames: { "#sect": "section" },
  ExpressionAttributeValues: { ":section": process.env.SECTION },
  Limit: 10,
  ScanIndexForward: false,
};
const docClient = new AWS.DynamoDB.DocumentClient();
module.exports.load = (event, context, callback) => {
  let start = performance.now();
  docClient.query(params, (err, result) => {
    if (err) {
      console.error("Unable to scan the table. Error JSON:", JSON.stringify(err, null, 2));
    } else {
      let latency = performance.now() - start;
      let response = {
        statusCode: 200,
        headers: { "Access-Control-Allow-Origin": "*", "Access-Control-Allow-Credentials": true },
        body: JSON.stringify({ latency: latency, data: result }),
      };
      result.Items.forEach((item) => {
        let view_count = Math.floor(Math.random() * 1000);
        var params2 = {
          TableName: tableName,
          Key: { id: item.id },
          UpdateExpression: "set view_count = :r",
          ExpressionAttributeValues: { ":r": view_count },
        };
        docClient.update(params2, function (err, data) {
          if (err) { console.error("Unable to update item. Error JSON:", JSON.stringify(err, null, 2)); }
        });
      });
      const client = new Redis(process.env.LATENCY_REDIS_URL);
      client.lpush("histogram-dynamo", latency, (resp) => { client.quit(); callback(null, response); });
    }
  });
};
FaunaDB क्वेरी करें
मैंने FaunaDB से कनेक्ट और क्वेरी करने के लिए faunadb लाइब्रेरी का उपयोग किया। शेष भाग DynamoDB कोड के समान है। लेटेंसी को कम करने के लिए, मैं कनेक्शन को जीवित रख रहा हूँ। मैंने प्रतिक्रिया समय मापने के लिए perf_hooks लाइब्रेरी का उपयोग किया है। मैं FaunaDB से शीर्ष 10 लेखों के लिए क्वेरी करने से ठीक पहले वर्तमान समय रिकॉर्ड करता हूँ। जैसे ही मुझे FaunaDB से प्रतिक्रिया मिलती है, मैं लेटेंसी की गणना करता हूँ। फिर मैं लेखों को यादृच्छिक रूप से स्कोर करता हूँ और लेटेंसी नंबर को एक Redis सॉर्टेड सेट में भेजता हूँ लेकिन ये भाग लेटेंसी गणना भाग के बाहर हैं। नीचे कोड देखें:
const faunadb = require("faunadb");
const Redis = require("ioredis");
const { performance } = require("perf_hooks");
const q = faunadb.query;
const client = new faunadb.Client({ secret: process.env.FAUNA_SECRET, keepAlive: true });
const section = process.env.SECTION;
module.exports.load = async (event) => {
  let start = performance.now();
  let ret = await client.query(
    q.Map(
      q.Paginate(q.Match(q.Index("section_by_view_count"), section), { size: 10 }),
      q.Lambda(["view_count", "X"], q.Get(q.Var("X")))
    )
  ).catch((err) => console.error("Error: %s", err));
  console.log(ret);
  let latency = performance.now() - start;
  const rclient = new Redis(process.env.LATENCY_REDIS_URL);
  await rclient.lpush("histogram-fauna", latency);
  await rclient.quit();
  let result = [];
  for (let i = 0; i < ret.data.length; i++) { result.push(ret.data[i].data); }
  ret.data.forEach((item) => {
    let view_count = Math.floor(Math.random() * 1000);
    client.query(
      q.Update(q.Ref(q.Collection("news"), item["ref"].id), { data: { view_count } })
    ).catch((err) => console.error("Error: %s", err));
  });
  return {
    statusCode: 200,
    headers: { "Access-Control-Allow-Origin": "*", "Access-Control-Allow-Credentials": true },
    body: JSON.stringify({ latency: latency, data: { Items: result } }),
  };
};
Redis क्वेरी करें
मैंने Upstash में Redis से कनेक्ट और पढ़ने के लिए ioredis लाइब्रेरी का उपयोग किया। मैंने सॉर्टेड सेट से डेटा लोड करने के लिए ZREVRANGE कमांड का उपयोग किया। लेटेंसी को कम करने के लिए, मैंने फ़ंक्शन के बाहर Redis क्लाइंट बनाकर कनेक्शन का पुन: उपयोग किया। DynamoDB और FaunaDB के समान, मैं स्कोर अपडेट कर रहा हूँ और हिस्टोग्राम गणना के लिए लेटेंसी नंबर को दूसरे Redis DB में भेज रहा हूँ। कोड देखें:
const Redis = require("ioredis");
const { performance } = require("perf_hooks");
const client = new Redis(process.env.REDIS_URL);
module.exports.load = async (event) => {
  let section = process.env.SECTION;
  let start = performance.now();
  let data = await client.zrevrange(section, 0, 9);
  let items = [];
  for (let i = 0; i < data.length; i++) { items.push(JSON.parse(data[i])); }
  let latency = performance.now() - start;
  for (let i = 0; i < data.length; i++) {
    let view_count = Math.floor(Math.random() * 1000);
    await client.zadd(section, view_count, data[i]);
  }
  const client2 = new Redis(process.env.LATENCY_REDIS_URL);
  await client2.lpush("histogram-redis", latency);
  await client2.quit();
  return {
    statusCode: 200,
    headers: { "Access-Control-Allow-Origin": "*", "Access-Control-Allow-Credentials": true },
    body: JSON.stringify({ latency: latency, data: { Items: items } }),
  };
};
हिस्टोग्राम गणना
मैंने हिस्टोग्राम की गणना के लिए hdr-histogram-js लाइब्रेरी का उपयोग किया। यह Gil Tene के hdr-histogram लाइब्रेरी का JS कार्यान्वयन है। लेटेंसी नंबर प्राप्त करने और हिस्टोग्राम की गणना करने वाले लैम्ब्डा फ़ंक्शन का कोड देखें।
const Redis = require("ioredis");
const hdr = require("hdr-histogram-js");
module.exports.load = async (event) => {
  const client = new Redis(process.env.LATENCY_REDIS_URL);
  let dataRedis = await client.lrange("histogram-redis", 0, 10000);
  let dataDynamo = await client.lrange("histogram-dynamo", 0, 10000);
  let dataFauna = await client.lrange("histogram-fauna", 0, 10000);
  const hredis = hdr.build();
  const hdynamo = hdr.build();
  const hfauna = hdr.build();
  dataRedis.forEach((item) => { hredis.recordValue(item); });
  dataDynamo.forEach((item) => { hdynamo.recordValue(item); });
  dataFauna.forEach((item) => { hfauna.recordValue(item); });
  await client.quit();
  return {
    statusCode: 200,
    headers: { "Access-Control-Allow-Origin": "*", "Access-Control-Allow-Credentials": true },
    body: JSON.stringify({
      redis_min: hredis.minNonZeroValue, dynamo_min: hdynamo.minNonZeroValue, fauna_min: hfauna.minNonZeroValue,
      redis_mean: hredis.mean, dynamo_mean: hdynamo.mean, fauna_mean: hfauna.mean,
      redis_histogram: hredis, dynamo_histogram: hdynamo, fauna_histogram: hfauna,
    }, null, 2),
  };
};
परिणाम
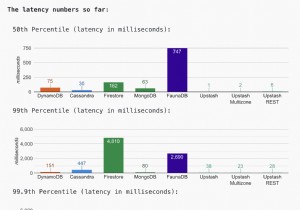
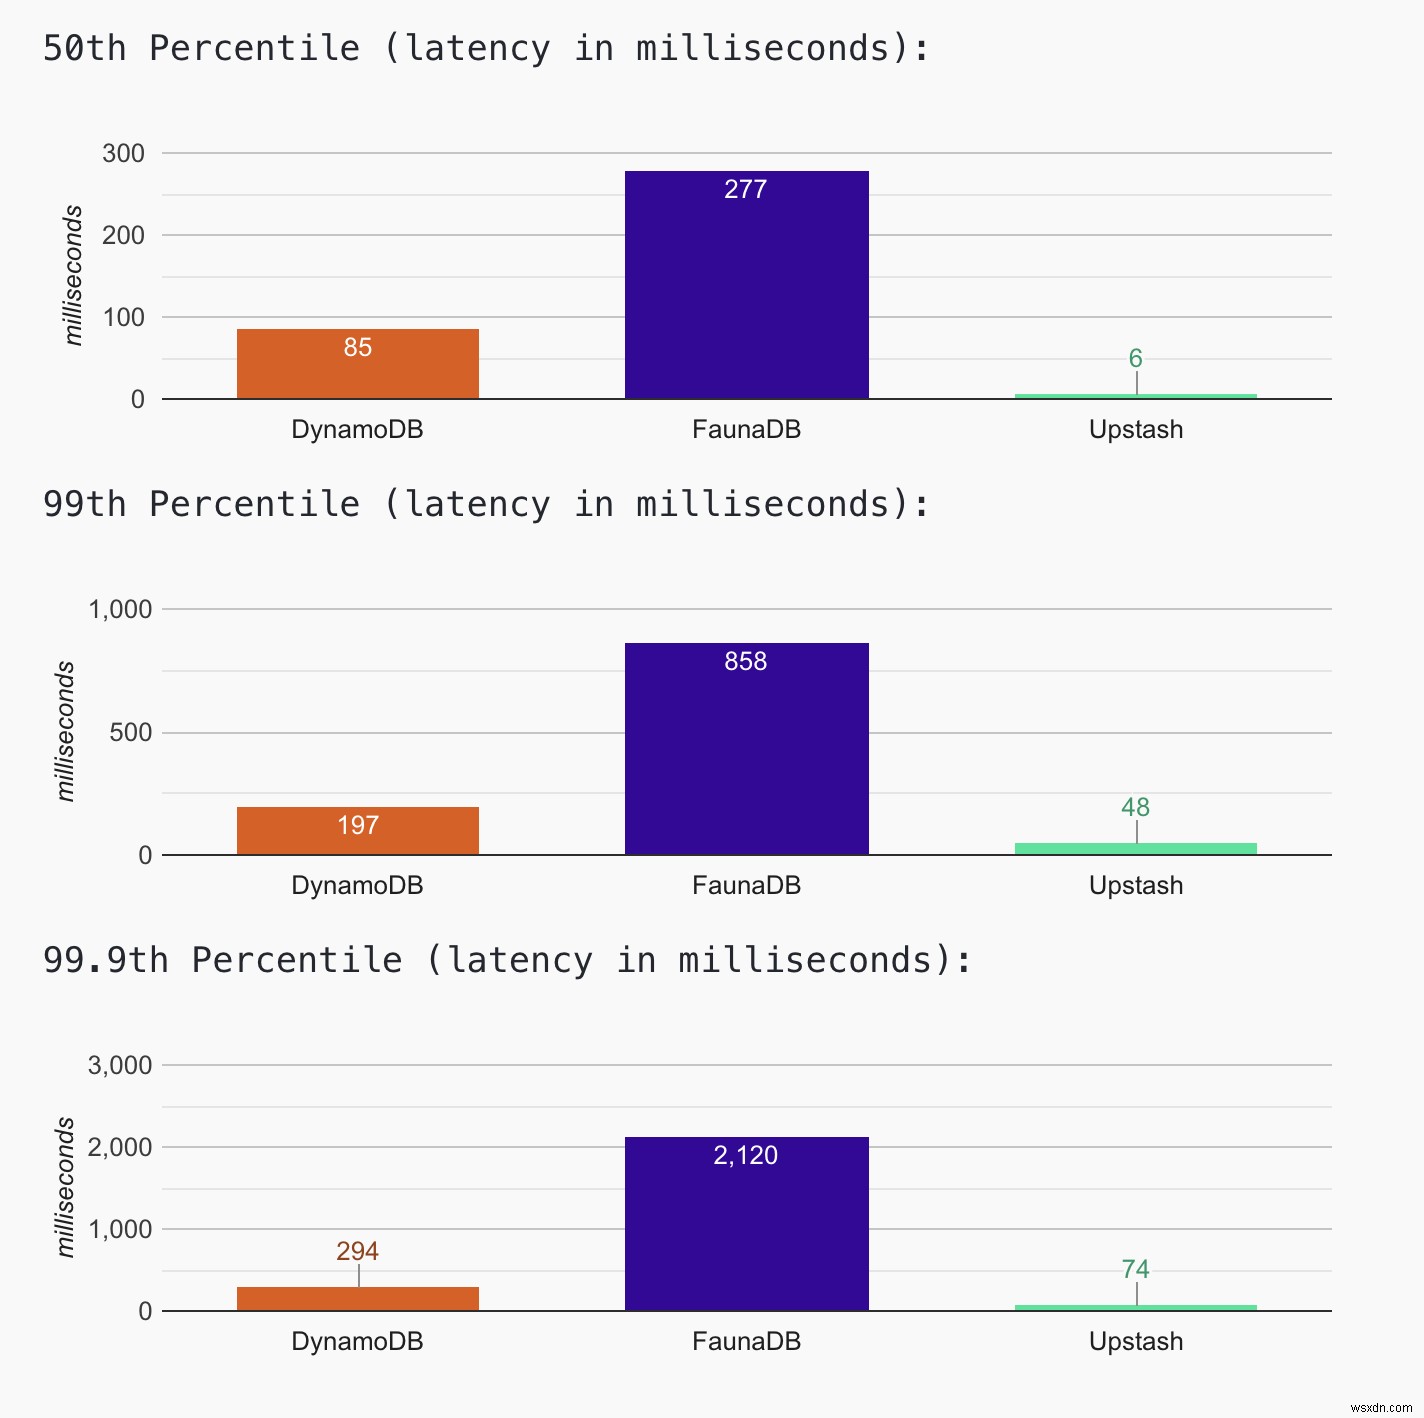
वेबसाइट पर नवीनतम परिणाम देखें। आप नवीनतम हिस्टोग्राम डेटा तक भी पहुंच सकते हैं। जब तक वेबसाइट चालू है और चल रही है, हम डेटा एकत्र करना जारी रखेंगे और हिस्टोग्राम को अपडेट करेंगे। आज (12 अप्रैल, 2021) के परिणाम दिखाते हैं कि Upstash की सबसे कम लेटेंसी (~50ms 99वें पर्सेंटाइल पर) है जबकि FaunaDB की सबसे अधिक लेटेंसी (~900ms 99वें पर्सेंटाइल पर) है। DynamoDB की (~200ms 99वें पर्सेंटाइल पर) है।
कोल्ड स्टार्ट प्रभाव
हालांकि हम केवल क्वेरी भाग के लिए लेटेंसी मापते हैं, कोल्ड स्टार्ट का अभी भी प्रभाव पड़ता है। हम क्लाइंट कनेक्शन का पुन: उपयोग करके अपने कोड को अनुकूलित करते हैं। हम इससे तब तक लाभान्वित होते हैं जब तक Lambda कंटेनर गर्म और चल रहा है। जब AWS कंटेनर को मारता है (कोल्ड स्टार्ट), तो कोड क्लाइंट को फिर से बनाता है, यह एक ओवरहेड है। एप्लिकेशन वेबसाइट में, यदि आप पेज रीफ्रेश करते हैं; आप देखेंगे कि Upstash के लिए लेटेंसी नंबर ~1ms तक घट जाते हैं; और DynamoDB के लिए ~7ms।
इस बेंचमार्क में FaunaDB धीमा क्यों है?
FaunaDB के स्टेटस पेज में, आप सैकड़ों में लेटेंसी नंबर देखेंगे। इसलिए मुझे लगता है कि मेरे कॉन्फ़िगरेशन में बड़ी खामियां नहीं हैं। इस लेटेंसी अंतर के पीछे दो कारण हो सकते हैं:
मजबूत स्थिरता: डिफ़ॉल्ट रूप से, दोनों DynamoDB और Upstash रीड्स के लिए eventual consistency प्रदान करते हैं। FaunaDB Calvin-आधारित मजबूत स्थिरता और आइसोलेशन प्रदान करता है। मजबूत स्थिरता प्रदर्शन ओवरहेड के साथ आती है।
वैश्विक प्रतिकृति: Upstash और DynamoDB दोनों के लिए, हम डेटाबेस और लैम्ब्डा फ़ंक्शन को एक ही AWS क्षेत्र में कॉन्फ़िगर करने में सक्षम हैं। FaunaDB में, आपका डेटा दुनिया भर में दोहराया जाता है; इसलिए आपके पास अपना क्षेत्र चुनने का विकल्प नहीं है। यदि आपके डेटाबेस क्लाइंट्स दुनिया भर में स्थित हैं तो यह एक फायदा हो सकता है। लेकिन यदि आप अपने बैकएंड को एक विशिष्ट क्षेत्र में तैनात करते हैं, तो यह अतिरिक्त लेटेंसी का कारण बनता है।
Redis सब-मिलीसेकंड लेटेंसी देता है। यहां ऐसा क्यों नहीं है?
AWS Lambda फ़ंक्शन में एक नया Redis कनेक्शन बनाने से उल्लेखनीय ओवरहेड होता है। चूंकि एप्लिकेशन को स्थिर ट्रैफिक नहीं मिलता, AWS Lambda अधिकांश समय कनेक्शन को फिर से बनाता है (कोल्ड स्टार्ट)। इसलिए हिस्टोग्राम में अधिकांश लेटेंसी नंबर कनेक्शन निर्माण समय शामिल करते हैं। हम एक जॉब चलाते हैं जो हर 15 सेकंड में वेबसाइट को फेच करता है; हमने देखा कि Upstash के लिए लेटेंसी ~1ms तक घट गई है। यदि आप पेज रीफ्रेश करते हैं, तो आप एक समान प्रभाव देखेंगे। सर्वरलेस एप्लिकेशन को कम लेटेंसी के लिए अनुकूलित करने के तरीके के लिए हमारा ब्लॉग पोस्ट देखें।
जल्द आ रहा है
Upstash जल्द ही प्रीमियम उत्पाद जारी करेगा जहां डेटा को कई उपलब्धता क्षेत्रों में दोहराया जाता है। मैं यह देखने के लिए इसे जोड़ूंगा कि ज़ोन प्रतिकृति का क्या प्रभाव पड़ता है।
अपनी प्रतिक्रिया ट्विटर या डिस्कॉर्ड पर बताएं।
अपडेट
HackerNews पर मेरे बेंचमार्क और Fauna के प्रदर्शन के बारे में सक्रिय चर्चा थी। मैंने सुझावों को लागू किया और FaunaDB एप्लिकेशन को रीस्टार्ट किया। इसलिए, हिस्टोग्राम में FaunaDB रिकॉर्ड की संख्या दूसरों की तुलना में कम है।