हाल के वर्षों में, सर्वरलेस आर्किटेक्चर और एज कंप्यूटिंग एप्लिकेशन डिप्लॉयमेंट के लिए बहुत लोकप्रिय हो रहे हैं। लेकिन सर्वरलेस और/या एज फंक्शन के अंदर एप्लिकेशन स्टेट और डेटा को स्टोर करना एक अलग कहानी है। कई कठिनाइयाँ हैं जैसे; डेटाबेस से कनेक्शन मैनेज करना, डेटा को कई स्थानों से तेज़ एक्सेस के लिए उपलब्ध कराना आदि। केवल कुछ डेटाबेस सर्विसेज सर्वरलेस एक्सेस का समर्थन करती हैं और उनमें से बहुत कम एज फंक्शन के लिए भी उपयुक्त हैं। (आप एक विस्तृत विश्लेषण यहां पढ़ सकते हैं।)
अपस्टैश में, पहले दिन से, हम कम लेटेंसी के साथ और प्रति-रिक्वेस्ट प्राइसिंग मॉडल के साथ एक सर्वरलेस रेडिस-संगत डेटाबेस प्रदान कर रहे हैं। इसके अलावा हम डेटाबेस पर सीधे निर्मित एक फर्स्ट-क्लास REST API एक्सपोज़ करते हैं। REST API कनेक्शन मैनेजमेंट की परेशानी को दूर करता है, खासकर जब सर्वरलेस फंक्शन में उपयोग किया जाता है, लेकिन एज लोकेशन या वेब ब्राउज़र जैसे प्रतिबंधित वातावरण से भी सुलभ होता है।
आज हमें ग्लोबल डेटाबेस की घोषणा करते हुए खुशी हो रही है, जो डेटाबेस को विश्व स्तर पर, क्लाइंट और एज लोकेशन के करीब, कम लेटेंसी रीड के लिए उपलब्ध कराने की दिशा में एक कदम आगे है। ग्लोबल डेटाबेस फ्री टियर पर उपलब्ध है, आप इसे बिना किसी लागत के आज़मा सकते हैं।
कब उपयोग करें?
एक ग्लोबल डेटाबेस को विभिन्न महाद्वीपों पर कई क्षेत्रों में डिप्लॉय किया जाता है और क्लाइंट रिक्वेस्ट को निकटतम क्षेत्र में रूट किया जाता है ताकि जब उपयोगकर्ता दुनिया भर में वितरित हों तो लेटेंसी को कम किया जा सके। अपस्टैश ग्लोबल डेटाबेस का उपयोग इसके लिए किया जा सकता है:
एज फंक्शन (क्लाउडफ्लेयर वर्कर्स, फास्टली कंप्यूट): बिल्ट-इन REST API और सभी एज लोकेशन से कम लेटेंसी एक्सेस इसे एक आदर्श समाधान बनाता है।
मल्टी-रीजन सर्वरलेस डिप्लॉयमेंट: AWS लैम्ब्डा, वर्सेल और नेटलीफाई फंक्शन को कई क्षेत्रों में डिप्लॉय किया जा सकता है। एक ग्लोबल डेटाबेस कम लेटेंसी डेटा प्रदान करता है जहां भी आपके सर्वरलेस फंक्शन हैं।
वेब/मोबाइल प्लेटफॉर्म: रीड-ओनली REST API का उपयोग करके, आप वेब/मोबाइल एप्लिकेशन से सीधे रेडिस डेटाबेस तक पहुंच सकते हैं। एक ग्लोबल डेटाबेस बेहतर लेटेंसी प्रदान करेगा क्योंकि आप उपयोगकर्ताओं के कहीं से भी होने की उम्मीद कर सकते हैं।
ग्लोबल डेटाबेस के पीछे एक अन्य लक्ष्य डेटाबेस को क्षेत्र-व्यापी विफलताओं के प्रति लचीला बनाना है। जब कोई क्षेत्र उपलब्ध नहीं होता है, तो आपके रिक्वेस्ट को निकटतम उपलब्ध क्षेत्र में रूट किया जाता है; इसलिए आपका डेटाबेस उपलब्ध रहता है।
यह कैसे काम करता है?
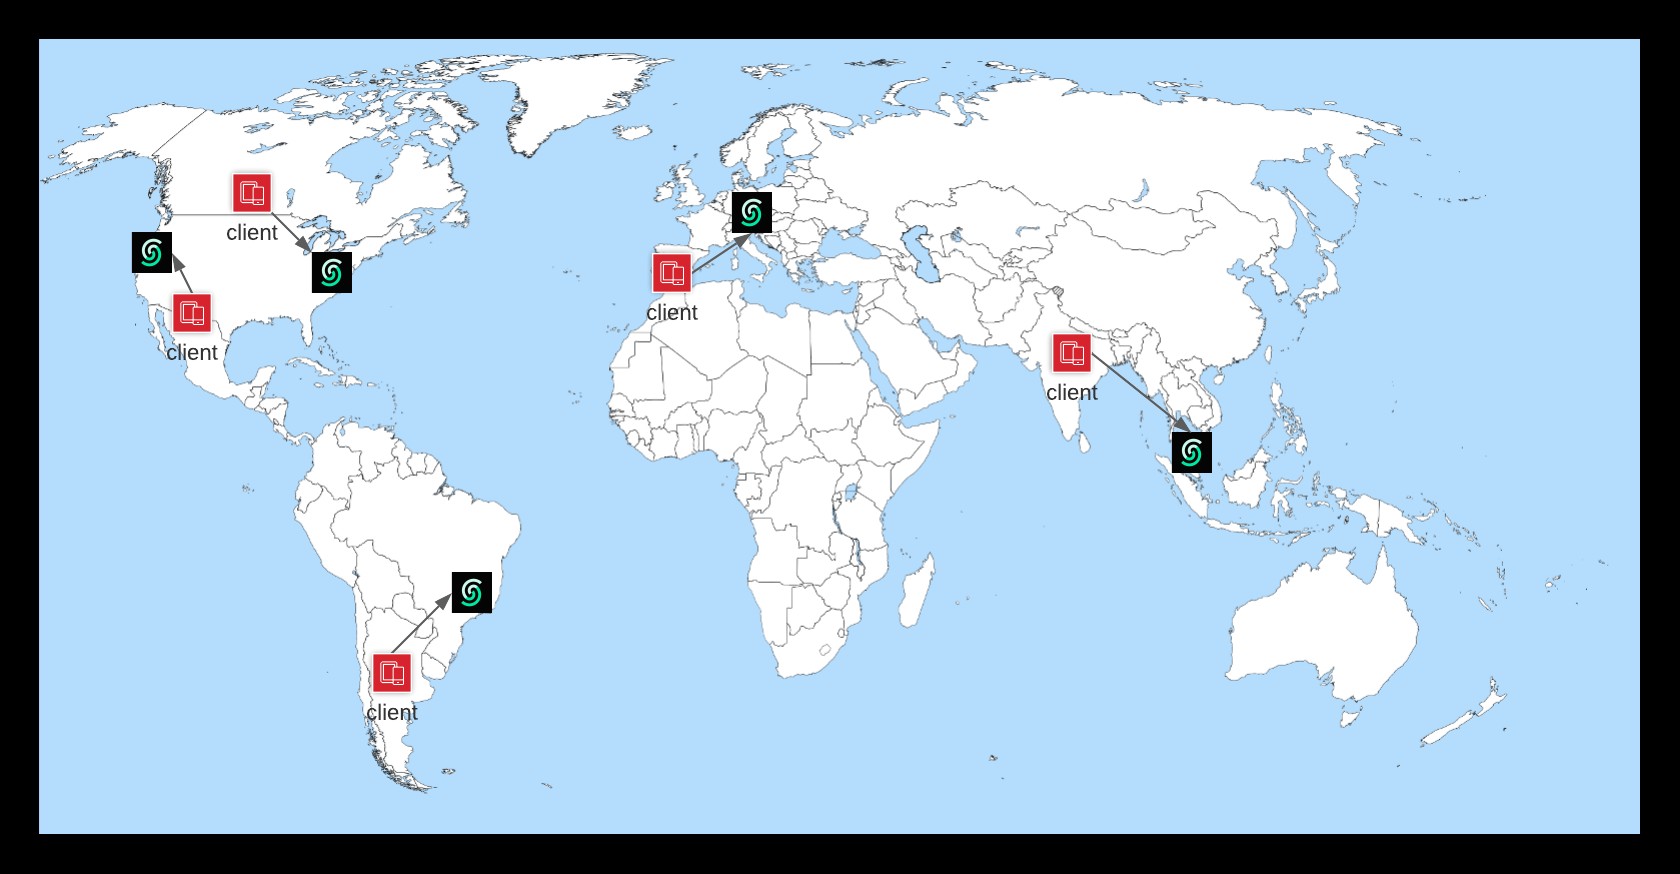
ग्लोबल डेटाबेस मॉडल में, एक ही डेटाबेस की कई रेप्लिका होती हैं और वे मिलकर एक क्लस्टर बनाती हैं। प्रत्येक रेप्लिका अन्य क्लस्टर सदस्यों से जुड़ी होती है और एक फेल्योर डिटेक्टर का उपयोग करके उनमें से प्रत्येक की लाइवनेस को ट्रैक करती है। दोनों क्लस्टर सदस्यता और फेल्योर डिटेक्शन को गॉसिप-आधारित कम्युनिकेशन प्रोटोकॉल का उपयोग करके मैनेज किया जाता है। (देखें SWIM: स्केलेबल वीकली-कंसिस्टेंट इन्फेक्शन-स्टाइल प्रोसेस ग्रुप मेंबरशिप प्रोटोकॉल।)
डेटा को रेप्लिकेट करने के लिए (अधिक विशेष रूप से, व्यक्तिगत लिखने/अपडेट/डिलीट), सिंगल लीडर रेप्लिकेशन मॉडल का उपयोग किया जाता है। कीज़ के एक ग्रुप को एक लीडर रेप्लिका को असाइन किया जाता है, जिसे मेंबरशिप परिवर्तन के बाद लीडर इलेक्शन मैकेनिज्म का उपयोग करके चुना जाता है। शेष रेप्लिका उस ग्रुप की के लिए उस लीडर के बैकअप बन जाते हैं। जब लीडर रेप्लिका को फेल्योर डिटेक्टर द्वारा विफल के रूप में पता लगाया जाता है, तो शेष रेप्लिका एक नया लीडर इलेक्शन राउंड शुरू करते हैं और एक नया लीडर चुनते हैं। इलेक्शन प्रक्रिया के दौरान, डेटाबेस थोड़े समय के लिए अनुपलब्ध हो जाता है और सभी रिक्वेस्ट तब तक ब्लॉक रहेंगे जब तक इलेक्शन पूरा नहीं हो जाता।
केवल लीडर रेप्लिका राइट रिक्वेस्ट को स्वीकार और प्रोसेस करती है, बैकअप रेप्लिका आंतरिक रूप से क्लाइंट को सूचित किए बिना राइट को लीडर को फॉरवर्ड करती हैं। इसलिए रेप्लिका टाइप की परवाह किए बिना, लीडर या बैकअप, एक क्लाइंट राइट रिक्वेस्ट भेज सकता है। राइट रिक्वेस्ट को प्रोसेस करने के बाद, लीडर रेप्लिका इसे बैकअप रेप्लिका में प्रचारित करती है।
सुसंगतता पर अधिक
वर्तमान में, ग्लोबल डेटाबेस वीकली कंसिस्टेंट हैं, वे अभी तक स्ट्रांग कंसिस्टेंसी का समर्थन नहीं करते हैं। राइट रिक्वेस्ट का रिस्पॉन्स क्लाइंट को तब वापस किया जाता है जब लीडर रेप्लिका ऑपरेशन को प्रोसेस करती है, बिना बैकअप के बहुमत से ACK की प्रतीक्षा किए। राइट का परिणाम बैकअप रेप्लिका को एसिंक्रोनसली समानांतर में रेप्लिकेट किया जाता है।
रीड रिक्वेस्ट किसी भी रेप्लिका द्वारा प्रोसेस की जाती हैं, जो बेहतर रीड स्केलेबिलिटी देता है लेकिन इसका मतलब यह भी है कि एक रीड रिक्वेस्ट तब तक बासी मान वापस कर सकती है जब तक उसी की के लिए राइट ऑपरेशन का परिणाम बैकअप रेप्लिका तक नहीं पहुंच जाता।
कंफ्लिक्ट के बिना आसान होता!
क्लस्टर-वाइड विफलता के मामले में जैसे नेटवर्क पार्टीशन, एक ही की के लिए कई लीडर चुने जा सकते हैं। इसका मतलब है कि कई रेप्लिका राइट स्वीकार करती हैं और डेटा विभिन्न रेप्लिका पर डाइवर्ज होता है। Calvin या Spanner (या शायद Paxos, Raft) जैसे प्रोटोकॉल का उपयोग करके एक मजबूत मॉडल के साथ शुरुआत में कंफ्लिक्ट को रोकना संभव होगा, लेकिन यह एक अलग रास्ता है जिसे हम अभी नहीं लेना चाहते।
इसके बजाय, ग्लोबल डेटाबेस कंफ्लिक्ट को होने देता है और LWW (लास्ट-राइट-विंस) एल्गोरिदम का उपयोग करके उन्हें हल करता है और रेप्लिका को अंततः उसी स्थिति में कन्वर्ज करता है। अपस्टैश डेटाबेस में प्रत्येक राइट का एक यूनिक, मोनोटोनिक सीक्वेंस नंबर होता है। हर बार जब कोई रेप्लिका लीडर बनती है, तो यह उस पहले राइट के सीक्वेंस को चिह्नित करती है जिसे यह प्रोसेस करती है। जब दो लीडर रेप्लिका एक-दूसरे को खोजते हैं, तो वे लीडर बनने के बाद अपने राइट साझा करते हैं, और अपने कंफ्लिक्ट को हल करते हैं।
सभी रेप्लिका समान नहीं हैं
कुछ रेप्लिका दूसरों की तुलना में अधिक समान हैं। क्योंकि केवल उनमें से कुछ को लीडर के रूप में चुना जा सकता है। एक ग्लोबल डेटाबेस क्लस्टर में, एक रेप्लिका को लर्नर के रूप में चिह्नित किया जा सकता है, जो इसे लीडर इलेक्शन के लिए अनुपयुक्त बनाता है। लर्नर रेप्लिका हमेशा रीड-ओनली रहती हैं और लीडरशिप के लिए उम्मीदवार नहीं बन सकतीं।
लर्नर रेप्लिका जोड़ने से क्लस्टर की स्थिरता प्रभावित नहीं होती और जब वे अलग हो जाते हैं तो वे राइट कंफ्लिक्ट का कारण नहीं बन सकते। यहां तक कि जब वे लीडर से अलग हो जाते हैं, तब भी वे रीड रिक्वेस्ट की अनुमति देना जारी रखते हैं और विभाजन ठीक होने के बाद शेष राइट को सिंक करते हैं। इसलिए लर्नर रेप्लिका हमारे लिए अधिक एज लोकेशन का विस्तार करने के लिए एक बहुत अच्छी उपयोगिता हैं।
अधिक क्षेत्र, अधिक रेप्लिका?
हमारे प्रारंभिक रिलीज में, हम पांच रेप्लिका के साथ और पांच क्षेत्रों में ग्लोबल डेटाबेस की पेशकश कर रहे हैं। और US और EU क्षेत्रों के बाहर की रेप्लिका को लर्नर के रूप में चिह्नित किया गया है, इसलिए केवल US और EU क्षेत्रों में रेप्लिका को लीडर के रूप में चुना जा सकता है। यह नेटवर्क पार्टीशन के दौरान राइट-कंफ्लिक्ट की संभावना को कम करता है। लेकिन यह हमें नेटवर्क पार्टीशन की चिंता किए बिना अधिक क्षेत्रों को लर्नर रेप्लिका के रूप में जोड़ने की अनुमति भी देता है।
अभी भी जाने का रास्ता
वर्तमान में ग्लोबल डेटाबेस को केवल रीड ऑपरेशन की लेटेंसी को अनुकूलित/न्यूनतम करने के लिए डिज़ाइन किया गया है। वे राइट-हेवी लोड के लिए उपयुक्त नहीं हैं। हम बेहतर डिज़ाइन के साथ राइट ऑपरेशन की लेटेंसी में सुधार करने पर काम कर रहे हैं।
प्रारंभिक पांच-क्षेत्र सेटअप के अलावा, हम मांग और अपने उपयोगकर्ताओं से फीडबैक के कारण भविष्य में अधिक क्षेत्र और/या विभिन्न क्षेत्र समूह खोलने पर विचार कर रहे हैं।
आप अपने विचार/आइडिया साझा करने और अपने प्रश्नों के लिए ट्विटर और डिस्कॉर्ड पर हमसे संपर्क कर सकते हैं।