आज हमें RedisGraph 2.8 के सामान्य उपलब्धता रिलीज की घोषणा करते हुए खुशी हो रही है। यह ब्लॉग पोस्ट अब उपलब्ध प्रमुख नई सुविधाओं का विवरण देता है।
RedisGraph के बारे में
RedisGraph, Redis के लिए एक उच्च-प्रदर्शन, मेमोरी-फर्स्ट ग्राफ डेटा संरचना है। RedisGraph ग्राफ मल्टी-टेनेंसी का समर्थन करता है (यह एक साथ कई ग्राफ रख सकता है) और ग्राफ़ को एक साथ एक्सेस करने वाले कई क्लाइंट को सेवा दे सकता है। यह अब Redis Stack के हिस्से के रूप में भी उपलब्ध है।
RedisGraph 2.8 में प्रमुख नई सुविधाएँ
- समृद्ध ग्राफ मॉडल
- मल्टी-लेबल नोड्स
- उन्नत क्वेरी क्षमताएँ
- उन्नत फुल-टेक्स्ट खोज
- अधिक साइफर निर्माण, फ़ंक्शन और ऑपरेटर का समर्थन
- प्रदर्शन सुधार
- संबंध गुणों पर इंडेक्स
- डेल्टा मैट्रिक्स
- नियंत्रणीय नोड निर्माण बफर
- बेंचमार्क
समृद्ध ग्राफ मॉडल
मल्टी-लेबल नोड्स
लेबल्ड प्रॉपर्टी ग्राफ (LPG) डेटा मॉडल की कई परिभाषाएँ (जैसे द प्रॉपर्टी ग्राफ डेटाबेस मॉडल – एंगल्स, 2018, और ISO/IEC JTC 1/SC 32 – GQL ड्राफ्ट) निर्दिष्ट करती हैं कि एक नोड में कई लेबल हो सकते हैं। v2.8 तक, RedisGraph केवल एक लेबल का समर्थन करता था। अब, हम बिना किसी प्रदर्शन गिरावट या महत्वपूर्ण मेमोरी वृद्धि के प्रत्येक नोड में कई लेबल जोड़ सकते हैं।
कई लेबल वाले नोड बनाने के लिए, आप बस सभी लेबल को कोलन से अलग करके सूचीबद्ध करते हैं:
GRAPH.QUERY g "CREATE (e:Employee:BoardMember {Name: 'Vincent Chan', Title: 'Web marketing lead'}) return e"
कई लेबल वाले नोड से मिलान करने के लिए (AND स्थिति), आपको उसी कोलन नोटेशन का उपयोग करना चाहिए:
GRAPH.QUERY g "MATCH (e:Employee:BoardMember) return e"
उन्नत क्वेरी क्षमताएँ
उन्नत फुल-टेक्स्ट खोज
RedisGraph, RedisSearch के साथ एम्बेडेड आता है और सेकेंडरी इंडेक्सिंग के लिए इसका लाभ उठाता है, लेकिन इसका उपयोग उन्नत इंडेक्सिंग और खोज के लिए भी किया जा सकता है। उदाहरण के लिए – पृथ्वी पर दिए गए बिंदु के भौगोलिक निकटता के आधार पर नोड्स ढूंढना, या संबंधित वस्तुओं को उच्च स्कोर देना।
संस्करण 2.8 भाषा और स्टॉपवर्ड्स कॉन्फ़िगरेशन विकल्प जोड़ता है। भाषा परिभाषित करती है कि टेक्स्ट को स्टेम करने के लिए किस भाषा का उपयोग करना है – जो शब्द के मूल रूप को इंडेक्स में जोड़ना है। यह "going" क्वेरी को "go" और "gone" के परिणाम भी वापस करने की अनुमति देता है। स्टॉपवर्ड्स बहुत आम शब्द हैं (जैसे "is, the, an, and…") जो खोज में ज्यादा जानकारी नहीं जोड़ते लेकिन इंडेक्स में बहुत जगह लेते हैं। ये शब्द इंडेक्स नहीं किए जाते और खोज करते समय नजरअंदाज किए जाते हैं। स्टॉपवर्ड वाले क्वेरी टर्म, जैसे "in Paris" को केवल "Paris" के रूप में देखा जाएगा।
जर्मन भाषा का उपयोग करके और 'Movie' लेबल वाले सभी नोड्स के कस्टम स्टॉपवर्ड्स के साथ मूवी के टाइटल प्रॉपर्टी पर फुल-टेक्स्ट इंडेक्स बनाने के लिए:
GRAPH.QUERY DEMO_GRAPH "CALL db.idx.fulltext.createNodeIndex({ label: 'Movie', language: 'German', stopwords: ['a', 'ab'] }, 'title')"
RediSearch 3 अतिरिक्त फील्ड कॉन्फ़िगरेशन विकल्प प्रदान करता है:
- weight – फील्ड में टेक्स्ट का महत्व
- nostem – टेक्स्ट इंडेक्स करते समय स्टेमिंग छोड़ें
- phonetic – टेक्स्ट पर ध्वन्यात्मक खोज सक्षम करें
'Movie' लेबल वाले सभी नोड्स के टाइटल प्रॉपर्टी पर ध्वन्यात्मक खोज के साथ फुल-टेक्स्ट इंडेक्स बनाने के लिए:
GRAPH.QUERY DEMO_GRAPH "CALL db.idx.fulltext.createNodeIndex('Movie', {field: 'title', phonetic: 'dm:en'})"
अधिक साइफर निर्माण, फ़ंक्शन और ऑपरेटर का समर्थन
RedisGraph 2.8 ने साइफर समर्थन कवरेज बढ़ाया:
- पैटर्न कॉम्प्रिहेंशन
allShortestPaths
फ़ंक्शन के लिए समर्थन जोड़ें- साइफर फ़ंक्शन:
keys, reduce, replace, none,
औरsingle
SET
क्लॉज में नोड एट्रिब्यूट-सेट की कॉपी करनाWHERE
क्लॉज में नोड लेबल द्वारा फ़िल्टरिंग- साइफर ऑपरेटर:
XOR
और^
पैटर्न कॉम्प्रिहेंशन
पैटर्न कॉम्प्रिहेंशन साइफर में उपलब्ध एक सिंटैक्टिक निर्माण है। जहां लिस्ट कॉम्प्रिहेंशन हमें मौजूदा लिस्ट के आधार पर लिस्ट बनाने की अनुमति देते हैं, वहीं पैटर्न कॉम्प्रिहेंशन एक पैटर्न के मिलान के परिणामों से एक लिस्ट भरने का तरीका है। यह एक मानक
MATCHक्लॉज में निर्दिष्ट पैटर्न से मेल खाता है, एक मानक
WHEREक्लॉज में प्रेडिकेट के साथ, लेकिन एक निर्दिष्ट प्रोजेक्शन देता है।
उदाहरण के लिए, निम्न क्वेरी उन सभी ग्रांट प्रकारों की सूची लौटाएगी जो पुरुष कर्मचारियों द्वारा प्राप्त किए गए थे जहां ग्रांट राशि $1000 से अधिक थी।
GRAPH.QUERY g "CREATE (e:Employee {gender:'Male'})-[:granted]->(g:Grant {type: 'Research', amount: 2000})"
GRAPH.QUERY g "MATCH (e:Employee {gender:'Male'}) RETURN [(e)-[:granted]->(g:Grant) WHERE g.amount > 1000 | g.type] AS grantTypes"
allShortestPaths
फ़ंक्शन के लिए समर्थन जोड़ें
allShortestPathsफ़ंक्शन किसी जोड़ी के बीच सभी सबसे छोटे पथ लौटाता है जो सभी मानदंडों से मेल खाते हैं। दोनों एंटिटी को पहले
WITH-सीमांकित स्कोप में बांधा जाना चाहिए।
GRAPH.QUERY DEMO_GRAPH "MATCH (c:Actor {name: 'Charlie Sheen'}), (k:Actor {name: 'Kevin Bacon'}) WITH c, k MATCH p = allShortestPaths((c)-[:PLAYED_WITH*]->(k)) RETURN nodes(p) as actors"
यह क्वेरी चार्ली शीन का प्रतिनिधित्व करने वाले एक्टर नोड को केविन बेकन का प्रतिनिधित्व करने वाले नोड से जोड़ने वाले न्यूनतम लंबाई के सभी पथ उत्पन्न करेगी। दोनों एक्टर्स के बीच कई 2-हॉप पथ हैं, और ये सभी लौटाए जाएंगे। पथों की गणना तब समाप्त होती है, क्योंकि हमें 2 से अधिक लंबाई के किसी भी पथ में दिलचस्पी नहीं है।
खोज के लिए न्यूनतम लंबाई (कम से कम 1 होनी चाहिए) और अधिकतम लंबाई (कम से कम 1 होनी चाहिए) निर्दिष्ट की जा सकती है। शून्य या अधिक संबंध प्रकार निर्दिष्ट किए जा सकते हैं (जैसे
[:R|Q*1..3])। पैटर्न में कोई प्रॉपर्टी फ़िल्टर नहीं जोड़ा जा सकता।
keys
साइफर फ़ंक्शन के लिए समर्थन जोड़ें
keysफ़ंक्शन एक नोड, एक रिलेशनशिप, या एक मैप को इनपुट के रूप में स्वीकार करता है, और इनपुट में मौजूद सभी कुंजियों की एक सरणी लौटाता है।
MATCH (a) RETURN keys(a)
MATCH ()-[e]->() RETURN keys(e)
RETURN keys({a:1, b:2})
reduce
साइफर फ़ंक्शन के लिए समर्थन जोड़ें
reduceफ़ंक्शन एक प्रारंभिक मान और एक सूची स्वीकार करता है। यह तब सूची के प्रत्येक तत्व के खिलाफ एक अभिव्यक्ति का मूल्यांकन करके मान को अपडेट करता है।
GRAPH.QUERY g "RETURN reduce(sum = 0, n IN range(1,10) | sum + n)"
इस फ़ंक्शन का आउटपुट 55 होगा – 1 और 10 के बीच के पूर्णांकों का योग।
GRAPH.QUERY g "RETURN reduce(arr = [], n IN range(1,10) | arr + [n*n])"
इस फ़ंक्शन का आउटपुट 1 और 10 के बीच के पूर्णांकों के वर्गों वाली एक सरणी होगी।
साइफर स्ट्रिंग फ़ंक्शन बदलने के लिए समर्थन जोड़ें
दिए गए सबस्ट्रिंग के सभी घटनाओं को दूसरे से बदलता है। फ़ंक्शन 3 पैरामीटर प्राप्त करता है: मूल स्ट्रिंग, बदलने के लिए घटनाएं, और उन्हें किससे बदलना है।
GRAPH.QUERY g "RETURN replace('abc*efg', '*', 'd')"
रिटर्न मान 'abcdefg' होगा।
यह फ़ंक्शन सबस्ट्रिंग को खाली स्ट्रिंग ('') से बदलकर उन्हें हटा भी सकता है।
none
और single
साइफर फ़ंक्शन के लिए समर्थन जोड़ें
एक सूची दिए जाने पर,
noneसच लौटाता है यदि कोई तत्व प्रेडिकेट को संतुष्ट नहीं करता, जबकि
singleसच लौटाता है यदि दिया गया प्रेडिकेट केवल एक तत्व के लिए सही है।
GRAPH.QUERY g "RETURN none(x IN range(1,10) WHERE x>10)"
GRAPH.QUERY g "RETURN single(x IN range(1,10) WHERE x>9)"
ये फ़ंक्शन
allऔर
anyफ़ंक्शन के समान हैं।
एक संभावित उपयोग मामला पथ फ़िल्टरिंग है:
graph.query DEMO_GRAPH "MATCH p = (a {name:'Johnny Depp'})-[*2..5]->(b {name:'Kevin Bacon'}) WHERE none(n IN nodes(p) WHERE n.year > 1970) RETURN p"
यह क्वेरी जॉनी डेप से केविन बेकन तक लंबाई 2 से 5 के सभी पथ लौटाएगी, जिनमें 1970 के बाद जन्मा कोई एक्टर शामिल नहीं है।
SET
क्लॉज में नोड एट्रिब्यूट सेट की कॉपी करने के लिए समर्थन जोड़ें
SETक्लॉज का उपयोग एक नोड के सभी प्रॉपर्टी मानों को दूसरे नोड के प्रॉपर्टी मानों से बदलने या जोड़ने के लिए किया जा सकता है।
निम्न क्वेरी दो एंटिटी से मेल खाएगी, और फिर a के सभी प्रॉपर्टी को b के प्रॉपर्टी से बदल देगी:
GRAPH.QUERY g "MATCH (a {v: 1}), (b {v: 2}) SET a = b"
निम्न क्वेरी दो एंटिटी से मेल खाएगी, और फिर a के प्रॉपर्टी में b के प्रॉपर्टी जोड़ देगी (या मान बदल देगी)।
GRAPH.QUERY g "MATCH (a {v: 1}), (b {v: 2}) SET a += b"
हम प्रॉपर्टी बदले बिना रिलेशनशिप का प्रकार भी बदल सकते हैं:
GRAPH.QUERY g "MATCH (a)-[b]->(c) WHERE ID(b)=0 CREATE (a)-[d:bar]->(c) SET d=b DELETE b RETURN d"
WHERE
क्लॉज में नोड लेबल द्वारा फ़िल्टरिंग के लिए समर्थन जोड़ें
अब
WHEREक्लॉज में नोड लेबल या रिलेशनशिप प्रकार द्वारा फ़िल्टर करना संभव है:
GRAPH.QUERY g "MATCH (a) WHERE a:L RETURN a"
GRAPH.QUERY g "MATCH (a)-[b]-(c) WHERE b:L RETURN b"
साइफर ऑपरेटर XOR और ^ के लिए समर्थन जोड़ें
GRAPH.QUERY g "RETURN true XOR true"
GRAPH.QUERY g "RETURN 2 ^ 3"
परिणाम क्रमशः
falseऔर
8हैं।
प्रदर्शन सुधार
संबंध गुणों पर इंडेक्स
नोड्स के लिए, हम निम्न कमांड जारी करके इंडेक्स पेश कर सकते हैं:
GRAPH.QUERY g "CREATE INDEX FOR (n:GRANTS) ON (n.GrantedBy)"
अब संबंधों के लिए भी इंडेक्स पेश करना संभव है:
GRAPH.QUERY g "CREATE INDEX FOR ()-[r:R]-() ON (r.prop)"
निम्न क्वेरी पर विचार करें:
GRAPH.QUERY g "MATCH (a)-[r:R {prop:5}]-(b) return *"
इंडेक्स बनाने से पहले एक्जीक्यूशन प्लान देखते हैं:
redis:6379> GRAPH.EXPLAIN g "MATCH (a)-[r:R {prop:5}]-(b) return *"
1) "Results" 2) " Project" 3) " Filter" 4) " Conditional Traverse | (a)-[r:R]->(b)" 5) " All Node Scan | (a)" |
और इंडेक्स बनाने के बाद उसी क्वेरी के लिए एक्जीक्यूशन प्लान यह है:
redis:6379> GRAPH.EXPLAIN g "MATCH (a)-[r:R {prop:5}]-(b) return *"
1) "Results" 2) " Project" 3) " Edge By Index Scan | [r:R]" |
डेल्टा मैट्रिक्स
संस्करण 2.8 से, ग्राफ नोड्स और रिलेशनशिप के जोड़ और हटाने बहुत तेज हैं, क्योंकि वे पहले छोटे डेल्टा मैट्रिक्स में अपडेट किए जाते हैं। मुख्य मैट्रिक्स फिर बल्क-अपडेट किए जाते हैं।
RedisGraph में, ग्राफ एडजेंसी मैट्रिक्स के साथ दर्शाए जाते हैं। ग्राफ में हर नोड लेबल और हर रिलेशनशिप प्रकार का अपना मैट्रिक्स होता है। पहले, हर बार जब ग्राफ में एक नया नोड जोड़ा जाता था, तो सभी मैट्रिक्स को रीसाइज़ करने की आवश्यकता होती थी, और डेटाबेस जितना बड़ा होता था, इसमें उतना अधिक समय लगता था।
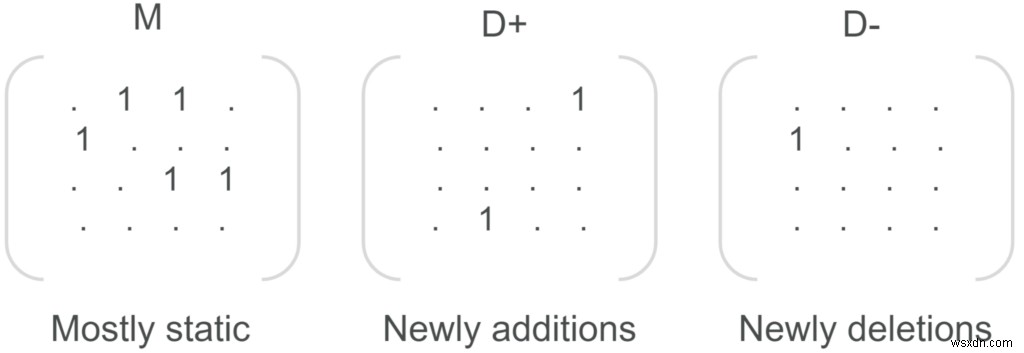
v2.8 से, नए नोड्स और रिलेशनशिप डालने में लगने वाला समय काफी कम हो गया है और यह ग्राफ के आकार पर निर्भर नहीं करता। यह अनुकूलन ग्राफ में हर मैट्रिक्स के लिए दो डेल्टा मैट्रिक्स पेश करके हासिल किया गया था: एक नोड जोड़ के लिए (D+) और एक नोड हटाने के लिए (D-)। नोड जोड़ और हटाने को उनके उपयुक्त डेल्टा मैट्रिक्स में दर्शाया जाता है, और एक बार जब डेल्टा मैट्रिक्स 10000 नोड्स की सीमा तक पहुंच जाता है (कॉन्फ़िगरेबल
DELTA_MAX_PENDING_CHANGESकॉन्फ़िगरेशन पैरामीटर के माध्यम से), तो इसे एक बल्क ऑपरेशन में मुख्य मैट्रिक्स के साथ सिंक्रनाइज़ किया जाता है, खाली किया जाता है, और वही चक्र फिर से शुरू हो सकता है।
नियंत्रणीय नोड निर्माण बफर
एक नया लोड-टाइम कॉन्फ़िगरेशन पैरामीटर, NODE_CREATION_BUFFER, भविष्य के नोड निर्माण के लिए मैट्रिक्स में आरक्षित मेमोरी की मात्रा को नियंत्रित करता है। उदाहरण के लिए, जब 16,384 पर सेट किया जाता है, तो मैट्रिक्स में निर्माण पर 16384 नोड्स के लिए अतिरिक्त जगह होगी। जब भी अतिरिक्त जगह समाप्त होती है, मैट्रिक्स का आकार 16384 से बढ़ जाएगा।
इस मान को कम करने से मेमोरी खपत कम होगी, लेकिन मैट्रिक्स रीअलोकेशन की बढ़ी हुई आवृत्ति के कारण प्रदर्शन में गिरावट आएगी। इसके विपरीत, इसे बढ़ाने से राइट-हेवी वर्कलोड के लिए प्रदर्शन में सुधार हो सकता है लेकिन मेमोरी खपत बढ़ जाएगी।
यदि पास किया गया तर्क 2 की घात नहीं था, तो मेमोरी अलाइनमेंट में सुधार के लिए इसे अगली-सबसे बड़ी 2 की घात तक राउंड किया जाएगा।
बेंचमार्क
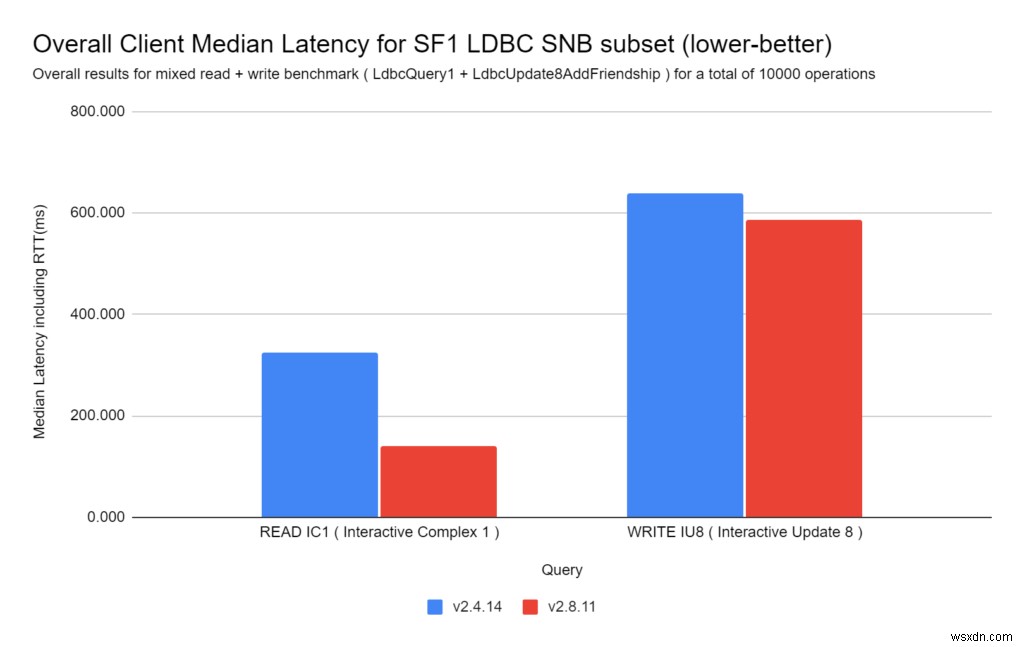
हमने डेल्टा मैट्रिक्स के अलावा कई अन्य प्रदर्शन संवर्द्धन भी जोड़े। हम नीचे LDBC SNB बेंचमार्क का उपयोग करके इन सुधारों को प्रदर्शित करते हैं।
LDBC SNB (लिंक्ड डेटा बेंचमार्क काउंसिल – सोशल नेटवर्क बेंचमार्क) ग्राफ डेटाबेस रियल-वर्ल्ड रीड और राइट वर्कलोड की तुलना के लिए उद्योग-मानक बेंचमार्क है।
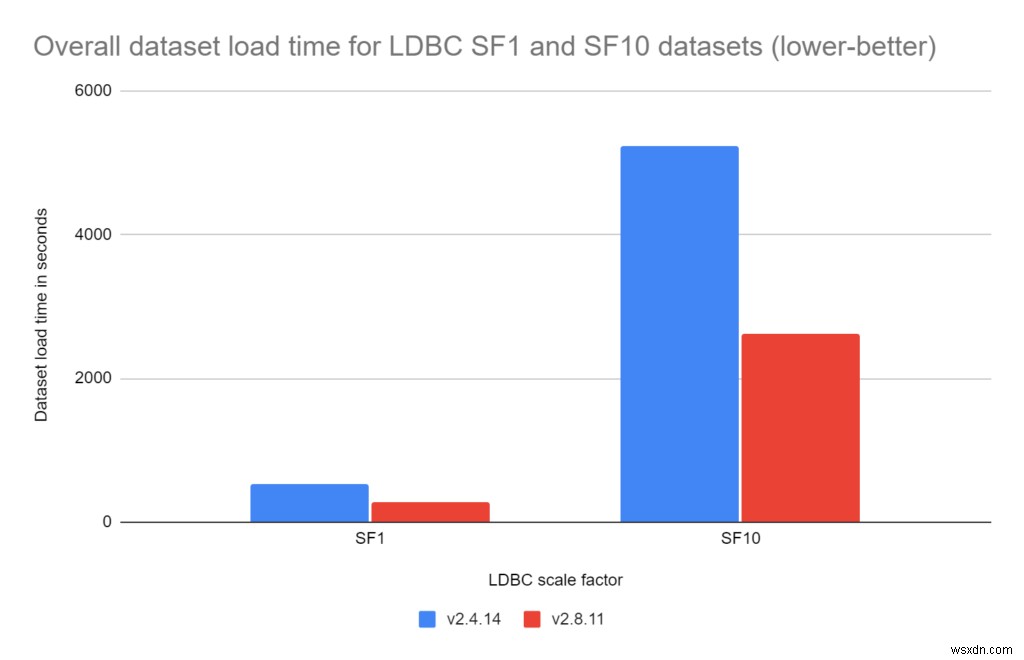
RedisGraph 2.8 में समग्र डेटा लोड बहुत तेज है:
- LDBC स्केल फैक्टर 1:
RedisGraph 2.8, RedisGraph 2.4 से 1.92 गुना तेज है - LDBC स्केल फैक्टर 10:
RedisGraph 2.8, RedisGraph 2.4 से 2.00 गुना तेज है
LDBC क्वेरी (रीड और राइट दोनों) RedisGraph 2.8 में बहुत तेजी से निष्पादित होती हैं:
- रीड क्वेरी:
RedisGraph 2.8, RedisGraph 2.4 से 2.32 गुना तेज है - राइट क्वेरी:
RedisGraph 2.8, RedisGraph 2.4 से 1.09 गुना तेज है
डेटा रिस्टोर और सिंक करना (RDB और AOF) भी बहुत तेज है (कुछ स्थितियों में कई क्रम के परिमाण तक तेज)।
RedisGraph Redis Stack का हिस्सा है
RedisGraph अब Redis Stack का हिस्सा है। आप macOS, Ubuntu, या Redhat के लिए नवीनतम Redis Stack सर्वर बाइनरी डाउनलोड कर सकते हैं, या Docker, Homebrew, या Linux के साथ इंस्टॉल कर सकते हैं।
RedisInsight का उपयोग करके RedisGraph का अनुभव लें
RedisInsight डेवलपर्स के लिए एक विजुअल टूल है जो Redis या Redis Stack का उपयोग करके विकास के दौरान RedisTimes से डेटा का पता लगाने का एक उत्कृष्ट तरीका प्रदान करता है।
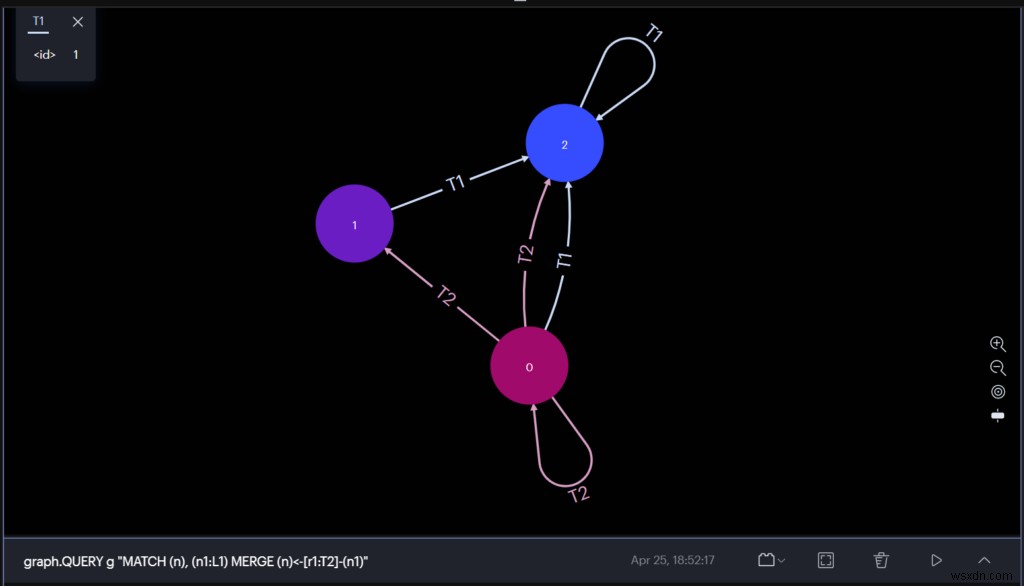
आप ग्राफिकल यूजर इंटरफेस से सीधे ग्राफ क्वेरी निष्पादित कर सकते हैं और परिणाम देख सकते हैं। RedisInsight अब RedisGraph क्वेरी परिणामों को विजुअलाइज़ कर सकता है।
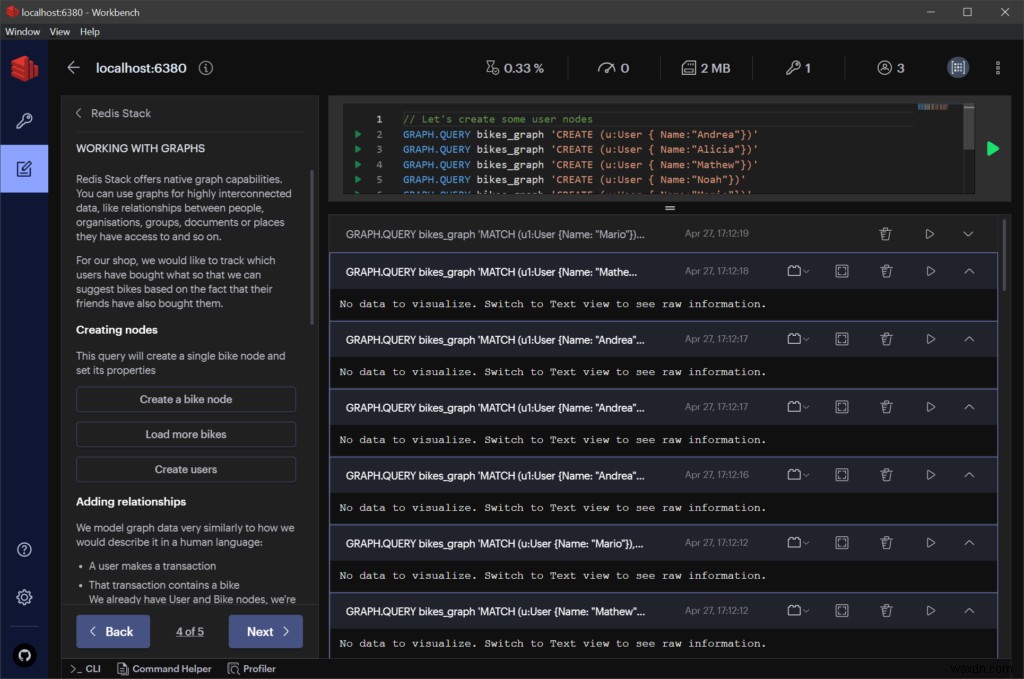
इसके अलावा, RedisInsight में RedisGraph को इंटरैक्टिव रूप से सीखने के लिए क्विक गाइड और ट्यूटोरियल शामिल हैं।
RedisGraph के बारे में अधिक जानें redis.io और developer.redis.com पर।